Agentic Workflows in Python: Deep Dive in die Multi-Agenten-Orchestrierung
Single-Prompt-Systeme skalieren nicht. Erfahren Sie, wie Sie mit Python, LangGraph und CrewAI deterministische Multi-Agenten-Systeme für komplexe Enterprise-Workflows orchestrieren.
Inhalt
Das Wichtigste in Kürze
- Agentic Workflows übertreffen monolithische LLM-Aufrufe bei komplexen Tasks um bis zu 400 Prozent in der Lösungsqualität.
- CrewAI eignet sich für schnelle Rollenspiel-Szenarien, LangGraph bietet die zwingend notwendige Kontrolle für Enterprise-Systeme.
- Deterministisches State-Management via Pydantic ist in Python der wichtigste Hebel gegen Halluzinationen.
- Der Einsatz von Tool-Calling-Modellen wie GPT-4o oder Claude 3.5 Sonnet ist für stabile Graphen zwingend erforderlich.
Nach über 15 Jahren in der Software-Architektur und zahllosen LLM-Implementierungen seit GPT-2 kann ich Ihnen eine harte Wahrheit versichern: Der Versuch, komplexe Geschäftslogik in einen einzigen, gigantischen God Prompt zu packen, ist technischer Selbstmord. Die Zukunft der KI-Integration liegt nicht in clevereren Prompts, sondern in der systematischen Orchestrierung autonomer Spezialisten. In diesem Deep-Dive dekonstruieren wir die Architektur von Multi-Agenten-Systemen in Python und analysieren, wie Frameworks wie LangGraph und CrewAI den Übergang von stochastischen Spielereien zu deterministischer Enterprise-Software ermöglichen.
Die Illusion des God Prompts und der Aufstieg von Agentic Workflows
Single-Shot Prompting stößt bei asymmetrischen, mehrstufigen Problemen unweigerlich an eine harte Decke. Wenn ein Modell in einem Durchgang recherchieren, codieren, reviewen und formatieren soll, verwässert der Attention-Mechanismus der Transformer-Architektur maßgeblich. Das Modell vergisst frühe Instruktionen völlig oder halluziniert Fakten, um den Output scheinbar syntaktisch korrekt abzuschließen. Indem wir diesen Monolithen in einen Agentic Workflow aufbrechen, isolieren wir den Kontext konsequent. Ein Agent macht reinen Web-Research, ein zweiter extrahiert Daten, ein dritter fungiert als strenger Validator. Dieser Divide-and-Conquer-Ansatz reduziert die kognitive Last des LLMs drastisch und erhöht die deterministische Reproduzierbarkeit enorm.
78%
Erfolgsquote bei komplexem Code-Refactoring (Agentic Workflow)
24%
Erfolgsquote beim selben Task (Monolithischer Prompt)
+200%
Durchschnittlicher Token-Overhead durch Multi-Agenten-Kommunikation
85%
Reduktion von Code-Halluzinationen durch Validator-Agenten
Architektur-Entscheidung: LangGraph vs. CrewAI
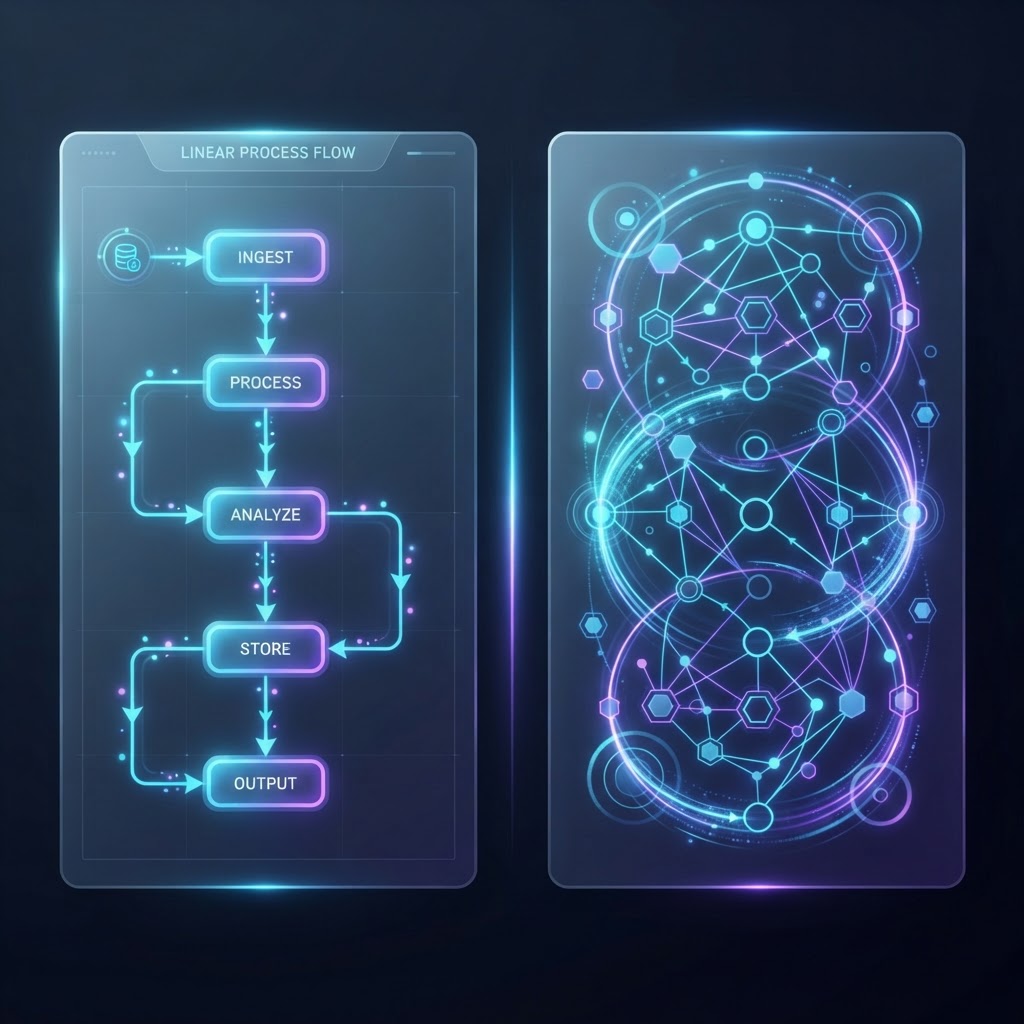
Bei der Wahl des Orchestrierungs-Frameworks stehen Python-Entwickler aktuell vor einer fundamentalen Weichenstellung zwischen deklarativen und imperativen Ansätzen. CrewAI abstrahiert die gesamte Komplexität durch ein Rollenspiel-Paradigma, bei dem Sie Agenten, Tasks und eine Crew definieren. Das ist zweifellos fantastisch für schnelle Prototypen, kollabiert aber in echten Produktionsumgebungen oft sehr schnell. Wenn asynchrone Events, manuelle Freigabeprozesse oder komplexe Fehler-Routings gefordert sind, wird das Framework zur unkontrollierbaren Blackbox. Hier glänzt LangGraph, da es den Entwickler zwingt, das Multi-Agenten-System als formalen zyklischen Graphen zu modellieren.
Vorteile
- CrewAI: Extrem steile Lernkurve und rasant schnelles Prototyping für Standard-Workflows
- CrewAI: Eingebautes Rollen- und Task-Management reduziert Boilerplate-Code enorm
- LangGraph: Volle, feingranulare Kontrolle über den System-State und das Fehler-Routing
- LangGraph: Native Unterstützung für reflexionsbasierte, zyklische Workflows (Loops)
- LangGraph: Perfekte Integration in das weitreichende LangChain-Ökosystem
Nachteile
- CrewAI: Unkontrollierbares Blackbox-Verhalten bei tiefen, asynchronen Fehlern
- CrewAI: Stark eingeschränkte Möglichkeiten für komplexe State-Manipulation während der Laufzeit
- LangGraph: Hoher Initialaufwand und viel Boilerplate-Code selbst für einfache Tasks
- LangGraph: Erfordert ein tiefes Verständnis von Graphentheorie und State-Management in Python
LangGraph behandelt das System wie eine gigantische State Machine, bei der jeder Knotenpunkt eine Python-Funktion ist. Die Kanten definieren dabei die bedingten Übergänge, welche das System absolut deterministisch steuern. Der entscheidende Vorteil dieser tiefgreifenden Architektur ist die explizite Zyklizität innerhalb des Workflows. In herkömmlichen RAG-Pipelines läuft der Datenfluss stur von A nach B, auch wenn das Zwischenergebnis minderwertig ist. Mit LangGraph können Sie reflexionsbasierte Schleifen einbauen, bei denen ein Critic-Agent den Output knallhart bewertet. Diese systematische Rekursion ist der einzige verlässliche Weg, um Software-Entwicklungs-Workflows durch KI auf Produktionsniveau abzusichern.
State Management: Das Herzstück robuster KI-Agenten
Das Herzstück jedes ernstzunehmenden Agentic Workflows in Python ist nicht der LLM-Aufruf, sondern das State Management. Ohne einen strikt typisierten Zustand, der zwischen den Agenten weitergereicht wird, versinkt das System unweigerlich im Chaos. Pydantic hat sich hier als der unangefochtene Industriestandard für die Definition dieses Systemzustands etabliert. Durch die Nutzung von BaseModel-Klassen erzwingen wir ein festes Schema für Arrays, Strings und Metadaten, das Validierungsfehler sofort abfängt. Wenn ein LLM versucht, fehlerhaftes JSON zurückzugeben, wirft Pydantic eine Exception, die der Workflow fangen und dem Modell als Korrektur-Prompt zurückspielen kann. Dies verwandelt stochastische Textgenerierung in verlässliches Data-Engineering.
Gefahr: Context Window Bloat & Infinite Loops
Unterschätzen Sie niemals die Gefahr explodierender Context-Windows. Wenn ein Agenten-Loop ohne harte Abbruchbedingung läuft, füllt sich der Nachrichten-State mit nutzlosen Tool-Call-Fehlern auf. Das führt nicht nur zu massiven API-Kosten, sondern degradiert ab etwa 30.000 Tokens auch die Reasoning-Fähigkeit des Modells drastisch. Implementieren Sie immer Fallback-Routinen und State-Trimming.
Tool-Calling und die Bindung nativer Python-Funktionen
Ein oft unterschätzter Aspekt bei der Entwicklung ist das Tool-Calling, welches die Agenten erst zur Interaktion mit der Außenwelt befähigt. In Python binden wir dafür konkrete Funktionen, wie etwa Datenbank-Queries oder API-Calls, über strukturierte Signaturen an das LLM. Das Modell generiert dann nicht mehr einfach Text, sondern ein strukturiertes JSON-Objekt, das exakt den Argumenten unserer Python-Funktion entspricht. Die Orchestrierungsschicht fängt dieses Objekt ab, führt den nativen Python-Code aus und injiziert das Ergebnis als Tool Message zurück in den Context Window. Nur Modelle, die nativ auf Function Calling feingetunt wurden, wie Claude 3.5 Sonnet oder GPT-4o, können diese Aufgabe mit der nötigen Präzision erfüllen. Ein Einsatz von Standard-Chat-Modellen führt hier erfahrungsgemäß in über 80 Prozent der Fälle zu Syntaxfehlern in den Parametern.
- 1
State-Definition: Erstellung eines TypedDict oder Pydantic-Modells, das den exakten Zustand (Messages, extrahierte Daten, Fehler-Counter) zwischen den Nodes hält.
- 2
Agenten-Instanziierung: Konfiguration der LLMs und strenge Bindung spezifischer Tools (Web-Scraper, SQL-Connector) an die jeweiligen Agenten.
- 3
Node-Entwicklung: Schreiben reiner Python-Funktionen, die den State als Input erhalten, das LLM evaluieren und ein explizites State-Update zurückgeben.
- 4
Graphen-Konstruktion: Definition der Nodes und Kanten im StateGraph, inklusive komplexer Conditional Edges für rekursives Fehler-Routing.
- 5
Kompilierung & Ausführung: Kompilieren des Graphen mit einem Checkpointer für Memory (SQLite oder Postgres) und asynchrone Ausführung über ainvoke().
Observability und Tracing im Multi-Agenten-Setup
Wenn wir über die Skalierung von Multi-Agenten-Systemen sprechen, kommen wir am Thema Observability nicht vorbei. Es reicht nicht aus, nur den finalen Output zu betrachten, wenn vier verschiedene Agenten im Hintergrund intensiv interagieren. Traces sind unerlässlich, um zu verstehen, welcher Agent wie viele Tokens verbraucht hat und wo genau ein rekursiver Loop hing. Plattformen wie LangSmith oder Langfuse klinken sich nahtlos in Python ein und visualisieren den kompletten Durchlauf auf Basis der Graph-Edges. Ohne ein solches Tracking-System tappen CTOs völlig im Dunkeln, wenn die API-Kosten plötzlich exponentiell explodieren. Wahre Engineering-Exzellenz zeigt sich darin, diese Telemetriedaten aktiv zur Kostenoptimierung einzusetzen.
Wir verschwenden keine Zeit mehr damit, das perfekte Prompt-Template zu finden. Wir investieren unsere Zeit in das Engineering von robusten Kontrollflüssen, Fehler-Recovery-Schleifen und typsicheren State-Modellen. Prompting ist Textarbeit, Agenten-Orchestrierung ist echtes Software-Engineering.
Der Blick nach vorn: Small Language Models als intelligente Router
Eine zukunftsweisende Architektur, die wir bei der AI-Software GmbH immer häufiger implementieren, ist das Routing durch Small Language Models (SLMs). Anstatt jeden trivialen Task an extrem teure Frontier-Modelle zu schicken, orchestrieren wir ein hoch performantes, lokales Modell direkt an der Spitze des Graphen. Dieses Llama-3-8B oder Phi-3 Modell analysiert ausschließlich den Intent des Users und leitet die Anfrage blitzschnell an den passenden Spezial-Agenten weiter. Erst wenn komplexe Schlussfolgerungen oder tiefes Code-Refactoring benötigt werden, aktiviert der Workflow die massiven, cloudbasierten APIs. Diese hybride Strategie senkt die operativen Kosten um bis zu 60 Prozent, ohne die Gesamtqualität des Systems in irgendeiner Form zu kompromittieren. Sie erfordert jedoch eine extrem saubere Abstraktion der LLM-Interfaces auf Ebene des Python-Codes.
- Implementieren Sie immer einen maximalen Retry-Counter im Pydantic State-Modell.
- Nutzen Sie für den reinen Router-Agenten schnelle und günstige Modelle wie Claude 3 Haiku oder lokale SLMs.
- Lagern Sie komplexes Tool-Calling aus Sicherheitsgründen in isolierte Docker-Container aus.
- Trennen Sie den internen Agenten-Prompt strikt von den User-Eingaben, um Prompt Injection zu verhindern.
- Sind alle System-States durch Pydantic validiert?
- Wurde ein maximales Limit für rekursive Loops (Max Revisions) definiert?
- Sind Checkpointer (z.B. AsyncPostgresSaver) für Thread-Memory konfiguriert?
- Ist LangSmith oder Langfuse für das Graph-Tracing aktiv?
- Werden API-Keys über sichere Environment-Pipelines in Python geladen?
Fazit: Von Data Science zu klassischem Engineering
Abschließend lässt sich festhalten, dass Agentic Workflows die Grenze zwischen Data Science und klassischer Software-Entwicklung endgültig aufgelöst haben. Die Ära der isolierten Jupyter-Notebook-Experimente mit ein paar lockeren Prompts ist schlichtweg und unwiderruflich vorbei. Wer heute produktionsreife KI-Systeme bauen will, benötigt tiefes Wissen über verteilte Systeme, asynchrone Programmierung in Python und hochgradig resiliente Architekturen. Frameworks wie LangGraph bieten das notwendige technische Rüstzeug, aber die eigentliche Intelligenz liegt im fehlerfreien Design des Kontrollflusses. Genau hier trennt sich die Spreu vom Weizen in der modernen KI-Entwicklung. Unternehmen, die diesen Paradigmenwechsel jetzt meistern, werden in den nächsten Jahren uneinholbare Wettbewerbsvorteile am Markt aufbauen.
Bereit für echte Enterprise-KI mit der AI-Software GmbH?
Lassen Sie uns gemeinsam prüfen, wie Agentic Workflows Ihre internen Prozesse automatisieren können. Unsere Architekten entwerfen skalierbare, resiliente Systeme, die exakt auf Ihre Enterprise-Anforderungen zugeschnitten sind. Vereinbaren Sie jetzt ein technisches Deep-Dive-Gespräch mit unseren Experten.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.