
Autonome Agenten: Die neue Ära der Softwareentwicklung
Ein architektonischer Deep Dive für Tech-Leads: Wie autonome Multi-Agenten-Systeme komplexe Codebases selbstständig warten, Features implementieren und DevOps-Pipelines transformieren.
Inhalt
Das Wichtigste in Kürze
- Vom Copiloten zum autonomen Engineer: Der Paradigmenwechsel verlagert sich von bloßer Code-Vervollständigung hin zu agentischen Workflows, die Repositories end-to-end analysieren und refaktorieren.
- Multi-Agenten-Orchestrierung ist der Schlüssel: Frameworks wie AutoGen und LangGraph lösen das Problem der Kontext-Verwässerung durch spezialisierte, interagierende KI-Personas (Coder, Tester, Architect).
- Security-First-Architekturen sind essenziell: Da autonome Agenten Werkzeuge und Shell-Umgebungen nutzen ('RCE by Design'), erfordern sie zwingend ephemere Container-Sandboxes und strenges RBAC.
Wir stehen an der Schwelle einer tektonischen Verschiebung in der Softwareentwicklung. Während die letzten zwei Jahre von reaktiven Copiloten dominiert wurden, die den Entwickler zeilenweise unterstützten, bricht nun die Ära der autonomen Agenten an. Als KI-Architekt bei der AI-Software GmbH habe ich in zahlreichen Großprojekten erlebt, wie der Sprung von generativen Modellen zu echten, handlungsfähigen Systemen die Regeln des Software Engineerings komplett neu schreibt. Dieser Artikel ist kein oberflächlicher Hype-Bericht, sondern ein harter technischer Deep Dive in die Mechanik, die Fallstricke und die Architektur von Agenten-Frameworks, die heute schon komplexe Repositories eigenständig warten.
Der Paradigmenwechsel: Vom Autocomplete zum autonomen System
Der traditionelle Ansatz der KI-gestützten Entwicklung basierte fast ausschließlich auf 'Next-Token-Prediction' im unmittelbaren Kontext des IDE-Cursors. Dieser Ansatz stößt jedoch bei echten Engineering-Aufgaben an harte Grenzen, da tiefgreifende Refactorings oder das Debugging über Dutzende von Microservices hinweg ein Verständnis der gesamten Systemarchitektur erfordern. Autonome Agenten lösen dieses Problem durch den Einsatz sogenannter 'Agentic Workflows', bei denen das Language Model (LLM) als zentrale Reasoning-Engine fungiert. Diese Engine nutzt iterative Feedbackschleifen (Planning, Execution, Reflection), um komplexe Problemlösungsstrategien in atomare, ausführbare Schritte zu zerlegen. Anstatt nur Code vorzuschlagen, öffnet ein Agent Dateien, liest Logs, schreibt Unit-Tests und korrigiert sich selbst, wenn ein Compiler-Fehler auftritt. Dieser Wandel bedeutet, dass wir nicht mehr nur Code generieren, sondern den gesamten Software-Lifecycle automatisieren.
Ein wesentlicher Enabler für diesen Durchbruch ist die massive Erweiterung der Kontextfenster moderner Modelle gepaart mit drastisch gesunkenen Inferenzkosten. Modelle wie Claude 3.5 Sonnet oder GPT-4o können mittlerweile bis zu 200.000 Token – was etwa der Codebasis eines mittleren Microservices entspricht – nahezu in Echtzeit und mit extremer Präzision verarbeiten. Doch roher Kontext allein reicht nicht aus; die wahre Magie entsteht erst durch die Anbindung an Tools via Function Calling. Der Agent erhält direkten Zugriff auf den Language Server Protocol (LSP) Daemon, das Git-CLI und die Testumgebung. Dadurch verschmilzt das semantische Weltwissen des LLMs mit den deterministischen Fakten der statischen Code-Analyse, was die Halluzinationsrate bei Architekturänderungen um Größenordnungen reduziert.
1.9%
SWE-bench Lösungsrate (Mitte 2023)
>31.4%
SWE-bench Lösungsrate (Ende 2024 via Agenten)
200k
Gängige Token-Kontextgröße moderner LLMs
-85%
Verfall der API-Kosten pro 1k Token (YoY)
Anatomie agentischer Architekturen: Ein Deep Dive
Die Grundlage fast aller heutigen Entwickler-Agenten bildet das ReAct-Pattern (Reasoning and Acting). Dabei formuliert das LLM zunächst einen Gedanken ('Der Test schlägt fehl, weil Variable X Null ist'), entscheidet sich dann für eine Aktion ('Ich nutze das Grep-Tool, um die Deklaration von X zu finden') und analysiert die anschließende Beobachtung ('X wird in util.py asynchron überschrieben'). Was in der Theorie elegant klingt, führt in der unstrukturierten Praxis oft zu katastrophalen Fehlern, wenn das Tooling nicht robust ist. Wenn beispielsweise die Ausgabe eines Bash-Commands den Kontext sprengt, verliert der Agent seinen 'Gedankenfaden' und beginnt planlos Code zu löschen. Daher integrieren wir bei der AI-Software GmbH zwingend semantische Zwischenschichten wie Vector-Datenbanken, die den Codebase-Kontext mittels Retrieval-Augmented Generation (RAG) filtern, bevor er in den Prompt des Agenten injiziert wird. Nur so lässt sich deterministisches Verhalten in stochastischen Systemen erzwingen.
Achtung: Die Gefahr der Halluzinations-Schleifen
Entwickler unterschätzen oft die Fragilität von LLM-Tool-Aufrufen. Eine der häufigsten Fehlerquellen in frühen Agenten-Systemen sind 'Infinite Error Loops', bei denen der Agent einen Syntaxfehler produziert, den Compiler-Fehler liest, denselben fehlerhaften Fix erneut pusht und in einer endlosen Schleife stecken bleibt. Zwingende Gegenmaßnahme: Einbau von Backtracking-Logiken und Hard-Limits für Iterationen.
Multi-Agenten-Orchestrierung: Teile und Herrsche
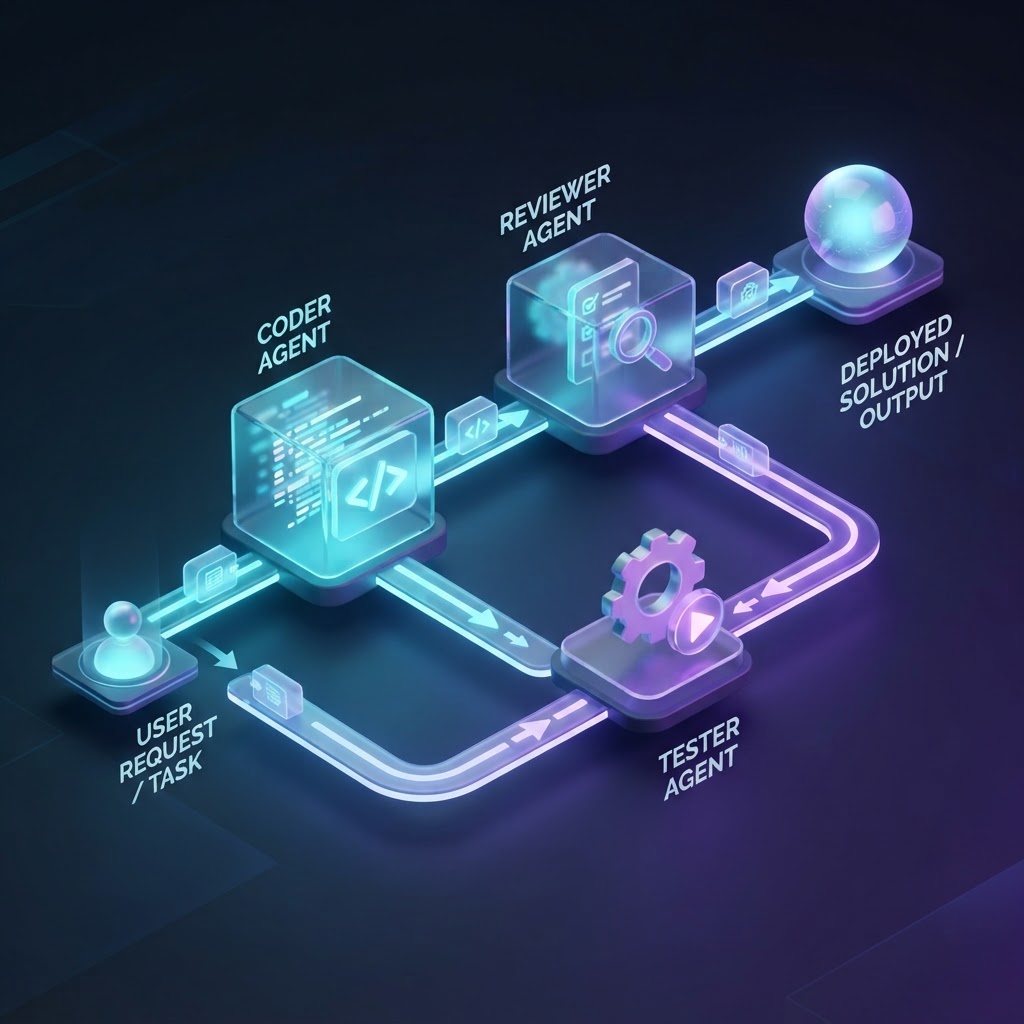
Um die kognitive Überlastung einzelner LLMs zu vermeiden, setzt die Industrie zunehmend auf Multi-Agenten-Systeme (MAS) unter Nutzung von Frameworks wie AutoGen, CrewAI oder LangGraph. Statt eines allwissenden 'Gott-Agenten' modellieren wir bei der AI-Software GmbH spezialisierte Personas. Der 'Software Architect Agent' hat den groben RAG-Überblick über das System und entwirft Schnittstellen, während der 'Senior Coder Agent' streng limitierten Kontext erhält und nur die Implementierung einer spezifischen Funktion übernimmt. Ein unabhängiger 'Reviewer Agent', der mit einem anderen System-Prompt (und oft einem anderen Basismodell) betrieben wird, evaluiert den generierten Code kritisch. Diese arbeitsteilige Struktur simuliert die Dynamik eines echten Engineering-Teams und reduziert die Fehlerquote drastisch, da sich die Agenten gegenseitig korrigieren und so Bestätigungsfehler (Confirmation Bias) des LLMs minimieren.
- 1
Code Graph Analyse: Der Architekt-Agent erstellt mithilfe von AST-Parsing einen Graphen der Abhängigkeiten, um den Impact der Änderung zu bewerten.
- 2
Test-Driven Design (TDD): Ein Test-Agent schreibt zunächst die fehlenden Unit-Tests basierend auf den Requirements, noch bevor Code geändert wird.
- 3
Inkrementelle Implementierung: Der Coder-Agent implementiert die Features iterativ. Nach jedem Schritt werden die lokal generierten Tests ausgeführt.
- 4
Review und Refinement: Der Reviewer-Agent prüft auf Memory-Leaks, Styleguide-Verstöße und Security-Anti-Patterns. Bei Kritik geht der Code zurück zum Coder.
- 5
CI-Pipeline Trigger: Erst wenn alle Tests grün sind und der Reviewer zustimmt, committet der Agent den Code und erstellt einen fertigen Pull Request.
Legacy Code & Wartung: Der wahre Lackmustest
Das Generieren eines neuen, grünen Greenfield-Projekts ist heutzutage trivial und beeindruckt niemanden mehr ernsthaft. Der wahre Lackmustest für autonome Agenten liegt in der Wartung und Modifikation von Legacy-Code, der über Jahre organisch und oft undokumentiert gewachsen ist. Hier glänzen fortschrittliche Agenten, indem sie nicht nur Text lesen, sondern durch Ausführung von Code tiefe Einblicke in den Runtime-State gewinnen. Wenn ein Framework-Update von Angular 14 auf 18 ansteht, kann ein Agent Breaking Changes aus der offiziellen Dokumentation extrahieren, sie auf den lokalen Code anwenden und durch iteratives Ausführen der Test-Suite die Anpassungen verifizieren. Dabei stößt die KI auf Abhängigkeitskonflikte, analysiert die `package.json`, sucht auf npm nach kompatiblen Versionen und aktualisiert den Dependency-Tree völlig selbstständig. Dies spart unzählige Stunden monotoner Entwickler-Arbeit.
Besonders herausfordernd ist dabei die Navigation in monolithischen Architekturen mit extrem hoher Kopplung. Wenn ein Agent eine zentrale Hilfsklasse anpasst, muss er die Ripple-Effekte im gesamten System antizipieren. Um dies zu meistern, rüsten wir bei der AI-Software GmbH unsere Agenten mit Tools zur statischen Code-Analyse aus, wie etwa SonarQube-Integrationen oder Tree-sitter. Der Agent liest nicht einfach nur Text, er navigiert semantisch durch den Abstract Syntax Tree (AST). Erkennt der Agent, dass eine Methodenänderung hundert andere Dateien bricht, entscheidet er sich autonom für eine Strategie der Abwärtskompatibilität, beispielsweise durch das temporäre Beibehalten der alten Methode mit einem `@Deprecated` Flag, während er parallel die Migration der Aufrufer orchestriert.
DevOps 3.0: CI/CD-Pipelines mit autonomen Systemen
Die Integration autonomer Agenten stoppt nicht an der IDE des Entwicklers; sie transformiert die gesamte DevOps-Pipeline radikal. In traditionellen CI/CD-Pipelines führen wir deterministische Skripte aus, die bei Fehlern einfach abbrechen und einen Menschen alarmieren. In einer agentischen Pipeline der Generation 3.0 fungiert die KI als aktiver Problemlöser im Hintergrund. Schlägt ein Build in der Pipeline fehl, weil eine Dependency fehlt, alarmiert das System nicht sofort den Entwickler. Stattdessen weckt der CI-Server einen Debugging-Agenten auf. Dieser Agent analysiert den Stacktrace, identifiziert den Fehler, erstellt lokal einen Hotfix-Branch, testet die Korrektur und pusht sie automatisch als neuen Commit in den bestehenden Pull Request. Erst wenn der Agent nach mehreren Versuchen scheitert, eskaliert er das Problem an einen menschlichen Engineer. Das ist keine Zukunftsmusik, sondern wird in modernen Tech-Unternehmen bereits produktiv eingesetzt.
Der Übergang zu agentischem DevOps bedeutet, dass unsere CI/CD-Pipelines aufhören, dumme Alarmanlagen zu sein. Sie werden stattdessen zu eigenständigen Mechanikern, die den Motor reparieren, während das Auto noch fährt.
Vorteile
- Drastische Reduktion der Time-to-Merge bei Pull Requests durch autonome Fehlerbehebung.
- Skalierbare Code-Reviews rund um die Uhr ohne Flaschenhals durch menschliche Senior-Entwickler.
- Automatisiertes, konsistentes Update-Management von Legacy-Dependencies.
Nachteile
- Hohe Komplexität in der Absicherung der Ausführungsumgebung (Security & Governance).
- Signifikanter Anstieg der Cloud- und API-Kosten bei suboptimal konfigurierten Agentenschleifen.
- Potenzieller Verlust von systemischem Architektur-Wissen im menschlichen Entwicklerteam.
Die 'Hidden Sandbox': Security und Blast Radius
Mit großer Autonomie kommt ein enormes Sicherheitsrisiko. Man muss die Architektur eines autonomen Software-Agenten schonungslos betrachten: Im Kern gewähren wir einem stochastischen Machine-Learning-Modell Remote Code Execution (RCE) Rechte in unserer Infrastruktur. Wenn ein LLM durch einen Prompt Injection Angriff in einem externen Issue-Ticket kompromittiert wird, könnte der Agent unbemerkt Backdoors in den Code schleusen oder Secrets exfiltrieren. Deshalb implementieren wir bei der AI-Software GmbH ein strenges 'Defense in Depth'-Konzept. Agenten arbeiten niemals direkt auf den produktiven Repositories oder in Netzwerken mit Zugriff auf sensible Daten. Stattdessen operieren sie in stark reglementierten, ephemeren Docker-Containern. Diese Umgebungen sind durch Kernel-Level Sandboxing, wie beispielsweise gVisor, vom Host-System isoliert und haben keine Outbound-Internet-Rechte, außer zu explizit gewhitelisteten Paket-Managern und der LLM-API.
- Ephemere Workspaces: Jeder Agent-Task startet in einer komplett frischen, zustandslosen Micro-VM, die nach Abschluss vernichtet wird.
- Strict Role-Based Access Control (RBAC): Agenten erhalten Git-Tokens mit minimalsten Privilegien. Sie dürfen Branches erstellen, aber niemals in Main mergen.
- Human-in-the-Loop-Gates: Für kritische Aktionen wie Infrastruktur-Änderungen erzwingt die Pipeline einen kryptografisch signierten Freigabe-Klick eines Menschen.
- Semantische Audit-Logs: Jeder vom Agenten ausgeführte Shell-Befehl und API-Call wird revisionsoffen und manipulationssicher protokolliert.
Strategische Prognose: Die Roadmap bis 2027
Wir stehen erst am Anfang der S-Kurve dieser Technologie. Bis 2027 prognostizieren wir bei der AI-Software GmbH eine Entwicklung weg von eng fokussierten 'Coding-Agenten' hin zu generalisierten System-Integratoren. Zukünftige Agenten werden nicht nur Repositories warten, sondern auf Basis vager Business-Metriken selbstständig Microservices provisionieren, A/B-Tests aufsetzen und die Cloud-Architektur dynamisch nach Kosteneffizienz restrukturieren. Für CTOs und Tech-Leads bedeutet dies, dass die Vorbereitungen auf diese Ära genau jetzt beginnen müssen. Codebases, die heute stark gekoppelt, schlecht getestet und undokumentiert sind, werden für autonome Systeme unlesbar sein. Der Fokus menschlicher Entwickler wird sich massiv verschieben: Weg vom manuellen Schreiben von Boilerplate-Code, hin zur präzisen Spezifikation von Systemanforderungen, dem Entwurf von Datenflüssen und der philosophischen Orchestrierung der KI-Workforce.
- Vollständige Abdeckung der Core-Business-Logik durch deterministische Unit-Tests als Leitplanken für Agenten.
- Etablierung robuster Vector-Datenbanken für unternehmensinternes RAG-Knowledge (Architektur-Entscheidungen, Guidelines).
- Migration auf strikte, modulare API-First-Architekturen, um den 'Blast Radius' fehlerhafter KI-Operationen zu begrenzen.
- Schulung von Lead-Developern in 'Prompt Systems Engineering' und der Orchestrierung von Multi-Agenten-Frameworks.
Integrieren Sie Agentic Workflows mit der AI-Software GmbH
Bereit für den nächsten Schritt im Software Engineering? Die AI-Software GmbH unterstützt Sie dabei, autonome Multi-Agenten-Systeme sicher und effizient in Ihre bestehende Architektur und CI/CD-Pipelines zu integrieren. Vereinbaren Sie jetzt ein unverbindliches Architektur-Assessment mit unseren Tech-Leads.
Projekt startenDouble-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.