Echtzeit-Übersetzung in globalen Meetings: Architektur, Latenz und KI-Strategien für CTOs
Wie moderne End-to-End KI-Sprachmodelle die 300-Millisekunden-Latenzgrenze knacken und nahtlose mehrsprachige Videokonferenzen in globalen Unternehmen ermöglichen.
Inhalt
Das Wichtigste in Kürze
- Die 300-ms-Grenze ist geschäftskritisch: Überschreitet die Latenz diesen Wert, bricht der natürliche Gesprächsfluss in Videokonferenzen messbar zusammen.
- End-to-End-Modelle (S2ST) ersetzen Kaskadensysteme und eliminieren den verlustbehafteten Text-Flaschenhals komplett.
- Edge-KI revolutioniert den Datenschutz: Hochkomprimierte INT8-Modelle auf lokalen NPUs verhindern das Abfließen unverschlüsselter Audio-Daten.
- Ohne Audio-RAG bleibt KI generisch: Unternehmensspezifische Fachbegriffe und Akronyme erfordern eine dynamische Prompt-Injection zur Laufzeit.
Sprachbarrieren in der globalen Wirtschaft gehören der Vergangenheit an – zumindest auf dem Papier. In der Praxis scheitern viele Unternehmen krachend an der technischen Realität verzögerter Audio-Streams, halluzinierter Fachbegriffe und architektonischer Flaschenhälse. Als KI-Architekten haben wir bei der AI-Software GmbH Dutzende Systeme evaluiert und implementiert. Die Wahrheit ist: Eine Übersetzung, die nur linguistisch korrekt ist, aber das Timing eines Meetings zerstört, stiftet keinen Mehrwert. Der Schlüssel liegt in der perfekten Orchestrierung von Streaming-Inferenz, lokaler Hardware und semantischem Kontext in unter 300 Millisekunden.
Die technologische Evolution: Vom Kaskadensystem zum End-to-End-Paradigma
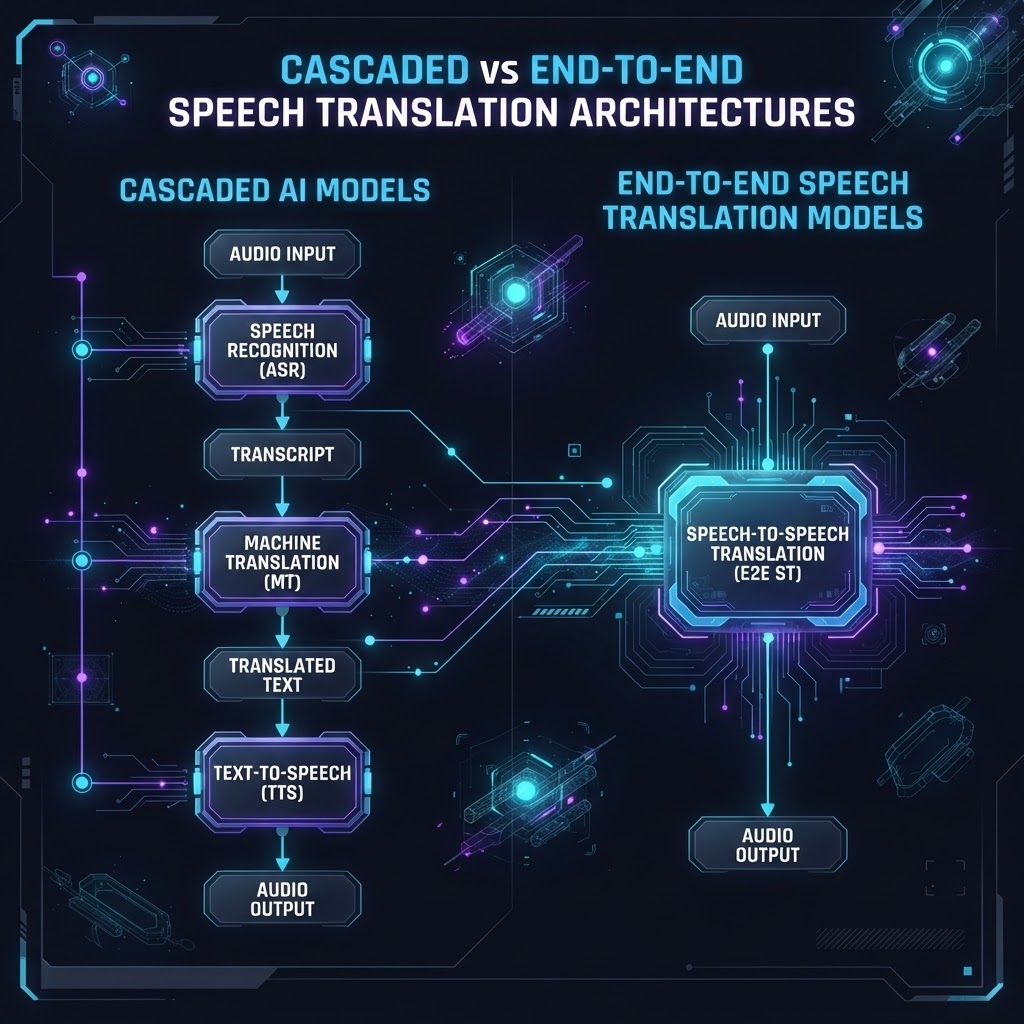
Die traditionelle Architektur der Echtzeit-Übersetzung gleicht einem fehleranfälligen Staffellauf. Ein kontinuierlicher Audio-Stream wird durch ein Speech-to-Text (STT) Modell wie frühe Whisper-Versionen transkribiert, der resultierende Text via Machine Translation (MT) übersetzt und schließlich durch ein Text-to-Speech (TTS) System synthetisiert. Jede dieser isolierten Kaskaden addiert signifikante Latenzzeiten und multipliziert die Fehlerwahrscheinlichkeit exponentiell. Verschluckt das initiale STT-Modell aufgrund von Hintergrundgeräuschen nur ein einziges kritisches Wort, kollabiert die gesamte Bedeutungskette der folgenden Übersetzungsschritte unweigerlich. Für geschäftskritische Enterprise-Meetings, in denen semantische Nuancen über Millionenverträge entscheiden, war dieser sequenzielle Ansatz schlichtweg nicht praxistauglich.
Das technische Paradigma hat sich mit dem Durchbruch von echten End-to-End (E2E) Speech-to-Speech Translation (S2ST) Modellen fundamental verschoben. Systeme wie Metas SeamlessM4T oder die nativen Audio-Ein- und Ausgabefähigkeiten von multimodalen Modellen der GPT-4o-Klasse eliminieren den textuellen Flaschenhals komplett. Sie mappen akustische Merkmale der Quellsprache direkt in einen hochdimensionalen latenten semantischen Raum und generieren daraus unmittelbar die akustischen Token der Zielsprache. Dieser architektonische Quantensprung reduziert nicht nur den massiven Rechen-Overhead, sondern bewahrt auch essenzielle prosodische Merkmale wie Betonung, Sprechtempo, Sarkasmus oder Zögern, die in einer reinen Textübersetzung unweigerlich verloren gehen und zu gefährlichen Missverständnissen führen können.
Latenz als der ultimative Benchmark: Die harte 300-Millisekunden-Grenze
In der menschlichen Kommunikation liegt die kritische physikalische und psychologische Schwelle für einen natürlichen Gesprächsfluss laut ITU-Standards bei exakt 300 Millisekunden. Überschreitet die End-to-End-Latenz eines Übersetzungssystems diesen Wert, kommt es zwangsläufig zu kognitiver Dissonanz, unbeabsichtigten Unterbrechungen (sogenannten Turn-Taking-Kollisionen) und einer messbaren Ermüdung der Teilnehmer. Moderne KI-Architekturen bekämpfen diese Verzögerung durch radikales Streaming-Inference-Design und prädiktive Token-Generierung. Wir sprechen hier nicht von theoretischen Laborwerten unter perfekten Netzwerkbedingungen, sondern von harten SLAs, die wir bei der Systemintegration in hochgradig asynchronen, global verteilten Unternehmensnetzwerken architektonisch garantieren müssen.
Die größte algorithmische Herausforderung ist hierbei die Definition der sogenannten Wait-k-Policy, insbesondere bei syntaktisch divergenten Sprachpaaren wie Deutsch und Englisch. Da im Deutschen das Prädikat häufig am Ende eines Nebensatzes steht (SOV-Struktur), muss das Übersetzungsmodell entweder eine extrem ressourcenintensive stochastische Vorhersage treffen oder warten, bis der Sinnzusammenhang durch den Sprecher komplettiert ist. Führende Architekturen auf Enterprise-Level lösen dieses Problem durch spekulative Dekodierung in Kombination mit dynamischem Chunking. Dabei wird das ankommende Audio-Signal nicht in starren Zeitintervallen zerteilt, sondern basierend auf phonetischen, prosodischen und semantischen Grenzen durch hochpräzise Voice Activity Detection (VAD) intelligent segmentiert.
< 300 ms
Kritische Latenzgrenze für natürlichen Dialogfluss
40 %
Geringerer Compute-Overhead bei E2E-Modellen
99,5 %
VAD-Präzision in lauten Enterprise-Umgebungen
Insider-Warnung: Die Over-Chunking-Falle
Vorsicht bei aggressivem Audio-Chunking: Wird das Intervall zu kurz gewählt (unter 150ms), neigen auch modernste Modelle zu schwerwiegenden Halluzinationen, da der semantische Kontext für eine präzise Übertragung nicht ausreicht. Dieses Over-Chunking ist der häufigste Fehler bei hastig implementierten Inhouse-Prototypen.
Edge-Computing vs. Cloud-Infrastruktur im strikten Enterprise-Einsatz
Die fundamentale Entscheidung zwischen einer zentralen Cloud-Infrastruktur und der lokalen On-Device-Verarbeitung (Edge-KI) ist weit mehr als eine simple TCO-Berechnung – sie bildet das architektonische Rückgrat der gesamten Data-Governance-Strategie eines Unternehmens. Hochskalierende Cloud-Lösungen bieten zwar den enormen Vorteil, massiv-parametrisierte Foundation Models mit über 100 Milliarden Parametern nutzen zu können, erkaufen sich diese Präzision jedoch mit unvermeidbarer Netzwerklatenz, Jitter-Anfälligkeit und potenziell gravierenden Compliance-Risiken. Wenn unverschlüsselte Audio-Streams von streng vertraulichen M&A-Gesprächen über den öffentlichen Äther an Drittanbieter-APIs fließen, ist das für regulierte Branchen wie Finance, Healthcare oder Automotive ein absolutes, unverhandelbares Ausschlusskriterium.
Genau aus diesem Grund beobachten wir bei der AI-Software GmbH eine massive architektonische Verschiebung in Richtung lokaler Edge-KI-Verarbeitung. Möglich wird dies durch dedizierte Hardware-Beschleunigung via Neural Processing Units (NPUs) direkt in den Laptops und Endgeräten der Nutzer. Durch extrem aggressive Modellkomprimierungstechniken wie Parameter-Quantisierung auf INT8- oder gar INT4-Präzision sowie fortgeschrittene Knowledge Distillation lassen sich mittlerweile hochpotente S2ST-Modelle lokal in Echtzeit ausführen. Dies reduziert die netzwerkbedingte Latenz auf absolute null Millisekunden und garantiert eine lupenreine Privacy-by-Design-Architektur, bei der das kritische Audiosignal das physische Gerät des Vorstands niemals verlässt.
Vorteile
- Cloud: Höchste Übersetzungsqualität durch massive Modellgrößen.
- Cloud: Zentrale und nahtlose Updates von Glossaren und Modellen.
- Edge: Zero-Network-Latency ermöglicht echtes Echtzeit-Gefühl.
- Edge: 100%ige Data Governance, da kein Audio das Gerät verlässt.
Nachteile
- Cloud: Starke Abhängigkeit von stabiler Internetbandbreite und Jitter.
- Cloud: Hohe Compliance-Risiken bei Übertragung sensibler Audio-Daten.
- Edge: Hohe Anforderungen an die NPU-Leistung der Client-Hardware.
- Edge: Schwierigere Verteilung von Unternehmens-Glossaren in Echtzeit.
Kontextverständnis und Audio-RAG für unternehmensspezifische Terminologie
Physikalische Latenzminimierung und eine sichere Edge-Architektur sind vollkommen wertlos, wenn die semantische Präzision auf der Strecke bleibt. Off-the-Shelf Standardmodelle, egal wie viele Milliarden Parameter sie besitzen, scheitern systematisch und reproduzierbar an unternehmensspezifischer Terminologie, internen Projekt-Akronymen oder tiefgreifendem technischen Fachjargon. Ein Algorithmus, der in einem globalen Board-Meeting den Begriff EBITDA-Marge oder streng geheime proprietäre Codenamen in Echtzeit wörtlich, aber sinnbefreit übersetzt, zerstört das Vertrauen der Nutzer innerhalb von Sekunden. Das herkömmliche statische Fine-Tuning von Foundation Models ist für dieses dynamische Problem jedoch oft zu teuer, im Deployment zu langsam und datenschutzrechtlich hochgradig riskant.
Die weitaus elegantere und skalierbarere Lösung, die wir bei anspruchsvollen Kundenprojekten favorisieren, ist Audio-Retrieval-Augmented Generation (Audio-RAG) gekoppelt mit dynamischer Prompt-Injection. In diesem komplexen, aber hochgradig effektiven Setup wird das Echtzeit-Audio noch während der Chunk-Verarbeitung durch einen extrem schlanken und schnellen Vektor-Suchlauf gegen ein angebundenes Glossar-Backend des Unternehmens abgeglichen. Die so identifizierte Terminologie wird dem eigentlichen Inferenz-Modell als strenger Constraint via Forced Decoding übergeben. Das Resultat ist eine chirurgisch präzise Übersetzung, die den genauen strategischen Kontext des spezifischen Meetings kennt und lückenlos anwendet – eine Kerntechnologie, die den gravierenden Unterschied zwischen einer netten Spielerei und einem einsatzkritischen Enterprise-Tool definiert.
Eine KI-gestützte Echtzeit-Übersetzung, die Latenz rigoros priorisiert, aber den spezifischen semantischen Kontext eines millionenschweren Deals durch generische Modelle ignoriert, ist kein innovatives Feature – sie ist ein unkalkulierbares Geschäftsrisiko.
Der Implementierungs-Blueprint: So integrieren CTOs Echtzeit-Translation
Die tiefe Integration dieser hochkomplexen End-to-End-Modelle in bestehende Enterprise-Collaboration-Tools wie Microsoft Teams, Zoom oder proprietäre Custom-Lösungen erfordert präzise Eingriffe auf der untersten Netzwerk-Protokollebene. Wir bei der AI-Software GmbH arbeiten hier primär direkt mit den WebRTC-Audio-Streams, die über sichere, hochperformante und bidirektionale WebSockets an die dedizierten Inferenz-Cluster oder die lokale Edge-Engine geroutet werden. Ein absolut erfolgskritischer architektonischer Aspekt ist hierbei das Audio-Mixing und die Hardware-gestützte akustische Echokompensation (Acoustic Echo Cancellation, AEC). Wenn das KI-Modell versehentlich sein eigenes, frisch übersetztes Audio-Echo als neuen Input-Stream interpretiert, entsteht unweigerlich eine fatale Feedback-Schleife, die das Modell in Halluzinationen treibt und das gesamte Meeting sofort technisch lahmlegt.
- 1
Infrastruktur-Audit: Messung der durchschnittlichen Netzwerk-Jitter, Bandbreiten und NPU-Fähigkeiten der Mitarbeiter-Hardware.
- 2
Modell-Selektion: Strategische Entscheidung zwischen Cloud-APIs (hohe Genauigkeit) und Edge-Deployments (maximale Sicherheit).
- 3
Glossar-Integration: Aufbau einer Vektor-Datenbank für das Audio-RAG-System zur Injektion von Firmen-Terminologie in Echtzeit.
- 4
Protokoll-Anbindung: Tiefenintegration in den WebRTC-Layer des Konferenz-Tools inklusive strikter Trennung der Audio-Kanäle zur Echo-Vermeidung.
- 5
Stufenweiser Rollout: Initialer Pilot in internen, unkritischen Meetings zur Feinjustierung der Wait-k-Policy und Chunking-Intervalle vor dem C-Level-Einsatz.
- Die End-to-End-Latenz (Audio In zu Audio Out) liegt nachweisbar unter 300 Millisekunden.
- Voice Activity Detection (VAD) ist auf laute Büro- und Hintergrundgeräusche robust trainiert.
- Acoustic Echo Cancellation (AEC) ist hartverdrahtet aktiviert, um Modell-Loops zu verhindern.
- Dynamisches Audio-RAG übersetzt mindestens 95% der internen Akronyme fehlerfrei.
Prognose 2025+: Die Multimodale Revolution des Affective Computing
Blicken wir aus der Architektenperspektive auf die technologische Roadmap der nächsten 12 bis 36 Monate, wird sich der Entwicklungsfokus von der reinen linguistischen und zeitlichen Korrektheit hin zu einer vollwertigen emotionalen Intelligenz der KI-Systeme verschieben. Multimodale Architekturen der übernächsten Generation werden nicht mehr nur isoliert das Audiosignal verarbeiten. Sie werden simultan die visuelle Mimik, Mikro-Expressionen und Gestik aus dem parallelen Video-Feed extrahieren, um nonverbale Kontexte wie Sarkasmus, geschäftliche Dringlichkeit oder subtile Zweifel hochpräzise zu erfassen und direkt in die prosodische Sprachsynthese der Zielsprache zu spiegeln. Wir an der Spitze der AI-Software GmbH bereiten die Infrastrukturen unserer Enterprise-Klienten bereits heute konsequent auf diese kommende Affective-Computing-Revolution vor, indem wir die Latenzbudgets und Schnittstellen für zukünftige Video-Eingabeströme architektonisch vordenken.
Bereit für barrierefreie globale Kommunikation?
Latenzprobleme, Halluzinationen oder Datenschutzbedenken bei Ihren aktuellen Übersetzungs-Workflows? Die AI-Software GmbH analysiert Ihre Infrastruktur und entwickelt hochgradig maßgeschneiderte, sichere Echtzeit-Modelle für Ihr Enterprise-Umfeld. Buchen Sie jetzt einen Architektur-Audit mit unseren Experten.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.