
Emotionale KI im Kundenservice: Wie Voice-Bots Kundenwut deeskalieren (Deep Dive)
Von simpler Spracherkennung zur echten Empathie-Simulation: Wie moderne Voice-Bots akustische Stressmuster in Echtzeit dekodieren und Eskalationen im Kundenservice messbar verhindern.
Inhalt
Das Wichtigste in Kürze
- Echtzeit-Emotionserkennung erfordert zwingend eine duale Architektur aus akustischer Prosodie-Auswertung und lexikalischem NLP.
- Systemlatenzen über 400 Millisekunden zerstören die Deeskalations-Illusion und machen den Einsatz von Emotion AI kontraproduktiv.
- Der größte Fallstrick in der Praxis ist der 'Data Mismatch' zwischen sauberen Trainingsdaten und realem, verrauschtem Contact-Center-Audio.
- Erfolgreiche Deployments senken die Notwendigkeit menschlicher Eskalations-Agenten um bis zu 34 Prozent.
Die Ära der frustrierenden und starren Telefon-Menüs ist vorbei. Während herkömmliche Sprachassistenten lediglich transkribieren, WAS Kunden sagen, revolutioniert Emotion AI den Kundenservice, indem sie entschlüsselt, WIE etwas gesagt wird. Für CTOs und Innovationsmanager bedeutet dies den Übergang von passiven Anrufbeantwortern zu kognitiven Agenten, die Frustration in Millisekunden antizipieren und hochgradig adaptiv deeskalieren.
Die Evolution der Spracherkennung: Von ASR zu Affective Computing
Historisch betrachtet scheiterten Voice-Bots im Kundenservice vor allem an fehlendem Kontext. Ein simples Automatic Speech Recognition (ASR) Modell transkribiert den Satz 'Das ist ja großartig' unabhängig davon, ob er vor Freude strahlend oder vor Sarkasmus triefend gesprochen wurde. Die Einbettung von Affective Computing, also der maschinellen Erfassung und Simulation von Affekten, schließt diese semantische Lücke. Als Architekt solcher Systeme weiß ich: Die eigentliche Magie passiert an der Schnittstelle, an der wir moderne LLMs (Large Language Models) zwingen, den rohen Text mit den reichhaltigen Metadaten der Audiosignale zu korrelieren. Das Ergebnis ist ein holistischer Voice-Bot, der den feinen Subtext der menschlichen Stimme nicht nur auswertet, sondern sein eigenes Verhalten in Echtzeit darauf abstimmt.
23.6%
Voice AI Market CAGR (bis 2028)
34%
Weniger Human Handover bei Emotion AI
87%
Labor-Genauigkeit bei Emotions-Klassifizierung
Unter der Haube: Wie Voice-Bots Akustik und Linguistik dekodieren
Die Dekodierung menschlicher Emotionen in Echtzeit basiert architektonisch zwingend auf einer dualen Pipeline. Auf der einen Seite nutzen wir akustische Prosodie-Auswertung. Hierbei extrahieren Akustik-Modelle Metriken wie Mel-Frequency Cepstral Coefficients (MFCCs), Jitter (Mikro-Frequenzschwankungen) und Shimmer (Mikro-Amplitudenschwankungen). Ein wütender Kunde hat in der Regel eine messbar erhöhte Sprechgeschwindigkeit, einen drastisch ansteigenden Grundton (Pitch) und abrupte Sprechpausen. Wir schicken diese Audio-Features durch hochspezialisierte Transformer-Architekturen wie wav2vec 2.0. Parallel dazu läuft auf der zweiten Schiene das lexikalische Sentiment. Modelle wie RoBERTa parsen das Transkript auf semantische Wut-Indikatoren, Fluchwörter oder ungeduldige Satzstrukturen. Erst die vektorielle Zusammenführung dieser beiden Informationsströme macht den Stresspegel des Anrufers mathematisch belastbar greifbar.
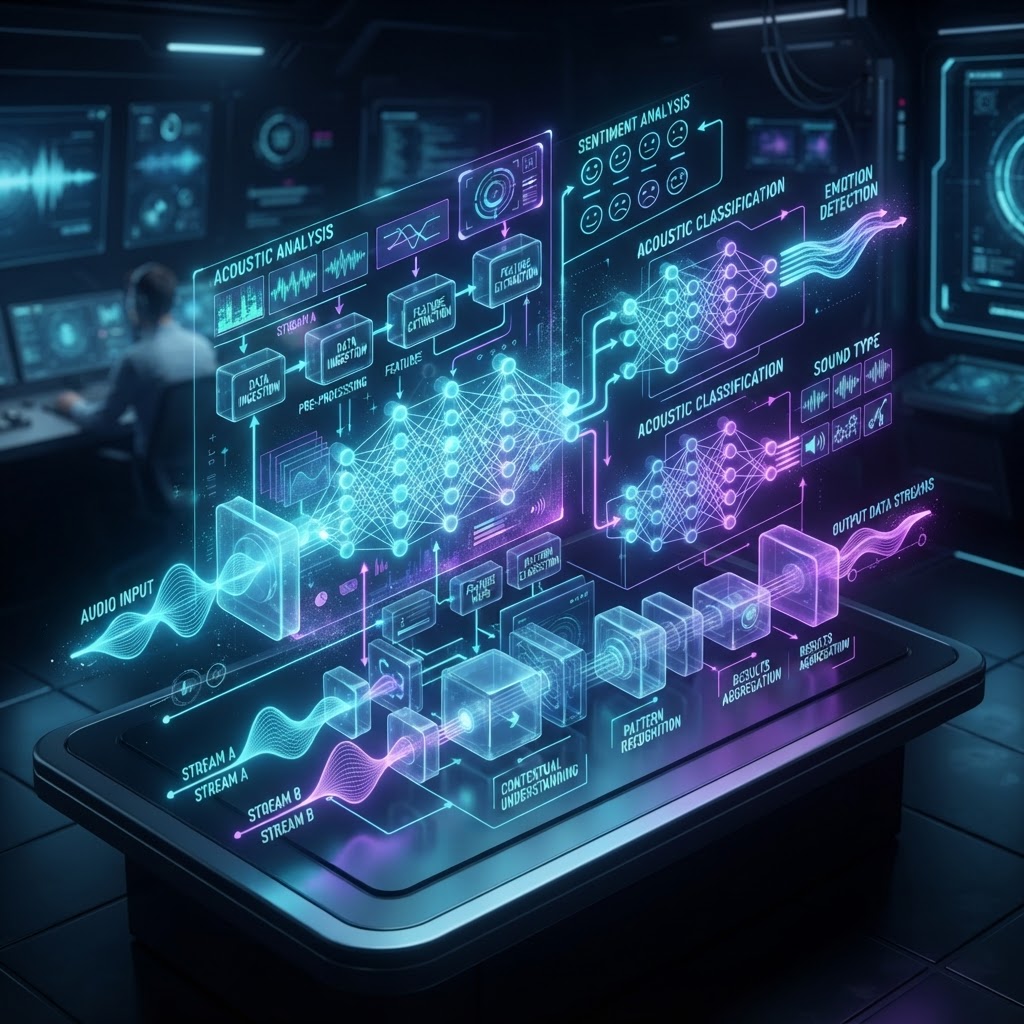
Architektur-Tipp: Late Fusion vs. Early Fusion
Insider-Wissen zur Modell-Fusion: Entscheiden Sie sich in der Architekturplanung immer für 'Late Fusion'. Dabei werden Audio-Features und Text-Sentiment getrennt klassifiziert und erst am Ende gewichtet zusammengeführt. Das macht das System robuster gegen Fehler in der reinen Spracherkennung (ASR), die bei starkem Rauschen fast unvermeidlich sind.
Der Deeskalations-Algorithmus: Wenn die Maschine eingreift
Was nützt die exakteste Analyse, wenn das System nicht angemessen reagiert? Wenn der berechnete Frustrations-Vektor einen festgelegten Schwellenwert überschreitet, initiiert die Policy-Engine des Voice-Bots einen dynamischen System-Context-Switch. Der Bot stoppt den regulären Service-Flow und wechselt in ein Deeskalations-Verhalten. Technisch bedeutet das einen harten Eingriff in die Text-to-Speech (TTS) Generierung über SSML (Speech Synthesis Markup Language). Die Sprechgeschwindigkeit wird über das Attribut rate='slow' gedrosselt, der Pitch wird gesenkt und das NLU-Backend angewiesen, Sätze mit empathischen Validierungen wie 'Ich höre Ihren Ärger, lassen Sie uns das gemeinsam lösen' zu beginnen. Wird der Schwellenwert für extreme Eskalation überschritten, triggern wir einen sofortigen SIP-Transfer zum menschlichen Agenten – mitsamt Übergabe des berechneten Emotion-Scores, um den Mitarbeiter bestmöglich vorzuwarnen.
- 1
Audio Ingestion: Der SIP-Stream des Anrufs wird gesplittet und via WebSockets an das Inference-Backend gestreamt.
- 2
Feature Extraction: MFCCs und Tonhöhe werden in Millisekunden aus dem Audiostream extrahiert, parallel erfolgt die ASR-Transkription.
- 3
Dual Classification: Akustik-Modell und NLU-Sentiment vergeben Scores zwischen -1 (Wut) und +1 (Freude).
- 4
Policy Engine Trigger: Bei einem Score von unter -0.6 aktiviert das System den Deeskalations-Prompt im LLM.
- 5
Dynamic SSML Generation: Die Audio-Antwort wird mit beruhigenden SSML-Parametern gerendert und asynchron an den Anrufer zurückgeschickt.
Praxisfallen: Warum 80% der Emotion AI-Projekte im Labor steckenbleiben
Die AI-Software GmbH wird oft gerufen, wenn initiale Voice-Projekte unserer Klienten an der rauen Realität der echten Telefonie gescheitert sind. Die Marketingfolien vieler Anbieter versprechen Erkennungsraten von über 90 Prozent. Was verschwiegen wird: Diese Benchmarks stammen meist von klinisch sauberen, von Schauspielern eingesprochenen Datensätzen wie RAVDESS oder IEMOCAP. In der Praxis eines Contact-Centers prallen diese naiven Modelle auf Hintergrundgeräusche aus U-Bahnen, stark komprimierte GSM-Codecs billiger Mobiltelefone und dichte Dialekte. Dieser sogenannte Data Mismatch führt dazu, dass feine akustische Features massiv verzerrt werden. Wenn ein hochgezüchtetes Modell einen starken bayerischen Akzent konsequent als 'leicht depressiv' klassifiziert, zeigt sich die immense Verwundbarkeit von über-optimierten Systemen in der freien Wildbahn.
- Verlust der Frequenzvielfalt durch schmalbandige Telefon-Codecs (8 kHz Abtastrate).
- Fehlinterpretation von lauten Umgebungsgeräuschen als Anhebung der Stimm-Amplitude des Nutzers.
- Kulturelle Varianzen in der Artikulation von Wut, die in generischen US-fokussierten Datensätzen nicht abgebildet sind.
- Fehlender historischer Kontext für Sarkasmus, der ohne Gedächtnis des LLMs nicht erkennbar ist.
Empathie in Maschinen ist keine metaphysische Frage des Fühlens, sondern eine Frage der mathematischen Präzision und der Latenz im exakt richtigen Moment. Wer zu spät reagiert, deeskaliert nicht, sondern verhöhnt.
Pro & Contra: Sollten wir Maschinen Empathie simulieren lassen?
Die ethische und UX-bezogene Dimension von simulierter maschineller Empathie wird in Entwicklerkreisen heiß diskutiert. Technisch können wir eine perfekt mitleidige Stimme generieren, doch das stößt rasch in das sogenannte Uncanny Valley vor. Wenn eine künstliche Intelligenz am Telefon zu menschlich, zu betroffen reagiert, fühlen sich aufgebrachte Kunden oftmals nicht ernst genommen, sondern von einem Stück Software manipuliert. Das Ziel darf also niemals sein, menschliches Mitgefühl zu imitieren, sondern sogenannte funktionale Empathie zu implementieren. Die Maschine muss durch Anpassung ihrer Tonalität lediglich signalisieren, dass sie die Dringlichkeit der Situation erfasst hat und den Prozess entsprechend priorisiert, ohne echte menschliche Affekte zu heucheln.
Vorteile
- Absolute 24/7-Geduld: Maschinen lassen sich durch wütende Kunden nicht persönlich triggern.
- Datenbasierte Insights: Aggregierte Stress-Metriken decken schlechte Prozesse in Unternehmen gnadenlos auf.
- Entlastung der Agenten: Toxische Gespräche werden abgefangen oder vorgefiltert, was Burnout-Raten senkt.
Nachteile
- Uncanny Valley Effekt: Übermäßige Empathie-Simulation wirkt manipulativ und unnatürlich.
- Datenschutz-Risiken: Emotionen gelten rechtlich zunehmend als hochsensible biometrische Daten nach DSGVO.
- Brüchigkeit in Edge-Cases: Bei starkem Sarkasmus kann die falsche Deeskalations-Strategie Kunden noch wütender machen.
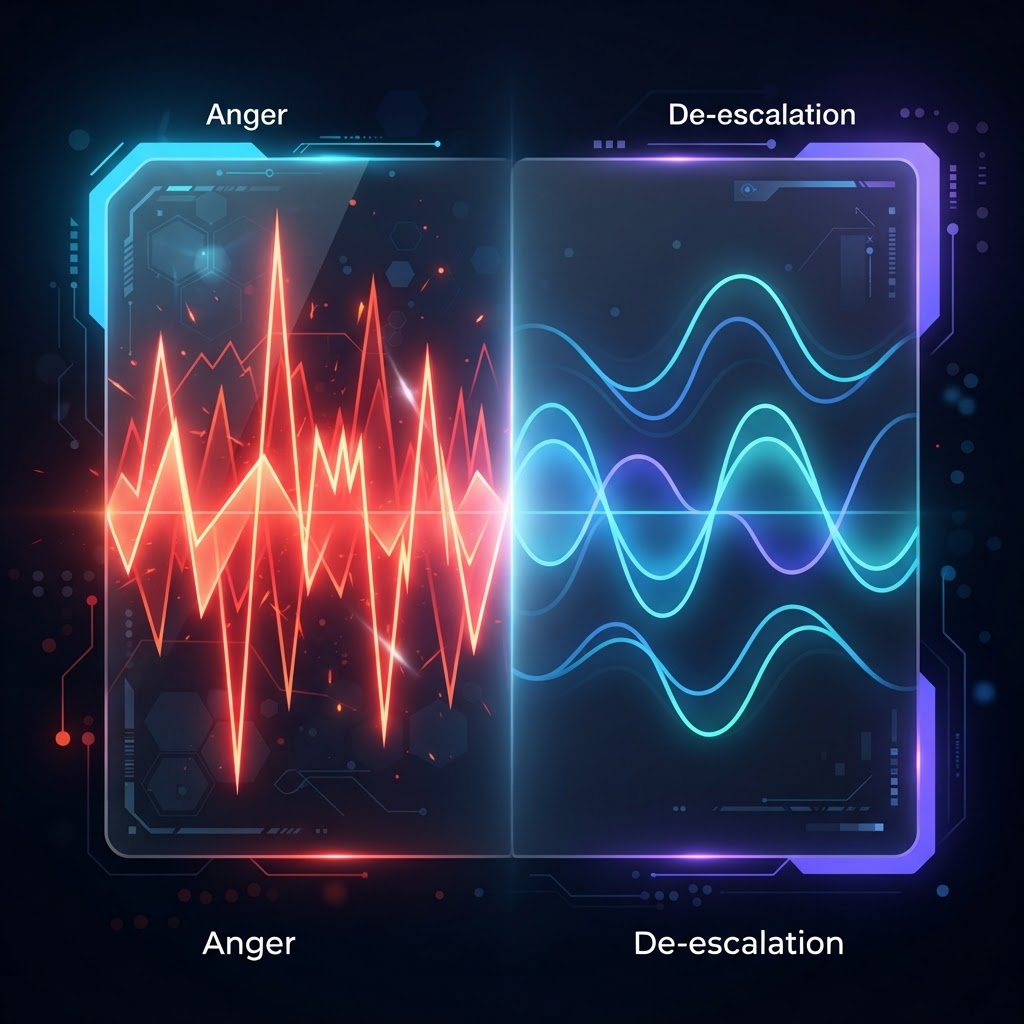
Architektur-Blueprint: Emotion AI in Legacy-Systeme integrieren
Ein System ist nur so gut wie seine Anbindung an bestehende Enterprise-Infrastruktur. Bei der AI-Software GmbH setzen wir auf asynchrone Microservices-Architekturen, um das Audio-Signal abzufangen. Das Signal von klassischen PBX-Systemen oder Cloud-Contact-Centern wie Genesys oder Twilio wird meist via SIPREC (Session Initiation Protocol Recording) oder direkte Media Streams dupliziert. Diese Streams jagen wir über persistente WebSocket-Verbindungen oder gRPC-Protokolle an unser Inference-Cluster. Dort müssen Voice Activity Detection (VAD), ASR, NLP und die akustische Emotionsanalyse strikt parallel ausgeführt werden. Jede sequentielle Abarbeitung würde die Antwortzeiten massiv in die Höhe treiben und den gesamten Dialogflow zerstören.
Achtung: Latenz als Conversational Killer
Wenn die Round-Trip-Time (RTT) für Ingestion, Inference und TTS-Generierung die Marke von 400 Millisekunden überschreitet, entsteht eine unnatürliche Konversations-Lücke. Einem ohnehin schon wütenden Kunden durch Latenz das Gefühl zu geben, ignoriert zu werden, ist der sicherste Weg zur ultimativen Eskalation. Edge-Computing und Inferenz-Beschleunigung via TensorRT sind daher keine Luxus-Features, sondern absolute Projekt-Voraussetzungen.
Die nächsten 36 Monate: LLMs treffen auf multimodale Echtzeit-Sprache
Der Blick in die unmittelbare Zukunft offenbart einen massiven Paradigmenwechsel, den wir in unseren Architektur-Designs bei der AI-Software GmbH bereits berücksichtigen. Die beschriebene kaskadierte Pipeline aus ASR, Sentiment-Analyse und TTS nähert sich ihrem End of Life. Wir sehen aktuell den rasanten Aufstieg nativer, multimodaler End-to-End-Modelle. Diese Architekturen verarbeiten Audio direkt auf Token-Ebene, ohne den fatalen Zwischenschritt der Text-Transkription. Das native Voice-Feature aktueller High-End-LLMs demonstriert diesen Ansatz bereits eindrucksvoll. Diese Systeme begreifen Lachen, Seufzen, tiefes Durchatmen und den Subtext von Zögern ohne fehleranfällige Umwege. Das eliminiert nicht nur den Informationsverlust, sondern drückt auch die Latenzen in Bereiche unter 200 Millisekunden.
Für Entscheider im Kundenservice hat diese Entwicklung dramatische Implikationen. Der Wettbewerb um hervorragende Customer Experience verlagert sich vollständig auf die KI-gesteuerte Audio-Ebene. Wer im Jahr 2026 noch Kunden in statischen DTMF-Menüs ('Drücken Sie die 1') gefangen hält, wird von agilen Konkurrenten abgestraft werden. Emotionale KI wird vom experimentellen Innovations-Projekt zur absoluten Hygiene-Metrik für die Churn-Prevention. Wir bauen bei der AI-Software GmbH genau diese skalierbaren Architekturen, die heute die Basis legen, um morgen nicht den technologischen Anschluss an die multimodale Revolution zu verlieren.
Bereit für Voice-Systeme, die wirklich zuhören?
Die Implementierung von adaptiven Voice-Bots duldet keine Experimente mit veralteten Systemen. Sprechen Sie mit den Architekten der AI-Software GmbH, um Ihre Infrastruktur für die Ära der multimodalen Echtzeit-Sprache aufzurüsten und echten Mehrwert für Ihre Kunden zu schaffen.
Projekt startenDouble-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.