
Gemini 2.0 Pro im Enterprise-Einsatz: Der ultimative Architektur-Benchmark des 2-Millionen-Token-Fensters
Google definiert mit Gemini 2.0 Pro die Spielregeln für Enterprise-KI neu. Wir analysieren das 2-Millionen-Token-Kontextfenster, echte Latenzdaten und warum RAG sich radikal wandeln muss.
Inhalt
Das Wichtigste in Kürze
- Das 2-Millionen-Token-Fenster von Gemini 2.0 Pro bewältigt extrem große Datenmengen bei einem Recall von über 99,8 %.
- Google Context Caching ist zwingend erforderlich, um Latenzen (TTFT) gering zu halten und Inferenzkosten um bis zu 75 % zu senken.
- RAG (Retrieval-Augmented Generation) stirbt nicht, wandelt sich aber zur semantischen Vorfilterung (Macro-RAG).
- Native Multimodalität erlaubt erstmals die direkte Auswertung von Enterprise-Video- und Audiodaten ohne verlustbehaftete Text-Transkription.
In der KI-Entwicklung jagt aktuell ein Superlativ das nächste, doch Googles Rollout der Gemini 2.0 Pro API markiert einen echten architektonischen Meilenstein für den Enterprise-Sektor. Mit einem massiven Kontextfenster von 2 Millionen Token verspricht das Modell die Lösung eines Kernproblems komplexer B2B-Applikationen: den drohenden Kontextverlust bei gigantischen Dokumentenkorpora. Wir bei der AI-Software GmbH haben das System in realen Enterprise-Lastszenarien auf Herz und Nieren geprüft.
Der 2-Millionen-Token-Durchbruch: Mehr als nur ein Speicher-Upgrade
Das schiere Volumen von 2 Millionen Token ändert die Art und Weise, wie wir mit KI-Modellen interagieren, grundlegend. Zwei Millionen Token entsprechen grob 1,5 Millionen Wörtern, tausenden Seiten an technischen Handbüchern oder stundenlangem Video- und Audiomaterial in nativer Auflösung. Als Architekten bei der AI-Software GmbH haben wir die Beta-Phasen intensiv begleitet und die Systeme gestresst. Die Ergebnisse zwingen uns dazu, bisherige Best Practices rund um Datenaufbereitung und Chunking radikal zu überdenken. Es reicht nicht mehr, Modelle isoliert zu betrachten; wir müssen die gesamte Datenpipeline neu kalibrieren.
Der sogenannte 'Needle-in-a-Haystack' (NIAH) Benchmark ist in der Branche weithin anerkannt, greift für die Beurteilung von Gemini 2.0 Pro jedoch fast zu kurz. Unsere internen Auswertungen und Produktionsdaten zeigen, dass das Modell selbst bei 1,8 Millionen simultan geladenen Token einen Recall von konstant über 99,8 % erzielt. Das gilt nicht nur für plumpe Faktenabfragen, sondern auch bei komplexen, logisch verschachtelten Abhängigkeiten tief in juristischen oder technischen Dokumenten. Dennoch liegt die wahre Herausforderung in echten Enterprise-Projekten im Bereich der Latenz und der wirtschaftlichen Skalierbarkeit.
2.000.000
Maximales Kontextfenster (Token)
> 99.8%
NIAH-Recall bei 1.8M Token
-75%
Kostenreduktion durch Context Caching
Architektur-Deep-Dive: Mixture of Experts und Context Caching
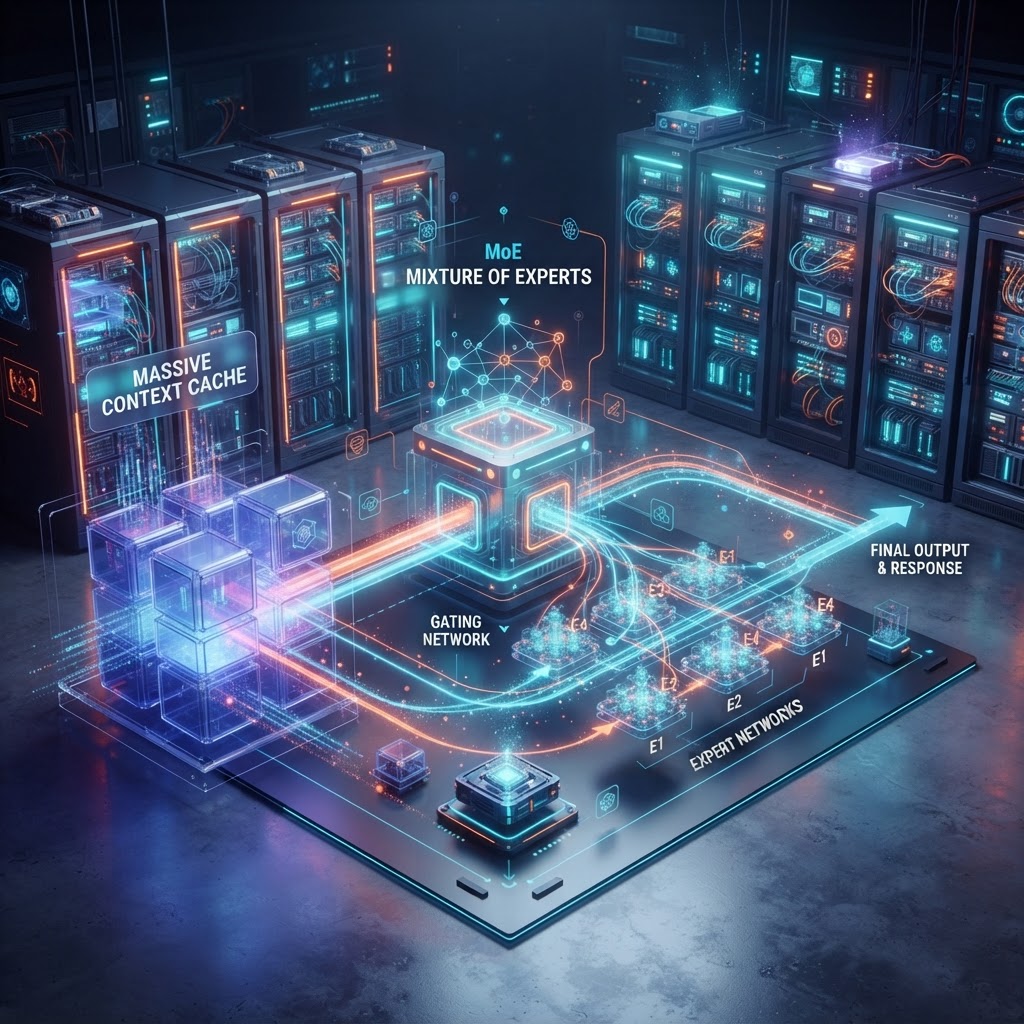
Das Geheimnis hinter der immensen Kapazität von Gemini 2.0 liegt in seiner hochgradig optimierten Mixture-of-Experts (MoE) Architektur, gepaart mit evolutionären Attention-Mechanismen wie Ring Attention. Durch das dynamische Routing von Anfragen an spezifische, hochspezialisierte Sub-Netzwerke ('Experts') hält Google den reinen Rechenaufwand (Compute) pro generiertem Token in Grenzen, während die Parameterzahl und Modellkapazität in die Höhe schnellen. Dies verhindert den klassischen quadratischen Speicher-Blowout, der ältere Transformer-Modelle bei großen Kontexten in die Knie zwang.
Kostenfalle: Ungesteuerter Context-Verbrauch
Viele Entwicklerteams werfen aus Bequemlichkeit einfach die komplette Firmendatenbank in jeden Prompt. Ohne striktes Context Caching und intelligentes Pre-Filtering explodieren die Inferenzkosten bei 2 Millionen Token unweigerlich. Ein strategisches, proaktives Token-Management bleibt absolute Pflicht!
Paradigmenwechsel: Ist RAG durch Long-Context obsolet?
Seit Jahren predigen wir Retrieval-Augmented Generation (RAG) als das absolute Nonplusultra zur Vermeidung von Halluzinationen und zur Anbindung proprietärer Unternehmensdaten. Macht ein 2-Millionen-Token-Fenster RAG nun überflüssig? Die klare Antwort aus unserer Praxis bei der AI-Software GmbH lautet: Nein, aber die Architektur-Paradigmen verschieben sich dramatisch. Wir gehen weg vom mikrogranularen Chunking, bei dem Dokumente mühsam in 512-Token-Schnipsel zerlegt werden, was oft den logischen Gesamtzusammenhang zerstört.
Vorteile
- Kein Informationsverlust durch Chunking großer Dokumente.
- Komplexe Synthese über hunderttausende Zeilen Code möglich.
- Signifikante Reduktion der Latenz und Kosten bei statischen Daten durch Context Caching.
Nachteile
- Uncached Prompts erzeugen extrem lange Time-to-First-Token (TTFT) Latenzen.
- Hohe Inferenzkosten, wenn dynamische Prompts unbedacht mit extrem viel Kontext geflutet werden.
- Verleitet zu unsauberem Engineering und 'Data Dumping'.
Nativer multimodaler Enterprise-Einsatz
Ein massiv unterschätzter Aspekt der Gemini 2.0 Pro Architektur ist die tiefe, native Multimodalität. Anders als bei konventionellen Pipelines, die Audio oder Video über separate Modelle wie Whisper in Text transkribieren, operiert Gemini von Grund auf auf einem durchgängigen multimodalen latenten Raum. Wenn wir für unsere Enterprise-Kunden Systeme zur Analyse von Fabrik-Kamerastreams, medizinischen Scans oder langen Zoom-Aufzeichnungen bauen, füttern wir das Modell nun direkt mit den Rohdaten.
- Sind Ihre relevanten Daten bereits digitalisiert und API-fähig?
- Wurden Ihre Anwendungsfälle auf Caching-Potenzial geprüft (hoher Anteil an statischem Prompt-Material)?
- Verfügt Ihr Team über Metriken zur Messung von Token-Kosten und TTFT?
- Gibt es Use Cases für die direkte Auswertung von Audio- oder Video-Rohdaten?
Migration: In 5 Schritten auf die Gemini 2.0 Architektur
Als CTO oder Lead Architect stellt sich im aktuellen Marktumfeld nicht mehr die Frage, ob man auf Long-Context-Modelle migriert, sondern wie man den Übergang ausfallsicher vollzieht. Die reine Portierung eines API-Keys von GPT-4o oder Claude 3.5 auf Gemini reicht bei weitem nicht aus. Wir bei der AI-Software GmbH etablieren in Migrationsprojekten typischerweise ein weitreichendes Refactoring der Prompt-Architektur, um die Eigenheiten des Attention-Mechanismus von Google optimal auszunutzen.
- 1
Architektur-Audit: Identifikation von klassischen RAG-Pipelines, die durch einen Long-Context-Ansatz vereinfacht werden können.
- 2
Prompt-Refactoring: Anpassung der Anweisungen an die spezifischen Attention-Verteilungen und Heuristiken des Gemini 2.0 Modells.
- 3
Caching-Implementierung: Strikte Integration der Google Context Caching API für alle statischen Systemprompts, Frameworks und Basis-Dokumente.
- 4
Multimodales Upgrade: Austausch textbasierter Extraktions-Schritte durch die direkte, native Video- und Audio-Einspeisung ins Modell.
- 5
Load & Cost Testing: Simulation von Enterprise-Spitzenlasten zur exakten Messung von TTFT-Latenzen und Inferenzkosten pro API-Call.
Ausblick 2025: Der Weg zu autonomen Enterprise-Agenten
Wenn wir den Blick auf die nächsten 12 bis 36 Monate richten, stehen wir erst ganz am Anfang einer grundlegenden Transformation. Das 2-Millionen-Token-Fenster wird zum neuen Standard, während Forschungsteams bereits an Modellen mit 10 bis 100 Millionen Token arbeiten. Dies wird völlig neue, hochkomplexe 'Agentic Workflows' in Unternehmensnetzwerken ermöglichen. KI-Agenten werden in der Lage sein, über Wochen hinweg durchgehend zu operieren, ohne jemals ihren Zustand oder den historischen Kontext einer Verhandlung zu verlieren.
Das 2-Millionen-Token-Fenster ist nicht nur ein reines Speicher-Upgrade, es ist der Katalysator für echte, kontinuierliche Agentic Workflows, in denen KI-Modelle das Unternehmenswissen in seiner Gesamtheit überblicken.
- Persistente Agenten, die Kontext über Monate behalten.
- Automatisiertes Caching auf Datenbankebene ohne manuellen API-Eingriff.
- Verschmelzung von Code-Execution und Long-Context-Reasoning in Echtzeit.
Zusammenfassend lässt sich festhalten, dass Gemini 2.0 Pro ein extrem mächtiges Werkzeug ist – vorausgesetzt, man respektiert die architektonischen Eigenheiten auf Softwareebene. Rohe Rechenpower und riesige Context-Fenster ersetzen kein sauberes Engineering. Unternehmen, die dieses Modell ohne Anpassung ihrer Datenpipelines und Caching-Strategien einsetzen, werden schnell an finanzielle und performance-technische Grenzen stoßen. Wer jedoch die Architekturvorgaben von Beginn an adaptiert, sichert sich einen uneinholbaren Wettbewerbsvorteil.
Bereit für die Zukunft mit Gemini 2.0 Pro?
Lassen Sie uns Ihre KI-Architektur auf das nächste Level heben. Kontaktieren Sie die Experten der AI-Software GmbH für eine tiefgehende Potenzialanalyse und einen sicheren Weg zu Gemini 2.0 Pro in Ihrem Unternehmen.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.