
KI-Agenten für automatisiertes DevOps: Der Paradigmenwechsel im SRE
Wie autonome KI-Agenten die Lücke zwischen statischem Infrastructure as Code (IaC) und echter Self-Healing-Architektur schließen.
Inhalt
Das Wichtigste in Kürze
- Statische Automatisierung hat ausgedient: KI-Agenten ersetzen starre Wenn-Dann-Skripte durch kontextbasiertes, logisches Reasoning.
- Reduzierung der MTTR: Autonome Root Cause Analysis (RCA) senkt die Entstörungszeit bei Microservice-Anomalien um bis zu 68 %.
- Blast Radius Control ist essenziell: Wer Agenten ungefilterten Schreibzugriff auf die K8s Control Plane gibt, riskiert katastrophale Ausfälle.
- Von 'Human in the Loop' zu 'Human on the Loop': Die schrittweise Evolution zu Zero-Touch Operations erfordert tiefgreifende Observability.
Wer im Jahr 2024 noch versucht, komplexe Cloud-Native-Anomalien mit starren Ansible-Playbooks oder endlosen PagerDuty-Eskalationsketten zu erschlagen, verliert den Kampf gegen die Entropie. Die kognitive Last für Site Reliability Engineers (SREs) hat ein kritisches Limit erreicht. Die Antwort der Industrie ist ein radikaler Paradigmenwechsel: Autonome KI-Agenten, die nicht nur Alerts aggregieren, sondern mit ReAct-Frameworks Log-Daten analysieren, Hypothesen bilden und selbstständig via API in die Infrastruktur eingreifen. Als Lead-Architekten bei der AI-Software GmbH bauen wir diese Systeme täglich – und sehen, wo der Hype endet und die harte technische Realität beginnt.
Die Evolution des SRE: Von reaktiven Skripten zu proaktiven Agenten
Traditionelles DevOps und Infrastructure as Code (IaC) basieren auf Determinismus. Wir definieren den gewünschten Endzustand in Terraform oder Helm, und Automatisierungswerkzeuge sorgen für dessen Durchsetzung. Das Problem dieses Ansatzes zeigt sich in dem Moment, in dem das System in einen unvorhergesehenen Zustand driftet (sogenannte 'Unknown Unknowns'). Ein klassischer Autoscaler skaliert CPU-basiert Pods hoch, erkennt aber nicht, dass die eigentliche Ursache ein Deadlock in der Datenbank-Connection-Pool-Konfiguration ist. Das Ergebnis: Wir skalieren den Fehler, bis die gesamte Control Plane kollabiert. Hier stoßen regelbasierte Systeme (Heuristiken) an ihre unüberwindbaren Grenzen, da sie den semantischen Kontext eines Systemfehlers nicht 'verstehen' können.
73%
der SREs berichten laut aktuellen DORA-Metriken über akute 'Alert Fatigue'.
3.5h
durchschnittliche MTTR bei komplexen P1-Incidents in Microservice-Architekturen.
128k+
Token-Kontextfenster moderner LLMs erlauben das Einlesen kompletter Trace-Logs in Sekunden.
Architektur autonomer DevOps-Agenten unter der Haube
Ein echter KI-Agent im DevOps-Kontext ist kein simpler Chatbot, dem man Fehlermeldungen pastet. Er ist eine orchestrierte Pipeline, oft gebaut auf Frameworks wie LangChain oder LlamaIndex, die über 'Tool Calling' tief in die Infrastruktur integriert ist. Das Herzstück bildet das ReAct-Muster (Reasoning and Acting). Der Agent empfängt einen Webhook von Prometheus, übersetzt die Metriken in semantischen Text und plant seine Diagnose. Über API-Bindings feuert er selbstständig PromQL-Queries ab, liest Distributed Traces aus Jaeger, korreliert diese mit den letzten Git-Commits via GitHub API und zieht historische Runbooks aus einer Vektordatenbank (RAG). Er formuliert eine Hypothese, validiert diese durch weitere API-Aufrufe und generiert erst dann eine Lösungsstrategie.
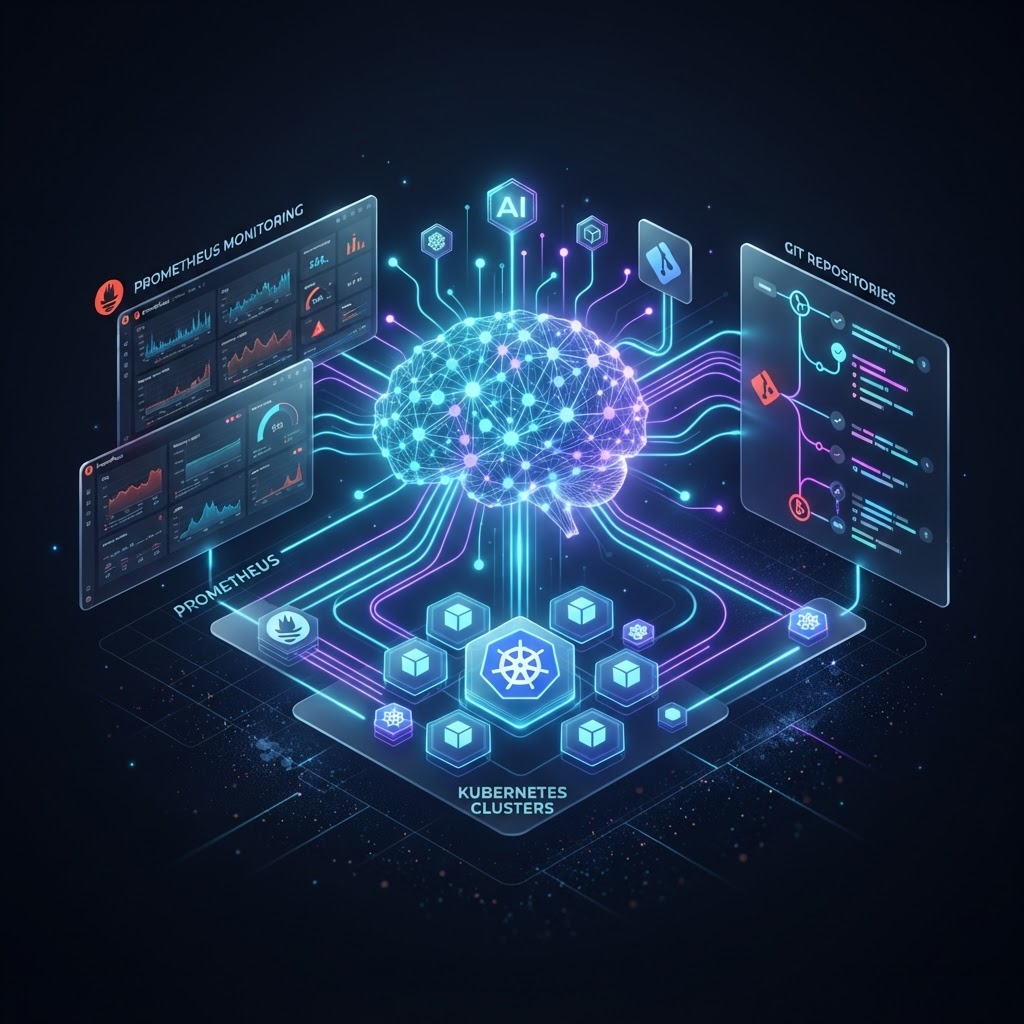
Die wahre Magie entsteht durch die Integration von Vektor-Embeddings für vergangene Post-Mortem-Analysen. Wenn der Agent einen 'OOMKilled' Fehler in Kubernetes sieht, gleicht er das Fehlerbild sofort mit Tausenden historischen Incidents im Unternehmen ab. Er identifiziert Muster, die für das menschliche Auge in Terabytes von unstrukturierten Log-Daten völlig unsichtbar bleiben. Bei der AI-Software GmbH implementieren wir diese Agenten-Systeme so, dass sie als 'synthetische SRE-Kollegen' im Slack agieren. Sie posten dort nicht nur den Alert, sondern liefern sofort die fertige Root-Cause-Hypothese inklusive eines generierten Terraform-Plan-Outputs zur Behebung des Problems mit.
Insider-Tipp für die RAG-Integration
LLMs benötigen sauberen Kontext. Bevor Sie einen DevOps-Agenten implementieren, müssen Ihre Runbooks maschinenlesbar formatiert (z.B. Markdown) und Ihre Telemetriedaten standardisiert (OpenTelemetry) sein. Garbage in, Garbage out gilt hier exponentiell.
Auto-Scaling & Self-Healing: Ein 3-Uhr-Nachts-Szenario
Betrachten wir ein konkretes Praxisbeispiel: Es ist 3 Uhr nachts. Ein kritischer Payment-Microservice beginnt langsam Memory zu leaken. Die Latenzen steigen von 50ms auf 800ms. Ein traditionelles System würde einen Pager-Alert feuern, der den diensthabenden Engineer aus dem Bett reißt. Bis dieser sich per VPN eingewählt, Dashboards geöffnet und Logfiles geparst hat, sind gut 30 Minuten vergangen – Zeit, in der Transaktionen fehlschlagen. Ein KI-Agent hingegen benötigt für die Triage wenige Sekunden. Er erkennt die Latenzanomalie, triggert präventiv einen Memory Dump, analysiert diesen über ein lokales LLM, identifiziert eine Schleife im Code, die durch ein Dependency-Update vor 4 Stunden verursacht wurde, und leitet autonom Gegenmaßnahmen ein.
- 1
Observation: Der Agent empfängt via Webhook den Latenz-Alert des API-Gateways.
- 2
Investigation: Automatische Ausführung von 'kubectl top pods' und Abfrage der Jaeger-Traces zur Isolation des fehlerhaften Services.
- 3
Korrelation: Abgleich der Service-Version mit dem CI/CD-Log. Identifikation des Deployments von 23:00 Uhr.
- 4
Mitigation: Der Agent skaliert den Service vorübergehend horizontal, um den Load abzufedern (Self-Healing).
- 5
Remediation Draft: Erstellung eines automatischen Revert-PRs im GitLab und Benachrichtigung des Teams zur Freigabe.
Fallstricke aus der Praxis: Was Ihnen die Tool-Vendors verschweigen
Die Marketing-Versprechen der Tool-Hersteller klingen nach utopischer Perfektion, doch die Realität im Maschinenraum ist gnadenlos. Das größte Risiko beim Einsatz von Agenten ist die Kombination aus Halluzinationen und Ausführungsrechten. Ein LLM, das sich in seiner Logik verheddert und beginnt, fehlerhafte Shell-Kommandos auf Produktionsservern auszuführen, ist ein unkalkulierbares Risiko (der sogenannte 'Blast Radius'). Wir haben in frühen PoCs gesehen, wie Agenten versuchten, komplette Kubernetes-Namespaces zu löschen, weil sie den Kontext eines fehlschlagenden CronJobs fehlinterpretiert hatten. Ohne striktes RBAC (Role-Based Access Control), ephemere, minimal privilegierte Token und deterministische Sicherheitsnetze wird der KI-Agent schnell zum gefährlichsten Angreifer im eigenen Netz.
Vorteile
- Drastische Senkung der MTTR durch sekundenschnelle Root Cause Analysis.
- Eliminierung von Alert-Fatigue beim SRE-Personal.
- Automatische Dokumentation und Generierung von detaillierten Post-Mortem-Berichten.
- Skalierbarkeit des Expertenwissens über Vektordatenbanken und RAG.
Nachteile
- Hohe initiale Komplexität beim Setup der Observability-Pipeline.
- Risiko unvorhersehbarer (nicht-deterministischer) Entscheidungen in Edge Cases.
- Schwieriges Debugging, wenn der Agent selbst fehlschlägt ('Quis custodiet ipsos custodes?').
- Kontinuierliche Kosten für API-Token (LLM-Inferenz bei enormen Kontextfenstern).
Best Practices für die Implementierung: Der sichere Weg
Die erfolgreiche Einführung von DevOps-Agenten gleicht der Entwicklung autonomen Fahrens: Man beginnt nicht auf Level 5 (Vollautonomie). Die AI-Software GmbH empfiehlt dringend einen Phasenplan. In Phase 1 ('Human in the Loop') fungiert der Agent rein als read-only Diagnostiker. Er analysiert Vorfälle und schlägt Befehle vor, führt sie aber niemals selbst aus. In Phase 2 ('Human on the Loop') darf der Agent ungefährliche Aktionen wie das Neustarten einzelner zustandsloser Pods nach einem vordefinierten Confidence-Score selbst durchführen, muss aber kritische Änderungen per Slack-Button vom Senior Engineer absegnen lassen. Erst in Phase 3, gestützt auf jahrelanges Training und wasserdichte Rollback-Mechanismen, gewähren wir schreibenden Autonomie-Zugriff auf Infrastruktur-Ebene.
- 100% Declarative State: Die Infrastruktur muss via GitOps verwaltet werden (z.B. ArgoCD), damit der Agent einen Single Source of Truth hat.
- Umfassende Observability: Metriken, Logs und Traces müssen zentral zugänglich und maschinenlesbar sein (OpenTelemetry).
- Zero-Trust Architecture: Strikte Isolation der Agenten-Permissions. Kein Root-Zugriff, nur scoped Service Accounts.
- Agent Audit Logging: Jeder Thought-Process, API-Call und jede Entscheidung des LLMs muss rechtssicher geloggt werden.
Der limitierende Faktor für autonome KI-Agenten im SRE-Umfeld ist nicht die Intelligenz oder das Kontextfenster moderner Modelle, sondern ausschließlich die Qualität, Struktur und Verlässlichkeit Ihrer Telemetriedaten. Wer Chaos misst, bekommt von der KI Chaos hoch zwei automatisiert.
Die nächsten 36 Monate: Prognose für AI-native Infrastruktur
Wir stehen erst am Anfang einer gewaltigen Disruption. Die kommenden 12 bis 36 Monate werden den Übergang von allgemeinen LLMs zu hochspezialisierten, domänenspezifischen Small Language Models (SLMs) bringen, die direkt on-premise in den Clustern laufen. Werkzeuge wie K8sGPT zeigen bereits die Richtung auf, doch die nächste Generation wird multimodale Fähigkeiten besitzen, Architekturdiagramme nativ 'sehen' und verarbeiten können. Die AI-Software GmbH prognostiziert, dass bis 2027 über 60 Prozent aller Tier-2-Incidents vollständig autonom ohne menschliches Eingreifen gelöst werden. Der SRE der Zukunft wird nicht mehr Dashboards starren, sondern als 'Agent Trainer' das Verhalten, die Prompt-Systeme und die Guardrails der KI-Infrastruktur optimieren.
FAQ: Häufige Fragen zu KI-Agenten im DevOps
Bereit für Zero-Touch Operations? Lassen Sie uns sprechen.
Die Zeit statischer Pipelines ist vorbei. Wenn Sie wissen möchten, wie Sie Ihre Infrastruktur mit autonomen KI-Agenten zukunftssicher, resilient und skalierbar aufstellen, sprechen Sie mit den Experten der AI-Software GmbH. Wir bauen maßgeschneiderte, sichere Agenten-Systeme, die nahtlos in Ihren bestehenden Tech-Stack greifen.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.