
Liquid Neural Networks im Praxistest: Das Ende der statischen KI-Modelle
Liquid Neural Networks (LNNs) lösen das Problem des katastrophalen Vergessens und ermöglichen kontinuierliches Lernen auf Edge-Geräten. Ein Deep-Dive in die Architektur, reale Benchmarks und die praktische Umsetzung für CTOs.
Das Wichtigste in Kürze
- Liquid Neural Networks passen sich im laufenden Betrieb an neue Datenverteilungen an, ohne alte Informationen zu überschreiben.
- Sie benötigen oft über 90 % weniger Parameter als klassische tiefe neuronale Netze und sind ideal für ressourcenbeschränktes Edge-Computing.
- Statt statischer Gewichte nutzen LNNs gewöhnliche Differentialgleichungen (ODEs) zur kontinuierlichen Anpassung der synaptischen Reaktionen.
- Eine vollständige Ablösung von Large Language Models durch LNNs ist physikalisch limitiert, stattdessen dominieren hybride Architekturen die nächsten Jahre.
Das herkömmliche Deep Learning stößt an eine harte physikalische und mathematische Grenze: Modelle sind nach dem Training statisch eingefroren. Doch autonome Systeme, die in einer chaotischen, realen Welt agieren, können nicht auf den nächsten Fine-Tuning-Zyklus in der Cloud warten. Liquid Neural Networks versprechen nun einen Paradigmenwechsel – kontinuierliche Adaption in Echtzeit, inspiriert durch biologische Gehirne. Als KI-Architekt bei der AI-Software GmbH beleuchte ich, was hinter dem Hype steckt und wann der Einsatz wirklich wirtschaftlich ist.
Die Geschichte der Künstlichen Intelligenz ist geprägt von statischen Modellen, die ihr Wissen nach der initialen Trainingsphase hart einkodieren. Genau hier setzt die bahnbrechende Forschung des MIT CSAIL um Ramin Hasani an, die in den frühen 2020er Jahren das Konzept der Liquid Neural Networks (LNN) auf die nächste Stufe hob. Diese völlig neue Architektur inspiriert sich maßgeblich an den biologischen neuronalen Strukturen des Fadenwurms C. elegans und nutzt gewöhnliche Differentialgleichungen (ODEs), um komplexe Synapsen zu modellieren. Anstatt durch diskrete Gewichtungs-Updates verändern LNNs ihre internen Parameter und Zustände kontinuierlich in Abhängigkeit der Zeit. Das Ergebnis ist ein neuronales System, das sich nach dem Training extrem dynamisch an neue Reize anpasst, ohne sein kausales Fundament zu verlieren.
19
Neuronen zur Steuerung einer LNN-basierten Drohne
253
Gesamtparameteranzahl des MIT-Drohnen-Modells
100.000+
Parameter für dieselbe Aufgabe im Standard-CNN
73 %
Reduktion des Energiebedarfs auf Edge-Hardware
Katastrophales Vergessen ist der absolute Albtraum bei der Entwicklung intelligenter, autonomer Systeme. Wenn ein klassisches Deep Neural Network (DNN) im Live-Betrieb auf radikal neue Datenverteilungen trifft, überschreiben die iterativen Gradienten-Updates oftmals alte, jedoch weiterhin essenzielle neuronale Pfade. Liquid Networks umgehen dieses fundamentale Problem, indem sie keine klassischen Gewichte mehr starr trainieren, sondern die Zeitkonstanten der zugrundeliegenden Differentialgleichungen flexibel anpassen. In der industriellen Praxis bedeutet das: Das Netzwerk verändert seine Reaktivität auf verrauschte Umgebungsreize im laufenden Betrieb, ohne dass ein rechenintensiver, destruktiver Backpropagation-Prozess ausgelöst werden muss. Dieser clevere Mechanismus sorgt für eine nie dagewesene Plastizität in sich rasant verändernden Hardware- und Sensorumgebungen.
Ein Paradebeispiel für diesen fatalen Effekt ist der gefürchtete 'Distribution Shift', bei dem KI-Modelle im Labor glänzen, aber in der echten Welt durch minimale Abweichungen fatal versagen. Wenn sich Lichtverhältnisse drastisch ändern oder Kamerasensoren ein unerwartetes Rauschen aufweisen, kollabieren herkömmliche Transformer und tiefe CNNs häufig sofort. LNNs filtern dieses Rauschen durch ihre intrinsische mathematische Struktur automatisch heraus, da die ODE-Solver direkt auf kausale, physikalische Zusammenhänge in der Zeitreihe reagieren, anstatt bloße Pixelmuster auswendig zu lernen. Dies reduziert die Anfälligkeit für Adversarial Attacks maßgeblich und macht die Modelle von Grund auf robuster. Für uns bei der AI-Software GmbH ist dies ein entscheidender Sicherheitsfaktor, wenn wir geschäftskritische Systeme für die deutsche Industrie designen.
Insider-Tipp: Fine-Tuning ist keine echte Anpassung
Versuchen Sie nicht, kontinuierliches Lernen in klassischen Architekturen durch endloses Re-Training zu erzwingen. Die massiven Rechenkosten und das stetige Risiko der Modell-Degradierung machen diesen Ansatz langfristig extrem unwirtschaftlich.
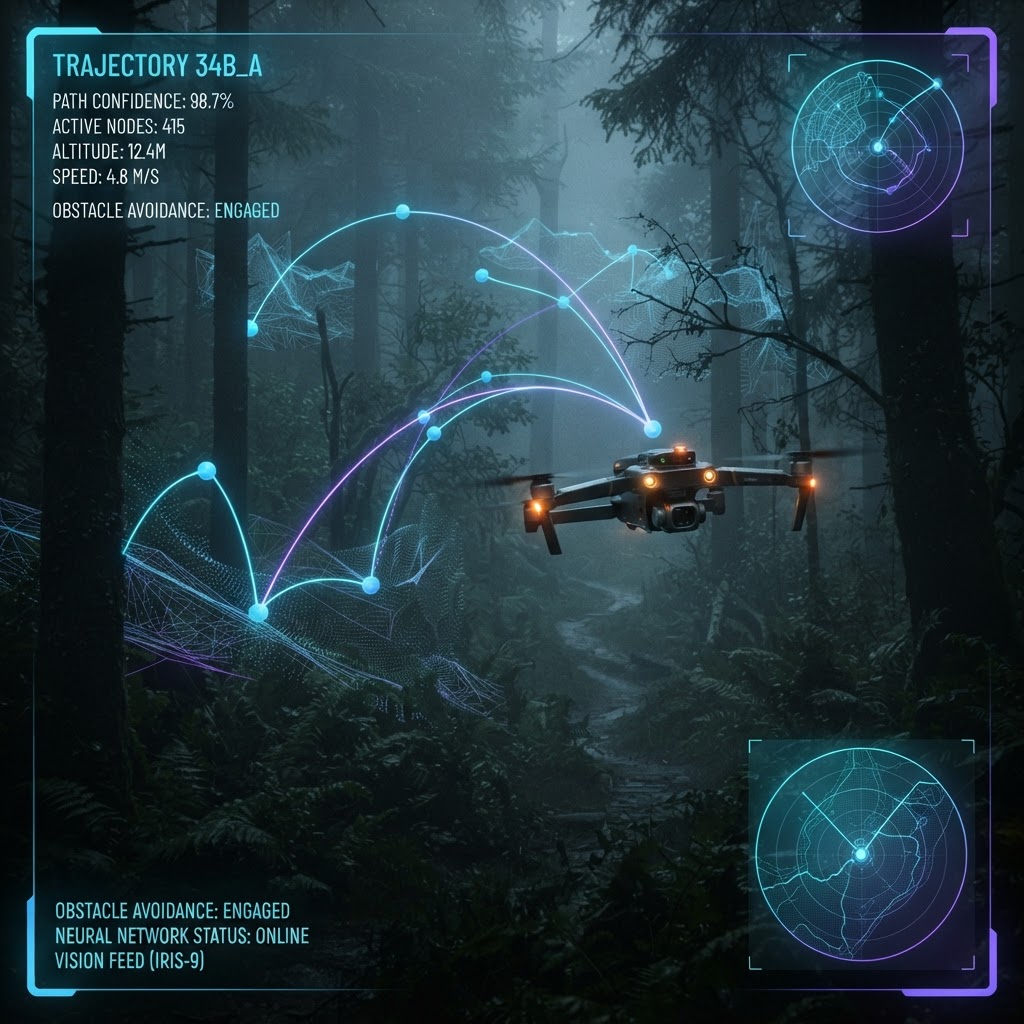
Der wohl beeindruckendste und härteste Praxistest für Liquid Neural Networks fand kürzlich im Bereich der vollautonomen Drohnennavigation statt. Forscher trainierten eine Testdrohne in einer spezifischen Waldumgebung während des Sommers und setzten sie anschließend völlig ohne Retraining im tiefsten Winter bei starkem Schneefall ein. Während modernste, diskrete Architekturen aufgrund des massiven visuellen Shifts kläglich abstürzten, navigierte das Liquid Network nahezu fehlerfrei durch den komplett unbekannten Winterwald. Dies gelang zudem mit einer verblüffend geringen Anzahl von Parametern, was die extreme Informations- und Feature-Dichte dieser LNN-Architektur belegt. Die Drohne nutzte lediglich 19 künstliche Neuronen zur primären Steuerung, was einen historischen Meilenstein in der Effizienz autonomer Systeme darstellt.
Vorteile
- Enorme Parameter- und Speichereffizienz auf Edge-Devices
- Hohe Interpretierbarkeit durch kausale Reaktionsmuster
- Natürliche Robustheit gegenüber extremem Sensorrauschen
Nachteile
- Hohe Rechenintensität beim anfänglichen Training durch ODE-Solver
- Schwierige Skalierung auf Milliarden von Parametern (wie bei LLMs)
- Mangel an hochgradig optimierten Frameworks in der Breite
Die nahtlose Implementierung eines solchen adaptiven Systems erfordert in der Praxis ein radikales Umdenken in der Software- und Architekturplanung. Es reicht definitiv nicht aus, einfach eine neue Open-Source-Bibliothek via Pip zu installieren und alten PyTorch-Code blind zu migrieren. Die Wahl des passenden numerischen Solvers für die Differentialgleichungen – etwa Euler, Heun oder komplexe Runge-Kutta-Verfahren – bestimmt direkt die Latenz und die Präzision des Modells auf der Zielhardware. In unseren komplexen Integrationsprojekten bei der AI-Software GmbH sehen wir sehr oft, dass Teams den initialen Rechenaufwand während des BPTT-Trainings massiv unterschätzen. Ein sauber orchestrierter, robuster State-Space-Ansatz ist hier zwingend erforderlich, um den Trainingsprozess überhaupt mathematisch stabil zu halten.
- 1
Problemdefinition und Datenstrukturierung: Zeitreihen- oder kontinuierliche Sensordaten als Input festlegen.
- 2
State-Space-Modellierung: Übersetzung der Systemdynamiken in ein set von gewöhnlichen Differentialgleichungen.
- 3
Solver-Auswahl: Entscheidung zwischen Rechengeschwindigkeit (z.B. Euler) und maximaler mathematischer Präzision (Runge-Kutta).
- 4
Closed-Loop-Training: Optimierung der zeitlichen Konstanten über Backpropagation Through Time (BPTT).
- 5
Edge-Deployment: Kompilierung des inferenzfähigen Liquid-Modells auf ressourcenbeschränkte Zielhardware (z.B. ARM Cortex, Nvidia Jetson).
So revolutionär und effizient Liquid Neural Networks auf IoT- und Edge-Geräten sein mögen, so schnell werden ihre Schwächen bei dem Versuch massiver Skalierung offensichtlich. Wer naiv versucht, ein allumfassendes Large Language Model (LLM) wie GPT-4 durch ein riesiges, reines LNN zu ersetzen, wird sehr abrupt an harte mathematische und physikalische Grenzen stoßen. Der Algorithmus der Backpropagation Through Time (BPTT), der zwingend über unzählige kontinuierliche Zeitschritte und Zustände zurückgerechnet werden muss, explodiert hinsichtlich seines Speicher- und Rechenbedarfs förmlich. Aktuell liegt das wirtschaftliche Sweet-Spot-Limit dieser Netzwerke im Bereich von einigen Tausend Neuronen, was für gigantische NLP-Aufgaben im Terabyte-Maßstab schlichtweg nicht ausreicht. LNNs sind geniale Spezialisten für zeitlich tief aufgelöste, dynamische Sensordaten, aber derzeit noch keine Generalisten für semantisches, allumfassendes Weltwissen.
Während moderne Transformer die Welt vor allem durch pure Parameter-Masse abbilden, verstehen Liquid Networks die physikalische Kausalität durch echte zeitliche Dynamik. Ihre Stärke liegt in der bedingungslosen Effizienz, nicht im blinden Gigantismus.
Für die technologische Roadmap der nächsten 12 bis 36 Monate prognostiziere ich als Stratege eine klare Zweiteilung und eine anschließende, sehr mächtige Verschmelzung im KI-Markt. Auf der einen Seite werden Milliarden-Parameter-Transformer-Modelle weiterhin hochskalierbar in der Cloud die schwere semantische und kognitive Arbeit verrichten. Auf der absolut anderen Seite werden Liquid Networks die technologische Dominanz im Bereich der Hardware-Sensorik, Industrierobotik und des massentauglichen Edge-Computings übernehmen. Wir werden in der Praxis zunehmend intelligente, hybride Architekturen sehen, bei denen ein LNN die extrem verrauschten Sensordaten in Echtzeit filtert, vorverarbeitet und stabilisiert, bevor ein effizienter Transformer die finale High-Level-Logik anwendet. Wer als CTO heute nicht aktiv beginnt, gezielte Prototypen für exakt solche performanten Mischsysteme zu bauen, wird in der nächsten anstehenden Welle der industriellen KI-Evolution schlichtweg rücksichtslos überrollt.
Branchen mit sofortigem LNN-Potenzial
- Automobilindustrie (Autonomes Fahren, LiDAR-Sensor-Fusion)
- Industrie 4.0 (Echtzeit-Predictive Maintenance an rotierenden Maschinen)
- Medizintechnik (Kontinuierliche EKG/EEG-Überwachung bei Signalrauschen)
- UAV & Robotik (Sichere Drohnennavigation unter extremen Wetterbedingungen)
Für mutige Entscheider, Produktmanager und ambitionierte CTOs bedeutet diese LNN-Revolution einen sehr konkreten Handlungsauftrag, der keinerlei Verzögerung mehr duldet. Evaluieren Sie Ihre historisch gewachsenen, bestehenden Machine-Learning-Pipelines gezielt und schonungslos auf teure Engpässe im Bereich der kontinuierlichen Anpassungsfähigkeit. Sobald Ihre statischen Modelle in der Produktionsumgebung durch Daten-Drift oder Sensorverschleiß messbar an echter Leistung verlieren, ist der Test eines Liquid-Network-Prototyps bereits wirtschaftlich hochgradig sinnvoll. Bei der AI-Software GmbH unterstützen wir methodisch exakt diesen tiefgreifenden Übergang, indem wir die technische Machbarkeit für Ihre hochspezifischen Hardware-Plattformen vorab verlässlich validieren. Der fundamentale Paradigmenwechsel von komplett statischen Gewichten hin zu dynamischer, fließender Intelligenz hat gerade erst ernsthaft begonnen – sichern Sie sich Ihren Wettbewerbsvorteil.
Starten Sie Ihr LNN-Pilotprojekt mit der AI-Software GmbH
Sind Ihre Systeme bereit für kontinuierliches Lernen? Die Experten der AI-Software GmbH analysieren Ihre bestehenden Edge-Architekturen und bauen maßgeschneiderte Liquid Neural Network Prototypen für Ihre spezifischen Use Cases. Kontaktieren Sie uns noch heute für ein erstes Strategiegespräch.
Projekt startenDouble-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.