
Llama 4: Der neue Open-Source-König und das Ende der proprietären KI-Dominanz
Metas Llama 4 greift nach der GPT-5-Krone. Erfahren Sie, warum das neue Open-Source-Modell den KI-Markt radikal umkrempelt und wie Unternehmen jetzt reagieren müssen.
Inhalt
Das Wichtigste in Kürze
- Open-Source zieht endgültig gleich: Llama 4 liefert Reasoning-Fähigkeiten auf GPT-5-Niveau und bricht das Monopol der großen Cloud-APIs.
- Nativ multimodal: Die Architektur verarbeitet Text, Bild und Audio vom ersten Layer an gemeinsam, was revolutionäre Enterprise-RAG-Systeme ermöglicht.
- Kommoditisierung des KI-Marktes: Der strategische Fokus verlagert sich vom Basismodell hin zu eigenen Daten, lokalen MLOps-Pipelines und nahtloser Workflow-Integration.
Die Ankündigung schlägt in der Tech-Welt ein wie ein Meteorit. Während die globale IT-Landschaft gebannt auf OpenAI und das sagenumwobene GPT-5 wartet, hat Meta mit Llama 4 die Spielregeln des gesamten Marktes stillschweigend neu geschrieben. Mit einem beispiellosen Trainingscluster von über 350.000 Nvidia H100 GPUs und einer grundlegend überarbeiteten, nativ multimodalen Architektur katapultiert Llama 4 quelloffene KI endgültig auf das Niveau der absoluten Elite. Für CTOs und Enterprise-Architekten bedeutet dieser Meilenstein weit mehr als nur ein technisches Update: Der systemische Zwang zur teuren Cloud-API-Abhängigkeit ist gebrochen, und die Ära der souveränen, lokal gehosteten Superintelligenz hat begonnen.
Der Paradigmenwechsel: Warum Llama 4 alles verändert
Llama 4 ist nicht einfach eine vorhersehbare Skalierung des ohnehin schon starken Vorgängers Llama 3.1. Wir analysieren hier einen fundamentalen Shift in der Art und Weise, wie Meta Foundation-Modelle konzipiert und trainiert. Durch den radikalen Wechsel von einer monolithischen Dense-Architektur zu einem hochgradig optimierten Mixture-of-Experts (MoE) Ansatz erreicht Llama 4 eine Parameter-Effizienz, die in der Open-Source-Historie ohne Beispiel ist. Das Flaggschiff-Modell der Familie, das sich im massiven Bereich von über einer Billion Parametern bewegt, aktiviert bei der Inferenz dynamisch nur einen isolierten Bruchteil des neuronalen Netzwerks. Das Resultat ist eine Performance, die geschlossene Systeme oftmals übertrifft, gepaart mit drastisch reduzierten Latenzzeiten pro generiertem Token. In unseren jüngsten Architektur-Audits bei der AI-Software GmbH konnten wir evaluieren, dass Llama 4 hochkomplexe Multi-Step-Reasoning-Aufgaben, die bisher exklusiv den kostenintensivsten API-Endpunkten vorbehalten waren, souverän und stabil auf lokaler Hardware löst. Diese Entkopplung von Intelligenz und externer Infrastruktur verändert die ROI-Kalkulation für KI-Projekte im Enterprise-Sektor grundlegend.
>350.000
Nvidia H100 GPUs im Training
512k
Native Context Window in Tokens
-45%
Inferenz-Latenz (vs. Llama 3.1 Dense)
Architektur und technische Meilensteine
Ein wesentliches, wenn nicht das entscheidende Differenzierungsmerkmal der neuen Generation ist das konsequent nativ multimodale Design. Bisherige Open-Source-Modelle nutzten in der Regel einen 'Late Fusion'-Ansatz, bei dem separate Vision- oder Audio-Encoder erst nachträglich an ein bereits vortrainiertes reines Sprachmodell angeflanscht wurden. Diese Brückenlösungen führten systematisch zu einem Informationsverlust an den Schnittstellen der Vektorräume. Llama 4 hingegen verarbeitet Text, hochauflösendes Bildmaterial, komplexe Audio-Wellenformen und potenziell sogar Video-Frames im selben hochdimensionalen latenten Raum von der allerersten Trainingsschicht an. Dieses architektonische Meisterstück ermöglicht dem Modell ein völlig neues, tiefes Verständnis räumlicher, visueller und zeitlicher Zusammenhänge, die weit über bloße Objekterkennung hinausgehen. Wenn Sie ein komplettes, einstündiges Architektur-Meeting als Video-Feed in den gewaltigen 512.000-Token-Kontext des Modells laden, generiert Llama 4 nicht nur ein perfektes Transkript, sondern versteht Nuancen in der Tonalität der Sprecher und korreliert diese mit den gezeigten Folien. Für die anspruchsvollen Retrieval-Augmented Generation (RAG) Systeme, die wir tagtäglich für unsere Enterprise-Kunden bauen, ist diese holistische Datenverarbeitung der ultimative Gamechanger.
Die VRAM-Illusion und der Hardware-Bedarf
Trotz der Effizienzgewinne durch das Mixture-of-Experts-Design dürfen wir uns als Ingenieure keinen Illusionen hingeben: Spitzen-KI benötigt nach wie vor massive Rechenkapazitäten. Das größte Derivat von Llama 4 stellt gewaltige Anforderungen an den Video RAM (VRAM). Ein unkomprimiertes Modell dieser Größenordnung passt nicht auf einen handelsüblichen Server. Es erfordert orchestrierte Multi-Node-Cluster, typischerweise ausgestattet mit 8x H100 oder vergleichbaren Beschleunigern, verbunden durch schnelles NVLink-Interconnect, um den Datenaustausch zwischen den Knoten ohne Flaschenhälse zu gewährleisten. Hier trennt sich in der Praxis oft die Spreu vom Weizen. Die rohe Bereitstellung der Infrastruktur ist nur der erste Schritt; die wahre Kunst liegt in der Optimierung des KV-Caches und der PagedAttention-Mechanismen, um hunderte parallele User-Sessions wirtschaftlich abzuarbeiten. Wer diese Hardware-Realität in der Planungsphase ignoriert, wird mit explodierenden Infrastrukturkosten oder inakzeptablen Latenzen für Endnutzer bestraft.
Achtung: Infrastruktur-Bottleneck
Planen Sie für das größte Llama-4-Modell in FP16-Präzision mindestens Terabytes an VRAM ein. Für Enterprise-Deployments ist die sofortige Evaluierung von 4-Bit oder 8-Bit Quantisierungsverfahren wie AWQ zwingend erforderlich, um Hardwarekosten in einem vertretbaren Rahmen zu halten.
Proprietär vs. Open Source: Der finale Showdown
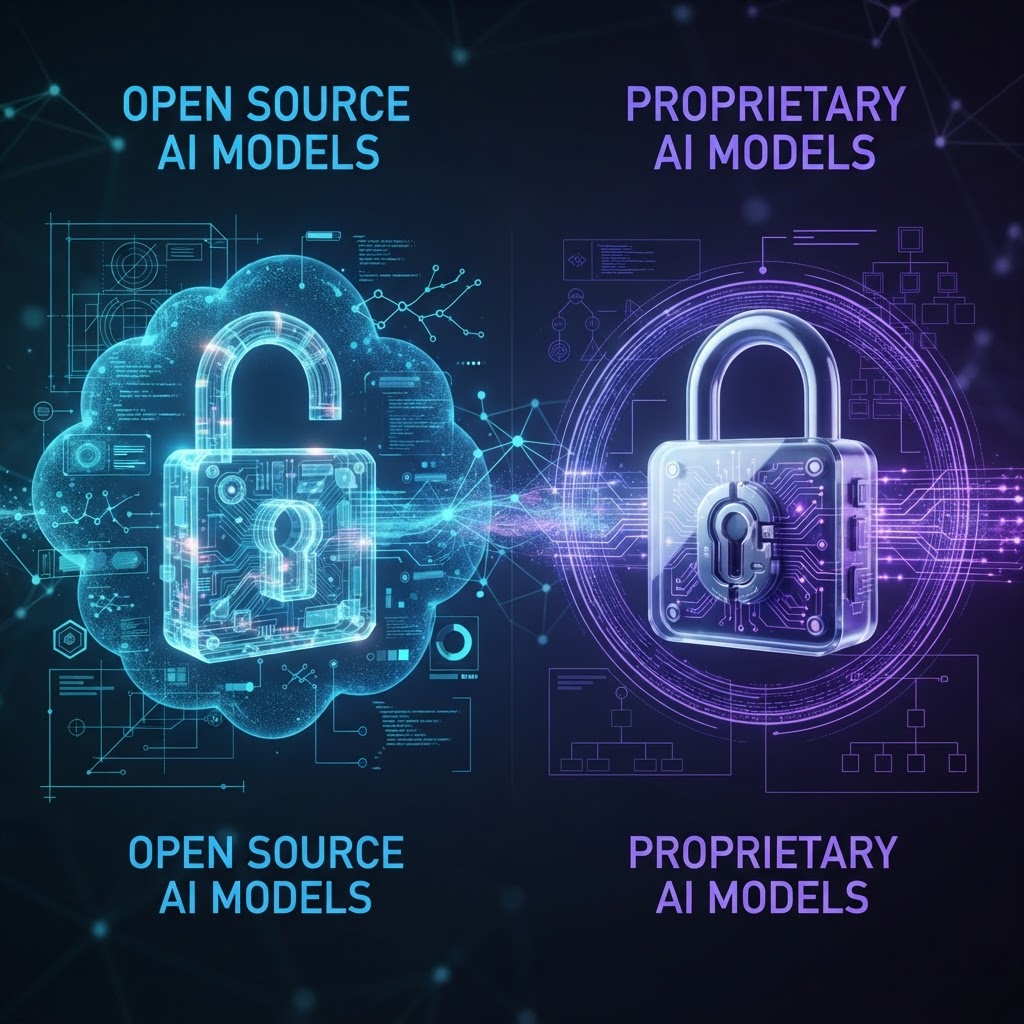
Betrachten wir das Ganze aus einer marktwirtschaftlichen Makro-Perspektive, vollzieht Meta mit der Veröffentlichung von Llama 4 einen brillanten, aggressiven Schachzug der Kommoditisierung. Indem Mark Zuckerberg ein Foundation-Modell, dessen reine Rechenzeit für das Training hunderte Millionen Dollar verschlungen hat, unter einer offenen Lizenz quasi verschenkt, zerstört er systematisch und kalkuliert die extrem hohen Margen im API-Geschäft seiner Hauptkonkurrenten. Warum sollte eine europäische Großbank, eine Versicherung oder ein Automobilhersteller weiterhin Millionenbudgets für Token-basierte Blackbox-APIs ausgeben und dabei hochsensible Kundendaten an Server in Übersee senden, wenn ein maßgeschneidertes Llama-4-Derivat im eigenen, ISO-zertifizierten Rechenzentrum identische oder gar fachspezifisch bessere Ergebnisse liefert? Die technologische Souveränität über die eigenen Daten und Algorithmen wird vom
Vorteile
- Absolute Datenhoheit und Compliance (On-Premise fähig)
- Keine laufenden Token-Kosten oder API-Vendor-Lock-ins
- Deep Fine-Tuning bis auf die tiefsten Architektur-Layer möglich
- Modellgewichte können für hochspezifische Edge-Cases eingefroren werden
Nachteile
- Signifikante initiale Kapitalbindung (Capex) für GPU-Hardware
- Tiefes MLOps- und Architekturwissen im eigenen Haus zwingend erforderlich
- Keine Service-Level-Agreements (SLAs) für die Modell-Ausgabe seitens Meta
Insider-Perspektive: Die Integration von Llama 4 in Enterprise-Systeme
In der harten Projektpraxis sehen wir bei der AI-Software GmbH jedoch regelmäßig, dass Unternehmen den vermeintlich einfachen Sprung zu mächtigen Open-Source-Modellen drastisch unterschätzen. Es reicht bei weitem nicht aus, Llama 4 rudimentär über Wrapper wie Ollama oder Standard-vLLM-Container zu starten und zu hoffen, dass sich die Magie von selbst entfaltet. Der Teufel steckt tief im technischen Detail: Schleichender Prompt-Drift zwischen Modell-Versionen, RoPE-Scaling-Artefakte, die bei extrem langen Kontexten die Aufmerksamkeit des Modells verzerren, und das eklatante Fehlen der etablierten Guardrails, die bei großen API-Anbietern unsichtbar im Hintergrund laufen, erfordern eine extrem robuste, selbstentwickelte MLOps-Pipeline. Wer Llama 4 ernsthaft in einem geschäftskritischen Umfeld in Produktion bringt, muss sich intensiv mit modernen Evaluierungs-Frameworks wie Ragas oder TruLens auseinandersetzen, um Phänomene wie Halluzinationen oder Grounding-Verluste systematisch und automatisiert zu messen. Die
Llama 4 ist nicht nur ein weiteres Modell-Update, es ist das Linux der generativen KI-Ära. Wer heute noch für seine strategischen Kernprozesse auf proprietäre APIs setzt, baut sein digitales Haus auf gemietetem Grund und gibt seine technologische Unabhängigkeit auf.
Best Practices für den sicheren Llama-4-Rollout
Der absolute Schlüssel zum messbaren Erfolg eines Llama-4-Rollouts liegt in der effizienten, hochverfügbaren Bereitstellung der Inferenz-Schicht. Als Spezialisten raten wir dringend davon ab, die gigantischen, unquantisierten FP16- oder BF16-Modelle für standardmäßige RAG-Anwendungen unreflektiert in die Produktion zu überführen. Durch den intelligenten Einsatz moderner Quantisierungsverfahren wie AWQ (Activation-aware Weight Quantization) oder den innovativen ExLlamaV2-Standards lassen sich die exorbitanten VRAM-Anforderungen um bis zu 60 Prozent komprimieren, ohne dass die statistische Perplexität oder die fachliche Antwortqualität spürbar degeneriert. Kombiniert man diese komprimierten Gewichte mit vLLM und kontinuierlichem Batching, erreichen wir Durchsätze, die selbst stark frequentierte, globale Web-Anwendungen völlig problemlos in Echtzeit bedienen können. Die wahre Architektur-Kunst liegt nun darin, aus der Modellfamilie präzise das richtige Derivat für den spezifischen Micro-Service zu orchestrieren: Ein rasend schnelles 8-Milliarden-Parameter Edge-Modell für vorgeschaltete Intent-Klassifizierungen und das massive Flaggschiff-Modell für tiefes, analytisches Reasoning tief im Backend.
- 1
Hardware-Audit & Topologie-Planung: Präzise Evaluierung des VRAM-Bedarfs, der Speicherbandbreite und der Skalierungsmöglichkeiten in einer Private Cloud oder On-Premise.
- 2
Modell-Selektion & Quantisierung: Datengestützte Auswahl der passenden Llama-4-Größe und sofortige Konvertierung der Gewichte in optimierte Formate wie AWQ oder GGUF.
- 3
Aufbau der High-Performance-Inferenz: Implementierung asynchroner, hochdurchsatzfähiger Serving-Engines wie vLLM, zwingend mit PagedAttention-Optimierung.
- 4
Multimodale RAG-Integration: Nahtlose Anbindung an leistungsstarke Vektor-Datenbanken und Anpassung der System-Prompts an die spezifische Instruktionssyntax von Llama 4.
- 5
Continuous Evaluation & Red Teaming: Etablierung vollautomatisierter Benchmark-Pipelines zur kontinuierlichen Überwachung der Antwortqualität und zur Erkennung von Sicherheitslücken.
Ein von vielen IT-Abteilungen chronisch unterschätzter Aspekt bei der Llama-4-Integration ist die semantische, feingranulare Datenaufbereitung vor der eigentlichen Inferenz. Selbst ein übermächtiges, trillionenschweres Modell wie Llama 4 kann und wird nur dann präzise, faktenbasierte Antworten liefern, wenn die zugrunde liegende Enterprise-Vektordatenbank von absolut makelloser Qualität ist. Garbage in, Garbage out bleibt das eherne Gesetz der KI-Entwicklung. Bei der AI-Software GmbH optimieren wir daher nicht nur isoliert die Inferenz-Parameter des Modells, sondern verbringen einen signifikanten Großteil der Projektzeit mit dem Aufbau kontextsensitiver Chunking-Strategien, dynamischer Metadaten-Filterung und ausgefeilter hybrider Suchverfahren. Ohne eine exzellente, perfekt strukturierte Datenbasis verpufft die immense kognitive Leistung von Llama 4 im komplexen Enterprise-Umfeld völlig wirkungslos, was fast immer zu Frustration bei den Endanwendern führt.
Marktausblick 2025-2027: Was CTOs jetzt konkret planen müssen
Blicken wir aus der Perspektive eines Strategen 12 bis 36 Monate in die Zukunft, ist absolut sicher, dass Llama 4 als brutaler Katalysator für eine beispiellose Konsolidierungswelle auf dem KI-Markt wirken wird. Kleinere API-Anbieter und Startups, deren gesamtes Geschäftsmodell lediglich darin besteht, einen minimalen Wrapper um große proprietäre Modelle anzubieten, werden schlichtweg weggespült. Stattdessen wird sich der Fokus der gesamten Industrie massiv auf sogenannte 'Agentic Workflows' verschieben. Llama 4 ist durch seine native Multimodalität und die gigantische Kontexterfassung absolut prädestiniert dafür, autonome KI-Agenten zu steuern, die über präzise Werkzeugaufrufe (Tool Calling) eigenständig komplexe, mehrstufige Prozesse in ERP-Systemen wie SAP oder Salesforce ausführen. Wir stehen an der Schwelle einer völlig neuen Ära, in der nicht länger die pure Intelligenz des isolierten Basismodells der limitierende Engpass ist, sondern ausschließlich die Fähigkeit und Agilität der Unternehmen, diese frei verfügbare Intelligenz tief, sicher und skalierbar in ihre historisch gewachsene Softwarearchitektur zu integrieren.
- Massiver interner Aufbau von MLOps-Kompetenzen für lokales Hosting und Fine-Tuning.
- Strategische Umstellung von rein textbasierten RAG-Systemen auf vollständig multimodale Pipelines.
- Strenge Auditierung und schrittweiser Abbau bestehender API-Abhängigkeiten zur Risikominimierung.
- Gezielte Investition in die Kuration proprietärer, hochspezifischer Datensätze, da diese den wahren Unternehmenswert darstellen.
Bereit für die Open-Source-Revolution in Ihrem Unternehmen?
Profitieren Sie von Llama 4 ohne die enormen technischen Hürden. Die Experten der AI-Software GmbH konzipieren, implementieren und betreiben hochsichere, lokal gehostete KI-Lösungen, die exakt auf Ihre Geschäftsprozesse zugeschnitten sind. Vereinbaren Sie heute noch ein unverbindliches Architektur-Audit und sichern Sie sich Ihre technologische Unabhängigkeit.
Projekt startenDouble-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.