NVIDIA Blackwell vs. Custom Silicon: Der asymmetrische Krieg um die KI-Hardware-Hegemonie
Während NVIDIA mit der Blackwell-Architektur die physikalischen Grenzen des Machbaren verschiebt, setzen Apple und Google auf radikale Spezialisierung. Eine tiefgehende Analyse, warum der Chip allein in Zukunft nicht mehr entscheidet.
Inhalt
Das Wichtigste in Kürze
- NVIDIA Blackwell (B200) zementiert die Dominanz im Training durch brachiale NVLink-5-Skalierung, erzwingt jedoch massive Umbauten der Rechenzentrum-Infrastruktur (Liquid Cooling, 120kW+ Racks).
- Google und Apple führen einen asymmetrischen Krieg: Google über optische Interconnects (TPU v5p) in Pod-Größe, Apple durch Unified Memory Architecture (UMA) am Edge.
- Der eigentliche Hardware-Krieg wird zukünftig in der Software gewonnen: Compiler-Technologien wie OpenAI Triton und PyTorch 2.0 weichen den CUDA-Burggraben auf.
- Für Enterprise-Infrastruktur verlagert sich der Fokus von maximaler PetaFLOPS-Zahl hin zu TCO, Inference-Optimierung (FP4) und Power Usage Effectiveness (PUE).
Als Software-Architekt mit über 15 Jahren Erfahrung in der Skalierung von KI-Systemen habe ich unzählige Hardware-Generationen kommen und gehen sehen. Doch der aktuelle Wendepunkt ist historisch: Wir befinden uns in einer Phase, in der Moore’s Law nicht mehr durch reine Miniaturisierung gerettet wird, sondern durch architektonische Brutalität auf der einen und elegante, hochspezialisierte Workload-Optimierung auf der anderen Seite. Während NVIDIA mit der Blackwell-Generation die physikalischen und energetischen Limits moderner Datacenter ausreizt, verfolgen Google mit seinen TPUs und Apple am Edge völlig andere Paradigmen. Für Entscheider und CTOs reicht es längst nicht mehr aus, nur die TeraFLOPS-Zahlen auf den Datenblättern zu vergleichen. Wer heute KI-Strategien ohne tiefes Verständnis für Speicherarchitekturen, Interconnect-Topologien und Compiler-Stacks plant, verbrennt Millionen.
Der Gigant schlägt zurück: NVIDIA Blackwell Architektur im Detail
NVIDIA hat mit der Blackwell-Architektur und dem B200-Chip nicht einfach nur die Taktfrequenzen erhöht, sondern ein technologisches Meisterwerk der Systemintegration geschaffen. Der Chip besteht aus unfassbaren 208 Milliarden Transistoren, die auf Basis von TSMCs 4NP-Prozess gefertigt werden, wobei zwei Reticle-Limit-Dies über ein 10 TB/s schnelles High Bandwidth Interface (NV-HBI) nahezu verlustfrei miteinander verschmolzen sind. Diese architektonische Entscheidung umgeht geschickt die physikalischen Grenzen der Chipherstellung und liefert eine massive Leistungssteigerung, ohne die Ausbeute (Yield) in der Fertigung drastisch zu senken. Ein zentraler Durchbruch für die KI-Inferenz ist dabei die native Unterstützung für 4-Bit-Gleitkommazahlen (FP4), welche den Speicherdurchsatz und die Rechenleistung gegenüber dem Vorgänger Hopper (FP8) effektiv verdoppelt. Wer als KI-Stratege glaubt, NVIDIA würde nur durch rohe Rechenkraft dominieren, übersieht die immense Ingenieurskunst hinter dieser extrem komplexen Chip-Topologie.
Die wahre Magie und der entscheidende Burggraben von NVIDIA verbergen sich jedoch nicht im Silizium des Rechenkerns, sondern im Interconnect. Mit der fünften Generation von NVLink ermöglicht NVIDIA eine bidirektionale Bandbreite von sagenhaften 1,8 TB/s pro GPU, was den limitierenden All-Reduce-Bottleneck beim Training massiver Sprachmodelle radikal minimiert. In der GB200 NVL72 Rack-Architektur können bis zu 576 GPUs als eine einzige riesige, kohärente Recheneinheit agieren, ohne dass Daten durch langsamere Ethernet- oder klassische Infiniband-Schichten müssen. Dies ist der fundamentale Grund, warum Hyperscaler trotz horrenden Hardwarekosten weiterhin zweistellige Milliardenbeträge in NVIDIA-Cluster pumpen. Andere Hersteller mögen auf dem Papier schnellere Einzelsysteme bauen, scheitern aber in der Praxis regelmäßig an der ineffizienten Skalierung über Tausende von Nodes.
208 Mrd.
Transistoren (B200)
1.8 TB/s
Bidirektionale NVLink-Bandbreite
20 PFLOPS
KI-Leistung (FP4) pro Chip
120 kW
Rack-Leistungsaufnahme (NVL72)
Custom Silicon: Die asymmetrische Kriegsführung von Google und Apple
Google spielt mit der TPU v5p (Tensor Processing Unit) ein völlig anderes strategisches Spiel und attackiert NVIDIA nicht beim direkten Chip-Verkauf, sondern auf der Infrastruktur-Ebene. Anstatt sich auf maximale Flexibilität für jede Art von neuronalem Netz zu fokussieren, sind TPUs kompromisslos auf Matrix-Multiplikationen für Transformer-Modelle hochgezüchtet. Das Geniale an Googles Ansatz ist der Einsatz von Optical Circuit Switches (OCS), einer Technologie, die physische Glasfaserverbindungen dynamisch durch Spiegel auf Rack-Ebene neu konfiguriert, um fehlerhafte Chips zu umgehen und die Netzwerktopologie im laufenden Betrieb an den jeweiligen Workload anzupassen. Ein TPU v5p Pod skaliert extrem effizient auf bis zu 8960 Chips und bietet eine unvergleichliche Netzwerkstabilität, die in der Praxis oft zu höheren Auslastungsraten (Utilization) führt als vergleichbare NVIDIA-Cluster. Google verkauft keine Chips – Google vermietet eine nahtlos orchestrierte, extrem kosteneffiziente Supercomputer-Plattform.
Auf der anderen Seite des Spektrums demontiert Apple die traditionelle Client-Server-Grenze im Edge-KI-Bereich mit einer völlig unterschätzten Waffe: der Unified Memory Architecture (UMA). Während eine 2.000 Euro teure NVIDIA RTX 4090 durch ihre 24 GB VRAM stark in der Größe der ausführbaren Large Language Models (LLMs) limitiert ist, bricht ein Mac Studio mit M4 Ultra oder M2 Ultra (bis zu 192 GB Unified Memory) diese Grenze spielend. CPU, GPU und die Neural Engine greifen mit einer Speicherbandbreite von bis zu 800 GB/s auf denselben Pool zu, ohne Daten kopieren zu müssen. Dies ermöglicht es Entwicklern und Forschern, massiv quantisierte 70B- oder gar 120B-Parameter-Modelle vollständig lokal zu inferieren – ein absoluter Gamechanger für Data-Privacy, Latenz und Kostenkontrolle am Rand des Netzwerks (Edge).
Die TCO-Illusion bei On-Premise-Clustern
Unterschätzen Sie niemals die Total Cost of Ownership (TCO) bei On-Premise-Hardware. Ein NVIDIA Blackwell Rack kostet nicht nur Millionen in der Anschaffung, sondern erfordert oft eine komplette Überarbeitung der Gebäudeinfrastruktur. Wer nicht im Voraus Liquid-Cooling-Kapazitäten und statische Bodenbelastbarkeiten prüft, bleibt auf unbrauchbarer Hardware sitzen.
Systemarchitektur: Warum der nackte Chip nur 20 % der Wahrheit ist
Die Branche fixiert sich gerne auf Teraflops und Transistoranzahl, doch in meinen KI-Projekten der letzten Jahre zeigt sich konstant: Der eigentliche Flaschenhals ist fast nie die reine Rechenleistung, sondern das Speichersystem und der Netzwerk-Stack. Wenn Hunderte von GPUs synchron trainieren, verpufft jegliche Rechenleistung, wenn die Gradienten-Updates im Netzwerk stecken bleiben. NVIDIAs Strategie, Mellanox zu übernehmen und Infiniband als De-facto-Standard tief in den eigenen Stack zu integrieren, war ein Meisterstück. Ein Konkurrent wie AMD muss nicht nur einen besseren Chip als den H100 oder B200 bauen, er muss das gesamte Ökosystem aus Netzwerk-Switches, Treibern (RoCEv2) und Topologie-Orchestrierung schlagen – eine Aufgabe, an der Konsortien wie das Ultra Ethernet Consortium derzeit hart, aber langsam arbeiten.
Ein oft übersehener Faktor von immenser Tragweite ist das Power Management auf Makro-Ebene, also im gesamten Rechenzentrum. Blackwell-Racks kratzen in Maximalauslastung an der 120-kW-Marke, was klassische Luftkühlung physikalisch unmöglich macht. Das führt zu einem beispiellosen Zweite-Ordnungs-Effekt: Rechenzentren werden nicht mehr dort gebaut, wo die Glasfaserleitungen am schnellsten sind, sondern dort, wo Strom aus dem Hochspannungsnetz oder direkten Nuklearquellen verlässlich und günstig verfügbar ist. Diese energetische Realität erzwingt für viele klassische Enterprise-Kunden den Schritt in die Cloud, da On-Premise-Modernisierungen für KI-Hardware schlichtweg unbezahlbar oder genehmigungsrechtlich blockiert werden.
Vorteile
- NVIDIA Blackwell: Unübertroffene Flexibilität für jede Art von Modell
- NVIDIA Blackwell: Perfekt integriertes CUDA-Ökosystem und Interconnects
- Google TPU: Höchste Effizienz und Skalierbarkeit für LLM-Training
- Apple Silicon: Sensationelles Preis-Leistungs-Verhältnis für lokale Edge-Inference
Nachteile
- NVIDIA Blackwell: Extreme Anschaffungskosten und Vendor-Lock-in
- NVIDIA Blackwell: Enormer Energie- und Kühlbedarf (Liquid Cooling Pflicht)
- Google TPU: Proprietär, keine On-Premise-Verfügbarkeit, Google-Cloud-Zwang
- Apple Silicon: Für verteiltes Training großer Foundation Models unbrauchbar
Der Software-Stack: Wie OpenAI Triton CUDAs Burggraben austrocknet
Für fast ein Jahrzehnt war CUDAs Dominanz unantastbar. Entwickler schrieben Kernel in CUDA, weil NVIDIAs Bibliotheken hochgradig optimiert und konkurrenzlos waren. Doch dieser unüberwindbare Burggraben beginnt, feine Risse zu zeigen. Initiativen wie PyTorch 2.0 (mit PT2 Compilation) und insbesondere OpenAI Triton abstrahieren die Hardware-Ebene radikal. Triton erlaubt es Entwicklern, hochperformante Custom-Kernel in Python zu schreiben, die von einem intelligenten Compiler in Maschinencode übersetzt werden – und zwar hardwareunabhängig. In unseren Projekten bei der AI-Software GmbH stellen wir zunehmend fest, dass Kundenmodelle, die früher streng an NVIDIA gebunden waren, heute mit minimalen Anpassungen auf AMDs ROCm-Stack oder auf Google TPUs (via JAX/XLA) migriert werden können. Wenn der Compiler intelligent genug ist, wird der Chip zur Commodity.
Hardware ist in der modernen KI-Ära nur so gut wie der Compiler, der die Tensor-Graphen orchestriert. Der Krieg um die Vorherrschaft wird längst nicht mehr in der Silizium-Fabrik, sondern auf Compiler-Ebene gewonnen.
Strategische Roadmap: Hardware-Entscheidungen für CTOs (2025-2027)
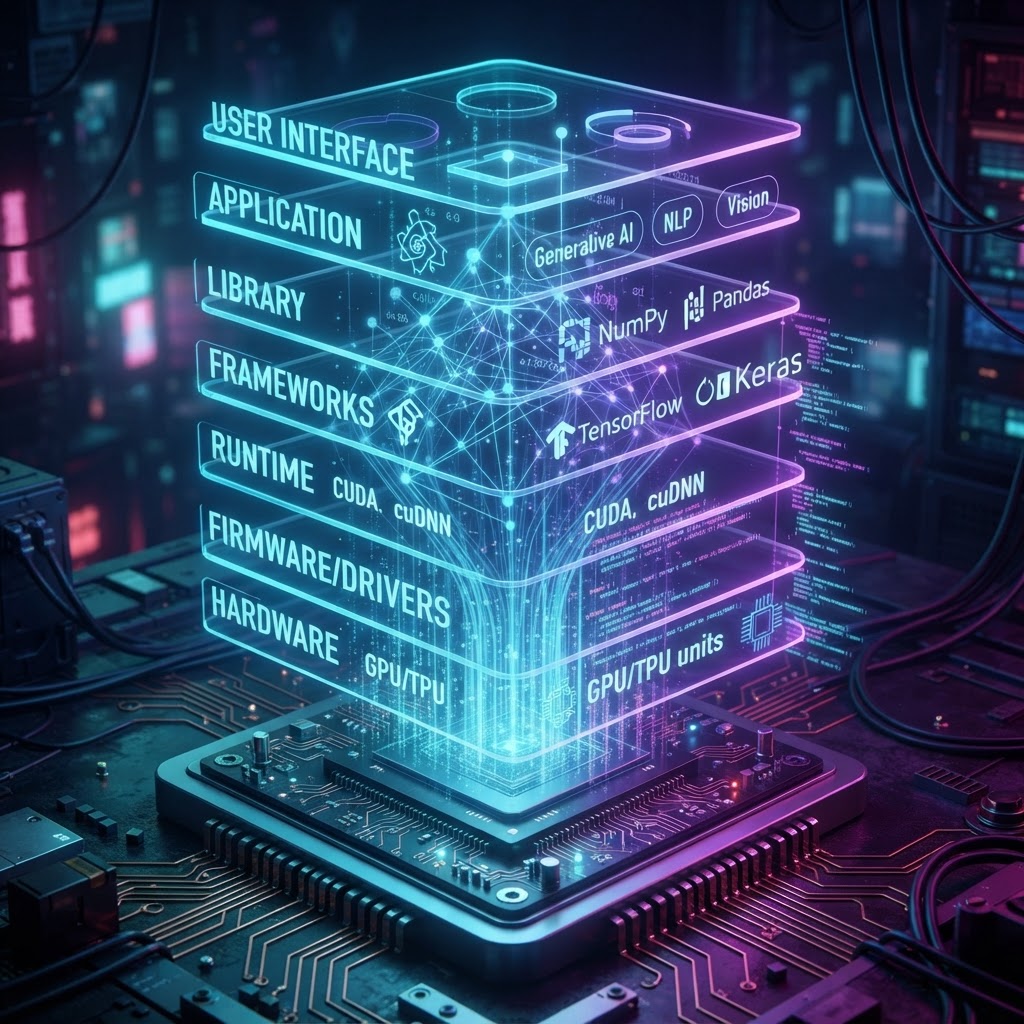
Die Evaluierung der optimalen Hardware-Infrastruktur hat sich fundamental gewandelt. Wir sehen einen massiven Shift von Trainings- hin zu Inference-Workloads. Während das Training von Foundation Models die Domäne von NVIDIA und Hyperscalern bleibt, verursacht die Inferenz im produktiven Dauerbetrieb über 80 % der TCO. Hier gewinnen plötzlich spezialisierte ASICs (Application-Specific Integrated Circuits) wie AWS Inferentia oder LPU-Architekturen (Language Processing Units) massiv an Bedeutung, da sie den Preis pro generiertem Token drastisch senken. CTOs dürfen nicht mehr den Fehler begehen, eine 'One-Size-Fits-All'-Strategie zu fahren. Der Schlüssel liegt in der Entkopplung: Teures Training in der Cloud auf H100/B200-Clustern, Kosteneffiziente Inferenz on-premise oder via Custom-ASICs, und lokales Finetuning auf Unified-Memory-Systemen.
- 1
Workload-Profilierung durchführen: Trennen Sie strikt zwischen Training, Finetuning (LoRA/QLoRA) und reiner Inferenz, um Überdimensionierung zu vermeiden.
- 2
Software-Unabhängigkeit sicherstellen: Setzen Sie auf Frameworks wie PyTorch 2.0 oder JAX, die stark hardware-abstrahierend wirken, um den Vendor-Lock-in zu brechen.
- 3
TCO-Vollkostenrechnung etablieren: Kalkulieren Sie neben den Chipkosten zwingend Kühlungsaufwand, Lizenzkosten (NVIDIA AI Enterprise) und Stromverbrauch über 36 Monate ein.
- 4
Edge-Potenziale evaluieren: Prüfen Sie, ob bestimmte Modelle durch Quantisierung auf Apple Silicon oder lokalen NPUs ohne Cloud-Latenz laufen können.
Fazit: Ein trifurkiertes Ökosystem
Der Markt der Jahre 2025 bis 2027 wird keine singuläre Hegemonie mehr aufweisen, sondern sich in drei hochspezialisierte Segmente aufspalten. Erstens: Die Hyperscaler, die eigene ASICs (TPU, Maia, Trainium) für interne Workloads nutzen und damit ihre Margen gegen NVIDIA verteidigen. Zweitens: Das Enterprise- und Forschungssegment, das aufgrund der überlegenen Flexibilität und des NVLink-Ökosystems tief im NVIDIA-Blackwell-Universum verankert bleibt. Drittens: Das rasante Wachstum am Edge, angetrieben von Apple Silicon und neuen NPUs, das KI aus dem Rechenzentrum zurück auf die lokalen Endgeräte holt. Als AI-Software GmbH haben wir unzählige Architektur-Entscheidungen begleitet und wissen: Der Gewinner ist nicht derjenige mit den meisten Teraflops, sondern das Unternehmen, das seine Hardware exakt auf die wirtschaftliche Realität seines KI-Use-Cases zuschneidet.
- Commoditisierung der Inference durch extrem spezialisierte Low-Power-ASICs.
- Die Kühlungs- und Stromversorgungsinfrastruktur wird zum limitierenden Faktor beim Bau neuer KI-Rechenzentren.
- Die Bedeutung von Open-Source-Compilern wächst rasant und bedroht NVIDIAs langjährige Software-Dominanz.
Sichern Sie sich Ihren strategischen KI-Vorteil
Die Hardware-Landschaft ist unübersichtlicher denn je, und architektonische Fehlentscheidungen kosten heute Millionen. Die Experten der AI-Software GmbH helfen Ihnen, TCO-Fallen zu vermeiden, den Vendor-Lock-in zu umgehen und maßgeschneiderte, zukunftssichere KI-Infrastrukturen zu designen. Lassen Sie uns über Ihren Use-Case sprechen.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.