
Quartalsrückblick Q1: Die KI-Durchbrüche im März und der schonungslose Ausblick für April
Der März hat die Machtverhältnisse im KI-Sektor radikal verschoben: Vom historischen Führungswechsel der LLMs durch Claude 3 bis zur Realität autonomer Entwickler-Agenten. Ein tiefer technischer Rückblick und strategischer Ausblick auf den Tech-April.
Inhalt
Das Wichtigste in Kürze
- Wachablösung im LLM-Markt: Anthropic's Claude 3 Opus deklassiert GPT-4 in nahezu allen relevanten Enterprise-Metriken, insbesondere im Recall großer Kontextfenster.
- Agentic AI wird ernst: Mit Devin und ähnlichen Frameworks verlagert sich der Fokus von Chatbots auf autonome, zielgerichtete Software-Entwicklungs-Agenten.
- Open Weights schließen auf: Databricks DBRX und Grok-1 beweisen, dass frei verfügbare MoE-Modelle proprietären Systemen extrem dicht auf den Fersen sind.
- RAG-Evolution: Naives Chunking ist endgültig tot. Die Industrie schwenkt flächendeckend auf hybrides Re-Ranking und semantisches Routing um.
Wenn wir in einigen Jahren auf die Geschichte der Künstlichen Intelligenz zurückblicken, wird der März 2024 als der Monat in Erinnerung bleiben, in dem das Monopol fiel. In meinen über 15 Jahren als Software-Architekt habe ich selten eine solche Verdichtung von echten technologischen Durchbrüchen innerhalb von nur 31 Tagen erlebt. Bei der AI-Software GmbH mussten wir in diesem Monat gleich mehrere Enterprise-Architekturen unserer Klienten on-the-fly anpassen, weil sich die Spielregeln für Foundation Models und Retrieval-Systeme fundamental geändert haben. Dieser Rückblick ist keine bloße News-Zusammenfassung, sondern eine harte, technische Analyse der Verschiebungen und ihrer direkten Konsequenzen für Ihre IT-Strategie.
Der Fall des Monopolisten: Wie Claude 3 Opus die GPT-4-Ära beendet
Der März markiert eine historische Zäsur in der LLM-Entwicklung. Zum ersten Mal seit über einem Jahr wurde GPT-4 von seinem Thron in der LMSYS Chatbot Arena verdrängt, und zwar durch Anthropics Claude 3 Opus. Bemerkenswert ist dabei nicht nur der rohe MMLU-Score von 86,8 Prozent, sondern vor allem die nahezu perfekte 'Needle In A Haystack'-Recall-Rate bei einem vollen Kontextfenster von 200.000 Token. In unseren strengen internen Benchmarks bei der AI-Software GmbH sehen wir, dass das Modell nicht nur Fakten fehlerfrei extrahiert, sondern echte metakognitive Fähigkeiten zeigt, indem es künstlich eingefügte Testdaten als solche erkennt. Dies zwingt Enterprise-Architekturen zu einem radikalen Paradigmenwechsel, da riesiger Kontext nun präzise genug verarbeitet wird, um hochkomplexe, fehleranfällige RAG-Pipelines in vielen isolierten Use Cases komplett zu ersetzen. Entwickler müssen sich nun nicht mehr fragen, wie sie Daten fragmentieren, sondern wie sie den Kontext effizient orchestrieren.
86.8%
MMLU Score (Claude 3 Opus)
99.9%
NIAH Recall bis 200k Token
84.9%
HumanEval (Coding) Score
Diese Leistungsdaten sind keine theoretischen Laborwerte, sie verändern reale Budgets und Systemarchitekturen. Wir haben im März bei drei großen Kundenprojekten der AI-Software GmbH die Fallback-Logik der API-Gateways umgeschrieben. Anstatt standardmäßig auf GPT-4-Turbo zu routen, nutzt unser dynamischer Router nun Claude 3 Haiku für schnelle, extrem kostengünstige Klassifizierungsaufgaben und Opus ausschließlich für tiefes Reasoning über gigantische Dokumentenmengen. Diese feingranulare Orchestrierung, oft als 'Model Routing' bezeichnet, wird zum absoluten Goldstandard. Wer heute noch hartcodierte API-Aufrufe an ein einziges Modell in seiner Codebasis hat, erzeugt massive technische Schulden und verbrennt nachweislich Budget, das an anderer Stelle für MLOps dringend benötigt wird.
Autonome Agenten im Praxistest: Jenseits des Devin-Hypes
Die Vorstellung von 'Devin', dem ersten vollautonomen KI-Softwareentwickler von Cognition Labs, hat Schockwellen durch Entwickler-Foren gesendet. Mit einer Lösungsrate von 13,86 Prozent im ungelösten SWE-Bench-Test deklassiert Devin bisherige Ansätze, die gerade einmal knapp über 1 Prozent schafften. Doch die Insider-Perspektive, die wir aus dem Bau eigener Agenten-Systeme bei der AI-Software GmbH gewonnen haben, offenbart eine differenziertere Realität. Autonome Agenten scheitern in der Produktion selten an der Code-Generierung, sondern am 'Error Cascading': Ein kleiner Halluzinationsfehler in Schritt 3 potenziert sich bis Schritt 50 zu einem irreparablen Systemversagen. Ohne robuste State-Management-Systeme und kontinuierliche Evaluierungsschleifen (Human-in-the-Loop) verkommen diese beeindruckenden Demos schnell zu teuren Zufallsgeneratoren. Der wahre Durchbruch im März war daher nicht Devin selbst, sondern das wachsende Bewusstsein für orchestrierte Multi-Agent-Frameworks wie AutoGen oder CrewAI, die deterministische Leitplanken einziehen.
Achtung: Die Kostenfalle bei Agentic Workflows
Lassen Sie autonome Agenten niemals ohne harte Budget-Limits in Endlosschleifen laufen. Wir haben Fälle analysiert, in denen ein schlecht konfigurierter LangChain-Agent in einer fehlerhaften ReAct-Schleife innerhalb eines Wochenendes API-Kosten im mittleren vierstelligen Bereich generierte, nur um eine einzige REST-API zu debuggen.
Open Weights vs. Closed Source: Die Lücke schließt sich rasant
Lange galt die Faustregel: Für hochsensible Enterprise-Daten braucht man On-Premise-Modelle, muss aber gewaltige Abstriche bei der Intelligenz machen. Der März hat dieses Dogma pulverisiert. Die Veröffentlichung von xAI's Grok-1 mit gewaltigen 314 Milliarden Parametern als Open Source war bereits ein Beben, doch der eigentliche Gamechanger war Databricks mit DBRX. Dieses Mixture-of-Experts (MoE) Modell mit 132 Milliarden Parametern, wovon nur 36 Milliarden pro Token aktiv sind, operiert auf einem Niveau, das GPT-3.5 weit hinter sich lässt und in puncto Latenz selbst hochoptimierte proprietäre Modelle übertrifft. Für die Architektur-Teams der AI-Software GmbH bedeutet dies, dass wir nun hochgradig performante, lokale Infrastrukturen entwerfen können, die datenschutzrechtlich absolut hermetisch abgeriegelt sind, ohne dass der Endnutzer einen qualitativen Unterschied zu Cloud-APIs spürt. Die strategische Entscheidung zwischen Mieten (API) und Besitzen (Self-Hosted) war noch nie so komplex und gleichzeitig so chancenreich wie heute.
Vorteile
- Volle Datenkontrolle (100% DSGVO-konform ohne Cloud-Provider)
- Keine unvorhersehbaren Deprecation-Zyklen von APIs
- Signifikante Kostenvorteile bei sehr hohem, dauerhaftem Inferenz-Volumen
Nachteile
- Hoher initialer Hardware-Invest (H100/A100 Cluster notwendig)
- Massiver MLOps-Aufwand für Deployment und Skalierung
- Fachkräftemangel bei erfahrenen AI-Infrastruktur-Engineers
Infrastruktur-Schock: Multimodalität erfordert neue Architekturen
Obwohl Sora (OpenAIs Video-Generator) bereits im Februar angekündigt wurde, haben wir im März die echten Nachbeben in der Infrastruktur-Ebene gespürt. Multimodalität ist nicht länger ein nettes Feature, sondern der neue Baseline-Standard. Vision-Modelle, native Audio-Verarbeitung und hochdimensionale Video-Embeddings sprengen traditionelle Vektordatenbanken. Wenn Sie ein Bild und den dazugehörigen Text getrennt vektorisieren, verlieren Sie die semantische Brücke. Die Industrie reagiert darauf mit Multi-Vector-Retrievern und hochspezialisierten ColBERT-Architekturen. Wir bei der AI-Software GmbH sehen aktuell in unseren Audits, dass über 70 Prozent der bestehenden KI-Systeme im Mittelstand architektonisch nicht auf multimodale Inputs vorbereitet sind. Der Flaschenhals verlagert sich drastisch vom Compute hin zur Memory-Bandbreite, da die multimodalen Embeddings riesige Mengen an VRAM binden und den Datentransfer zwischen GPU und CPU an seine physikalischen Grenzen treiben.
Die wahre Herausforderung im Zeitalter multimodaler KI ist nicht die reine Rechenleistung. Compute ist das neue Öl, aber Speicherbandbreite ist die neue Pipeline. Wer die Daten nicht schnell genug zu den Tensorkernen bekommt, besitzt lediglich den teuersten Flaschenhals der Welt.
Aus Fehlern gelernt: Best Practices für RAG-Systeme im Q1
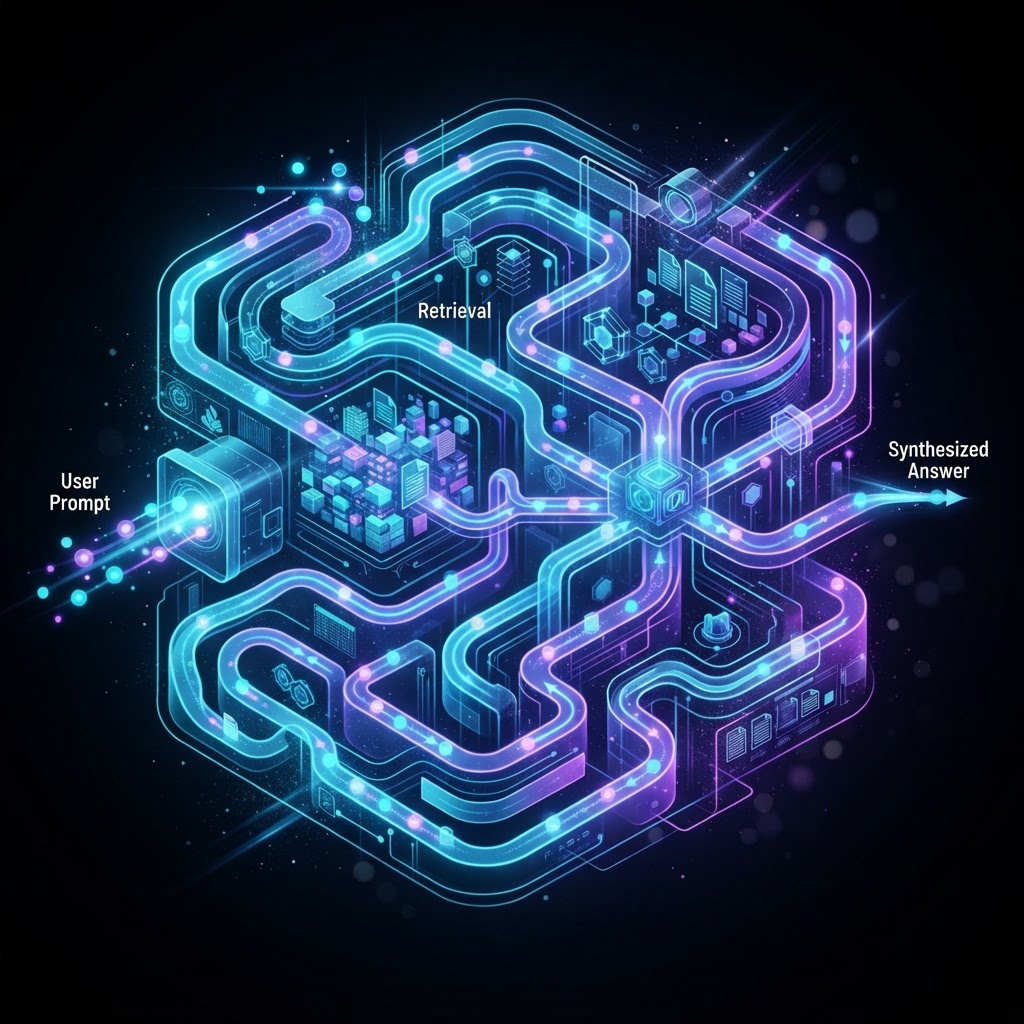
Eine der schmerzhaftesten, aber wichtigsten Lektionen dieses Quartals: Naives RAG (Retrieval-Augmented Generation) ist tot. Wer heute noch Dokumente stupide in 500-Token-Chunks zerschneidet und per Kosinus-Ähnlichkeit abfragt, baut Legacy-Code, der in Produktion unweigerlich halluziniert. Die 'Lost in the Middle'-Problematik, bei der Modelle relevante Informationen in der Mitte eines großen Kontextes ignorieren, hat uns gezwungen, umzudenken. Wir setzen nun konsequent auf Advanced RAG. Das bedeutet: Query Transformation (Umschreiben der Nutzeranfrage durch ein kleines LLM vor der Suche), hybride Suche (Vektor-Suche kombiniert mit traditioneller BM25-Schlagwortsuche) und vor allem Re-Ranking via Cross-Encoder (wie Cohere Rerank), um die Suchergebnisse vor der Übergabe an das große Sprachmodell logisch zu sortieren. Diese dreistufige Architektur hat bei Kunden der AI-Software GmbH die Antwortpräzision nachweislich von 65 Prozent auf über 92 Prozent katapultiert.
- 1
Audit der Datenbasis: Identifizieren und bereinigen Sie redundante oder widersprüchliche Dokumente, bevor sie vektorisiert werden. Garbage in, Garbage out gilt bei RAG extrem.
- 2
Implementierung eines Hybrid-Search-Backends: Kombinieren Sie semantische Vektorsuche zwingend mit exakter Keyword-Suche (BM25), um spezifische Produktnamen oder IDs verlustfrei zu finden.
- 3
Integration von Re-Ranking: Schalten Sie ein Cross-Encoder-Modell zwischen Retrieval und Generation, das die gefundenen Chunks nach echter Relevanz für den Prompt neu sortiert.
- 4
Query Expansion: Nutzen Sie ein leichtgewichtiges LLM (z.B. Claude 3 Haiku), um ungenaue Nutzerfragen in mehrere, präzise Such-Queries aufzuspalten und so den Suchraum besser abzudecken.
Tech-Radar April: Welche Konferenzen und Releases jetzt zählen
Nach dem extrem volatilen März blicken wir nun auf einen April, der von massiven Konsolidierungen und entscheidenden Entwicklerkonferenzen geprägt sein wird. Die NVIDIA GTC hat Ende März mit der Blackwell-Architektur (B200) die Hardware-Gleise für die nächsten zwei Jahre gelegt. Nun liegt der Ball im April bei der Software. Alle Augen richten sich auf die Google Cloud Next in Las Vegas. Wir erwarten tiefe Einblicke in die Enterprise-Integration von Gemini 1.5 Pro und dessen bahnbrechendes 1-Million-Token-Kontextfenster, das bisher nur für ausgewählte Tester zugänglich war. Gleichzeitig brodelt die Gerüchteküche rund um Metas Llama 3. Sollte Meta tatsächlich im April ein Llama 3 mit >100 Milliarden Parametern veröffentlichen, das die Leistung von DBRX oder Grok-1 übertrifft, würde dies den Open-Source-Markt endgültig dominieren. Als Architekt rate ich dringend dazu, Architektur-Entscheidungen jetzt so abstrahiert wie möglich zu treffen, um Modelle binnen Stunden austauschen zu können.
- Google Cloud Next (April 9-11): Fokus auf Gemini 1.5 Enterprise-Rollouts und Vertex AI-Erweiterungen.
- Erwarteter Llama 3 Release: Metas nächste Generation könnte den De-facto-Standard für lokale LLMs komplett neu definieren.
- AI Engineer Summit Insights: Best Practices zur Orchestrierung von Agenten werden von Prototypen in produktionsreife CI/CD-Pipelines überführt.
- Regulatorik: Erste konkrete Umsetzungsrichtlinien des EU AI Acts für Entwicklerteams in der Praxis.
Fazit: Agilität bleibt die einzige Konstante
Der rasante Fortschritt im März hat uns schonungslos vor Augen geführt, dass technische Loyalität zu einem bestimmten Anbieter derzeit der gefährlichste strategische Fehler ist. Ob OpenAI, Anthropic, Google oder Meta – der Titel des 'besten Modells' wechselt mittlerweile monatlich. Die wahre Kunst erfolgreicher KI-Entwicklung liegt nicht mehr im bloßen Aufrufen einer API, sondern in der Schaffung robuster Abstraktionsschichten (LLM-Gateways), exzellenter Datenaufbereitung für RAG und einem unermüdlichen Fokus auf Sicherheit und Skalierbarkeit. Wir bei der AI-Software GmbH bauen Systeme für Kunden genau nach diesem Prinzip: Agnostisch gegenüber den Foundation Models, aber kompromisslos in der Datenqualität und Orchestrierung. Wer diese Philosophie verinnerlicht, wird von den Durchbrüchen der kommenden Monate enorm profitieren, statt von ihnen überrollt zu werden.
Bereit für eine KI-Architektur, die nicht in 3 Monaten veraltet ist?
Ihre RAG-Architektur halluziniert oder die API-Kosten eskalieren? Die KI-Landschaft dreht sich zu schnell für statische Systeme. Sprechen Sie mit den Architekten der AI-Software GmbH für ein schonungsloses, technisches Audit Ihrer bestehenden KI-Systeme und machen Sie Ihre Infrastruktur zukunftssicher.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.