Refactoring von Legacy-Code mit KI: Architekturen von gestern in die Zukunft überführen
Erfahren Sie, wie moderne KI-Tools und LLMs dabei helfen, jahrzehntealte Code-Basen sicher zu modernisieren, technische Schulden massiv zu reduzieren und Refactoring-Prozesse fundamental zu beschleunigen.
Inhalt
Das Wichtigste in Kürze
- KI-Refactoring ist kein simpler Code-Austausch, sondern erfordert tiefes semantisches Verständnis durch RAG-Architekturen.
- Test-Driven AI-Refactoring (TDAIR) ist der einzige Weg, stochastische Halluzinationen in geschäftskritischen Systemen zu bändigen.
- Proprietäres 'Tribal Knowledge' muss zwingend vektorisiert werden, um dem LLM den notwendigen Kontext für Architektur-Entscheidungen zu geben.
- Die Entwicklerproduktivität verschiebt sich von reiner Code-Erstellung hin zu Architektur-Review und Prompt-Engineering.
Wir stehen vor einem historischen Wendepunkt im Software-Engineering. Die Ära, in der Teams von Entwicklern jahrelang manuell und fehleranfällig gewachsene Monolithen entwirren mussten, nähert sich ihrem Ende. Moderne Große Sprachmodelle (LLMs) sind heute nicht mehr nur glorifizierte Autocomplete-Werkzeuge, sondern fungieren als semantische Brückenbauer zwischen jahrzehntealtem Legacy-Code und modernsten Cloud-nativen Architekturen. Doch wer glaubt, KI würde die Modernisierung per Knopfdruck erledigen, tappt in eine kostspielige Falle. Als erfahrener Architekt der AI-Software GmbH zeige ich Ihnen die Realität jenseits des Hypes: Harte Best Practices, messbare Metriken und die wahren Fallstricke bei der KI-gestützten Transformation.
Die unsichtbare Billionen-Dollar-Krise: Technische Schulden im Jahr 2024
Wir sitzen in der IT-Industrie auf einem gigantischen Pulverfass aus veraltetem Code. Laut den aktuellen Erhebungen des Consortium for IT Software Quality (CISQ) beliefen sich die Kosten für schlechte Softwarequalität und technische Schulden allein in den USA zuletzt auf astronomische 2,41 Billionen US-Dollar. Historisch gewachsene Monolithen, die in veralteten Versionen von Java, PHP oder im Bankensektor gar in COBOL geschrieben wurden, binden heute in durchschnittlichen Enterprise-Unternehmen über 70 Prozent der wertvollen Entwicklerressourcen für reine Wartungsarbeiten. Jeder Versuch, diese massiven Systeme manuell in eine moderne Microservices-Architektur zu überführen, scheitert in der Praxis fast immer an undokumentierten Abhängigkeiten und verlorenem 'Tribal Knowledge', da die ursprünglichen Entwickler das Unternehmen längst verlassen haben. Die bloße Existenz dieser Code-Grabstätten stellt in einem hochdynamischen, agilen Marktumfeld nicht nur ein technisches, sondern ein massives geschäftliches Risiko dar, das durch traditionelle, manuelle Refactoring-Methoden schlichtweg nicht mehr zeitgerecht zu bewältigen ist.
Ein gravierendes Problem dabei ist die sogenannte 'Spaghetti-Code-Starre'. Wenn Geschäftslogik, Datenbankzugriffe und Benutzeroberfläche über Jahrzehnte ohne klare Abstraktionsschichten miteinander verwoben wurden, wird jede noch so kleine Änderung zu einer potenziellen Fehlerquelle mit unvorhersehbaren Kaskadeneffekten. Traditionelle Code-Analyse-Tools, die lediglich auf statischen Patterns oder Abstract Syntax Trees (AST) basieren, scheitern an der fehlenden semantischen Bedeutung hinter den wirren Variablen- und Funktionsnamen früherer Entwickler-Generationen. Genau hier entfalten moderne KI-Modelle ihr wahres, transformatives Potenzial, indem sie nicht nur die Syntax, sondern den tatsächlichen Sinn und Zweck des Codes im systemischen Kontext verstehen können.
$2.41T
Kosten tech. Schulden (US)
70%
Ressourcen für Wartung
45%
Schnelleres Refactoring mit KI
Paradigma-Wechsel: KI als Semantischer Entschlüssler
Bisherige Refactoring-Ansätze funktionierten rein mechanisch, doch KI bringt die Semantik zurück ins Engineering. Modelle der neuesten Generation wie Claude 3.5 Sonnet oder GPT-4o glänzen nicht primär durch das Schreiben neuen Codes, sondern durch ihre beispiellose Fähigkeit, bestehenden Code zu abstrahieren. Mit Kontextfenstern von bis zu 2 Millionen Token ist es heute technisch möglich, gesamte Repositories mittlerer Größe in den Arbeitsspeicher des Modells zu laden. Das KI-System kann dadurch Querbezüge erkennen, die für das menschliche Auge in tausenden Dateien verborgen bleiben. So identifiziert die KI beispielsweise fehlerhafte Singleton-Patterns, versteckte Zyklen in der Abhängigkeitsinjektion oder obsolete Workarounds, die vor zehn Jahren für einen längst behobenen Datenbank-Bug implementiert wurden.
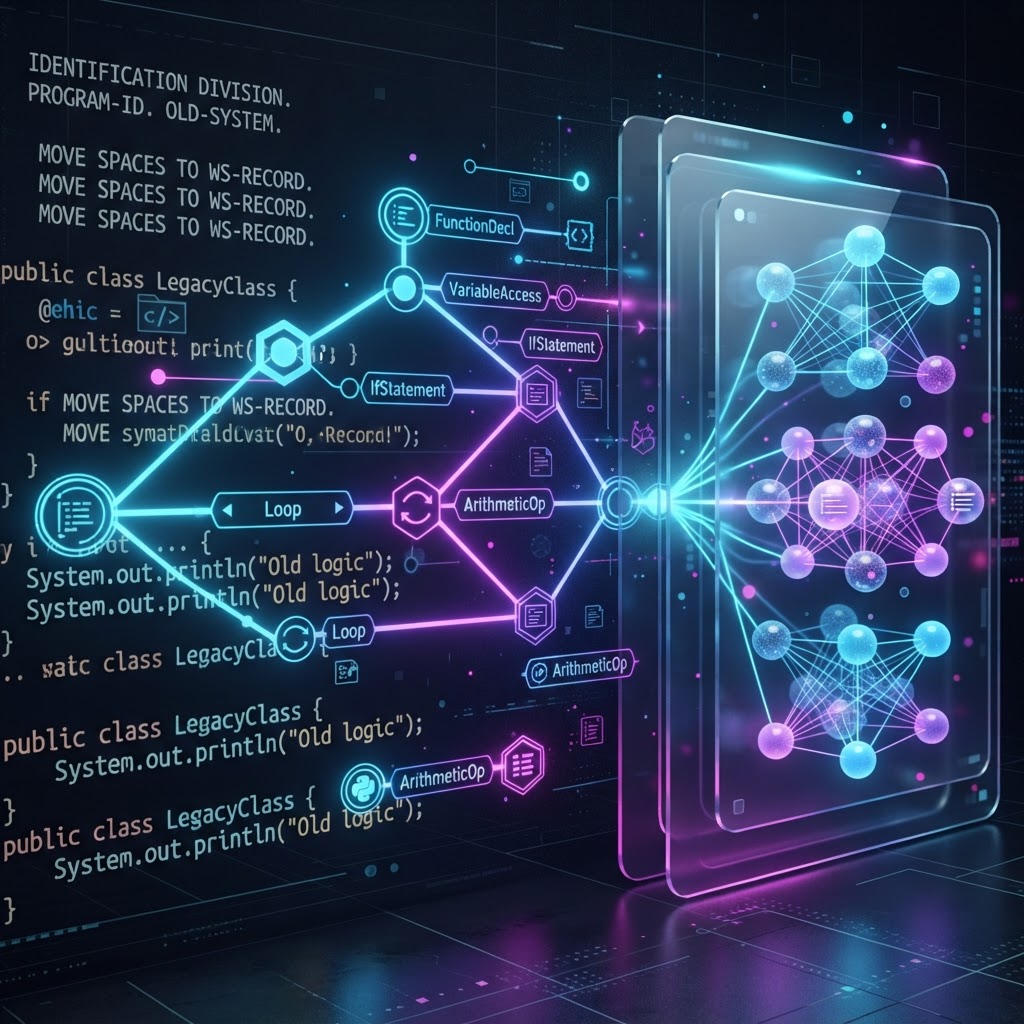
Um diese Leistung in großen Enterprise-Systemen abzurufen, reicht ein simples Kopieren in ein Chatfenster jedoch längst nicht aus. Die Speerspitze der AI-Software GmbH nutzt hochentwickelte Retrieval-Augmented Generation (RAG) Architekturen für Code. Hierbei wird die gesamte Legacy-Codebasis zunächst über AST-Parser in logische Fragmente zerlegt, vektorial eingebettet und in speziellen Vektordatenbanken gespeichert. Wenn ein Entwickler nun einen bestimmten Service modernisieren will, zieht das RAG-System deterministisch exakt die Code-Snippets, Architektur-Dokumente und Jira-Tickets heran, die für diesen spezifischen Bounded Context relevant sind. Dieser Ansatz eliminiert das Rauschen und zwingt das Sprachmodell zu einer hochpräzisen, faktenbasierten Code-Analyse.
Halluzinationen in geschäftskritischen Legacy-Kontexten
Proprietäre Legacy-Systeme enthalten oft geschäftsspezifische Logik, die in den Trainingsdaten der LLMs nicht existiert. Ohne eine saubere RAG-Implementierung neigen Modelle dazu, fehlenden Kontext durch plausible, aber technisch katastrophale Halluzinationen aufzufüllen. Vertrauen Sie niemals einem initialen Architektur-Vorschlag der KI ohne tiefe Verifizierung.
Tooling-Ökosystem 2024: Jenseits von simplen Autocompletes
Der Markt für KI-gestützte Entwicklertools hat sich rasant diversifiziert, und wer heute noch ausschließlich auf einfache Inline-Vervollständigung setzt, verliert den Anschluss. GitHub Copilot Enterprise ist zweifellos der Marktführer für die alltägliche Entwicklerproduktivität und das Schreiben von Boilerplate-Code, stößt aber bei tiefgreifenden architektonischen Refactorings schnell an seine Grenzen. Für echte Code-Modernisierung benötigen wir Werkzeuge, die Agenten-basiert agieren und den vollständigen Code-Kontext indexieren. Tools wie Cursor, kombiniert mit dem Claude 3.5 Sonnet Modell, haben sich in unseren internen Benchmarks bei der AI-Software GmbH als absoluter Gamechanger erwiesen, da sie es erlauben, über natürliche Sprache weitreichende Refactoring-Befehle ('Extrahiere diese Logik in einen Service und passe alle Aufrufer an') präzise und dateiübergreifend auszuführen.
Parallel dazu etablieren sich spezialisierte Plattformen wie Sourcegraph Cody oder Codeium, die speziell darauf trainiert sind, extrem große Enterprise-Codebasen zu durchdringen. Für hochsensible Umgebungen, in denen Quellcode das Firmennetzwerk unter keinen Umständen verlassen darf, greifen wir zunehmend auf lokal gehostete, feinabgestimmte Open-Source-Modelle wie DeepSeek Coder V2 oder Llama-3-basierten Derivaten zurück. Diese Modelle werden lokal auf dedizierter GPU-Hardware betrieben und mit internen Coding-Guidelines der Unternehmen nachtrainiert. So garantieren wir nicht nur absolute Datensicherheit, sondern sorgen auch dafür, dass die KI bei der Modernisierung automatisch die spezifischen Naming-Conventions und Architektur-Muster des Kunden adaptiert.
Refactoring mit KI bedeutet nicht, dass die Maschine eigenmächtig den Code neu schreibt. Sie kartografiert das Chaos, isoliert hochkomplexe Abhängigkeiten und schlägt saubere, moderne Schnittstellen vor – aber der erfahrene menschliche Architekt bleibt stets am Steuer und lenkt die Transformation.
Der AI-Augmented Refactoring Workflow in der Praxis
Ein erfolgreiches Refactoring-Projekt mit KI-Beteiligung folgt einem rigorosen, asymmetrischen Prozess, den wir als Test-Driven AI-Refactoring (TDAIR) bezeichnen. Da LLMs probabilistische Engines sind, produzieren sie bei identischen Prompts unterschiedliche Ergebnisse. Um diese stochastische Natur in deterministische Softwarequalität zu überführen, drehen wir den klassischen Prozess um: Wir nutzen die KI im ersten Schritt nicht, um den Code neu zu schreiben, sondern um wasserdichte Tests für den unaufgeräumten Legacy-Code zu generieren. Die KI analysiert die alte Funktion, extrahiert alle denkbaren Edge-Cases und generiert eine umfassende Test-Suite, die das historische, gewachsene Verhalten des Systems als Baseline fixiert. Erst wenn diese Tests zu 100 Prozent grün sind, beginnt der eigentliche Umbau.
- 1
KI-gestützte Architektur-Analyse: Generierung von Abhängigkeitsgraphen und Identifikation von Bounded Contexts im Legacy-Monolithen.
- 2
Test-Suite Synthese: Das LLM generiert vollständige Unit- und Integrationstests, um das aktuelle Systemverhalten als unumstößliche Baseline festzuschreiben.
- 3
Code-Translation & Isolierung: Überführung veralteter Konstrukte (z.B. monolithische Callbacks) in moderne Paradigmen (z.B. asynchrone Microservices) mittels gezielter Prompts.
- 4
Strangler Fig Integration: KI generiert die Proxy-Schicht, um Traffic nahtlos vom alten Modul auf die neue, isolierte Architektur umzuleiten.
- 5
Automatisierte Code-Reviews: Ein sekundäres LLM prüft den generierten Code auf Sicherheitslücken und Performance-Antipatterns.
Durch die Kombination dieses Workflows mit etablierten Mustern wie dem Strangler-Fig-Pattern reduzieren wir das Risiko von Regressionen gegen null. Das KI-System hilft uns dabei, den alten Code-Pfad und den neuen, refaktorisierten Pfad parallel laufen zu lassen, während die KI gleichzeitig die Proxy-Logik schreibt, die die Ergebnisse beider Pfade vergleicht (Shadowing). Dieses Verfahren ermöglicht es uns bei der AI-Software GmbH, geschäftskritische Systeme im laufenden Betrieb, quasi am offenen Herzen, zu modernisieren, ohne dass es zu Ausfallzeiten oder Datenkorruption kommt. Die KI übernimmt die massenhafte Fleißarbeit der Boilerplate-Generierung, während sich die Senior-Entwickler auf die Feinheiten der Domänenlogik konzentrieren können.
Die ungeschminkte Wahrheit: Trade-offs beim KI-Refactoring
Ein blinder Fleck vieler CTOs ist die naive Annahme, der Einsatz von KI würde die Entwicklerzeit linear im Verhältnis 1:1 einsparen. In der Realität des Enterprise-Umfelds verschieben sich die Kosten und Aufwände lediglich in andere Phasen des Lebenszyklus. Während die reine Tippgeschwindigkeit und Code-Erstellung um Faktoren von 10x bis 50x beschleunigt werden, steigt der Aufwand für extrem sorgfältige Code-Reviews, fortgeschrittenes Prompt-Engineering und die Orchestrierung der generierten Module drastisch an. Wer ein Team von Junior-Entwicklern mit KI bewaffnet und sie ohne strikte Senior-Überwachung auf einen Legacy-Monolithen loslässt, beschleunigt nicht die Modernisierung, sondern potenziert lediglich die Generierung von architektonischem Müll in Rekordgeschwindigkeit.
Vorteile
- Massive Beschleunigung bei der Entschlüsselung von undokumentiertem Code und Boilerplate-Generierung.
- Automatisiertes Aufdecken von versteckten Abhängigkeiten durch kontext-übergreifende RAG-Analysen.
- Dramatische Reduktion von trivialen Tippfehlern und schnelle Übersetzung zwischen verschiedenen Programmiersprachen.
Nachteile
- Erhöhter Review-Aufwand zwingt Entwickler in die Rolle von Code-Inspektoren, was kognitiv enorm anspruchsvoll ist.
- Gefahr von 'Plausible Bullshit', bei dem fehlerhafter Code durch die KI extrem überzeugend argumentiert wird.
- Schleichender Verlust der tiefen Code-Kenntnis ('Brain Drain') im Entwicklerteam bei zu hohem Vertrauen in die KI.
Täglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.