
Vom Prompting zum Fine-Tuning: Warum der Hype um RAG endet und die Ära der Small Language Models (SLMs) beginnt
Prompt-Engineering skaliert nicht auf Enterprise-Niveau. Erfahren Sie, ab welchem Punkt das Fine-Tuning eigener Small Language Models (SLMs) die einzige wirtschaftliche und performante Lösung für Unternehmen ist.
Inhalt
Das Wichtigste in Kürze
- Prompt-Engineering und RAG sind für Rapid Prototyping essenziell, skalieren in hochvolumigen Systemen aber wirtschaftlich und technisch extrem schlecht.
- Ab einem bestimmten Transaktionsvolumen oder strengen Latenzanforderungen (<200ms) ist das Fine-Tuning eigener Small Language Models (SLMs) unumgänglich.
- Durch Parameter-Efficient Fine-Tuning (PEFT) wie LoRA ist das Training hochspezialisierter Modelle im Mittelstand heute kostengünstig machbar.
- Compound AI Systems, die spezialisierte SLMs für das Routing und gigantische LLMs als Fallback nutzen, sind die führende Enterprise-Architektur der Zukunft.
Unternehmen verbrennen Millionen für API-Aufrufe, weil sie versuchen, massive Sprachmodelle durch gigantische System-Prompts und RAG-Pipelines in Korsetts zu zwängen, für die sie nicht gebaut wurden. Als KI-Architekt sage ich Ihnen: Wenn Ihr primärer Lösungsansatz für ungenaue KI-Ergebnisse immer noch lautet 'Wir müssen den Prompt länger machen', bauen Sie technische Schulden auf, die Sie in 12 Monaten einholen werden. Willkommen am Tipping Point, an dem wir aufhören, Intelligenz zu mieten, und anfangen, sie zu besitzen.
Die Anatomie der Prompting-Falle: Warum "Mehr Kontext" nicht skaliert
Unternehmen starten ihre KI-Reise fast immer mit Prompt-Engineering und Retrieval-Augmented Generation (RAG). Das ist historisch logisch und für Prototypen völlig legitim, führt in der Skalierung jedoch unweigerlich gegen eine harte wirtschaftliche und technische Wand. Jeder Token an Kontext, den wir via API an proprietäre Giganten wie OpenAI oder Anthropic senden, erhöht nicht nur die direkten Inferenzkosten massiv. Noch viel kritischer ist, dass ein riesiger Kontext-Prompt die Time-to-First-Token (TTFT) exponentiell verschlechtert. Wenn ein System zwanzig Seiten Kontext verarbeiten muss, nur um eine binäre Entscheidung zu treffen oder ein kurzes JSON zu generieren, betreiben wir massives Overengineering. In der Praxis führt dies zu Latenzen von über zwei Sekunden – in transaktionalen Unternehmenssystemen ein absolutes No-Go, das die User Experience zerstört und automatisierte Batch-Prozesse unwirtschaftlich langsam macht.
> 85%
Geringere Kosten bei lokalen SLMs vs. Cloud-APIs in Volumenszenarien
< 150ms
Mögliche TTFT (Latenz) eines gefeintunten 7B-Modells
99%
Reduktion trainierbarer Parameter durch LoRA
Der zweite, oft völlig ignorierte Effekt exzessiven Promptings ist der sogenannte 'Model Drift' oder 'API-Shift'. Proprietäre Cloud-Modelle werden kontinuierlich und oft intransparent im Hintergrund aktualisiert. Das bedeutet brutal formuliert: Ein aufwendig iterierter Mega-Prompt, der heute in 98 % der Fälle das gewünschte Ergebnis liefert, kann morgen plötzlich unberechenbare Halluzinationen oder fehlerhaftes JSON produzieren. Wer sich allein auf externe APIs verlässt, gibt die Kontrolle über die deterministische Qualität seiner Kernprozesse an Dritte ab. Diese inhärente Fragilität zwingt Data-Science-Teams in eine reaktive, frustrierende Rolle, in der sie ständig Prompts reparieren müssen, anstatt echten Geschäftswert zu iterieren. Wir beobachten in den Architektur-Audits der AI-Software GmbH regelmäßig, dass die Wartungskosten für hochkomplexe, fehleranfällige Prompt-Ketten die ursprünglichen Entwicklungskosten nach nur wenigen Monaten deutlich übersteigen.
Small Language Models (SLMs): Die Rückkehr zur Effizienz
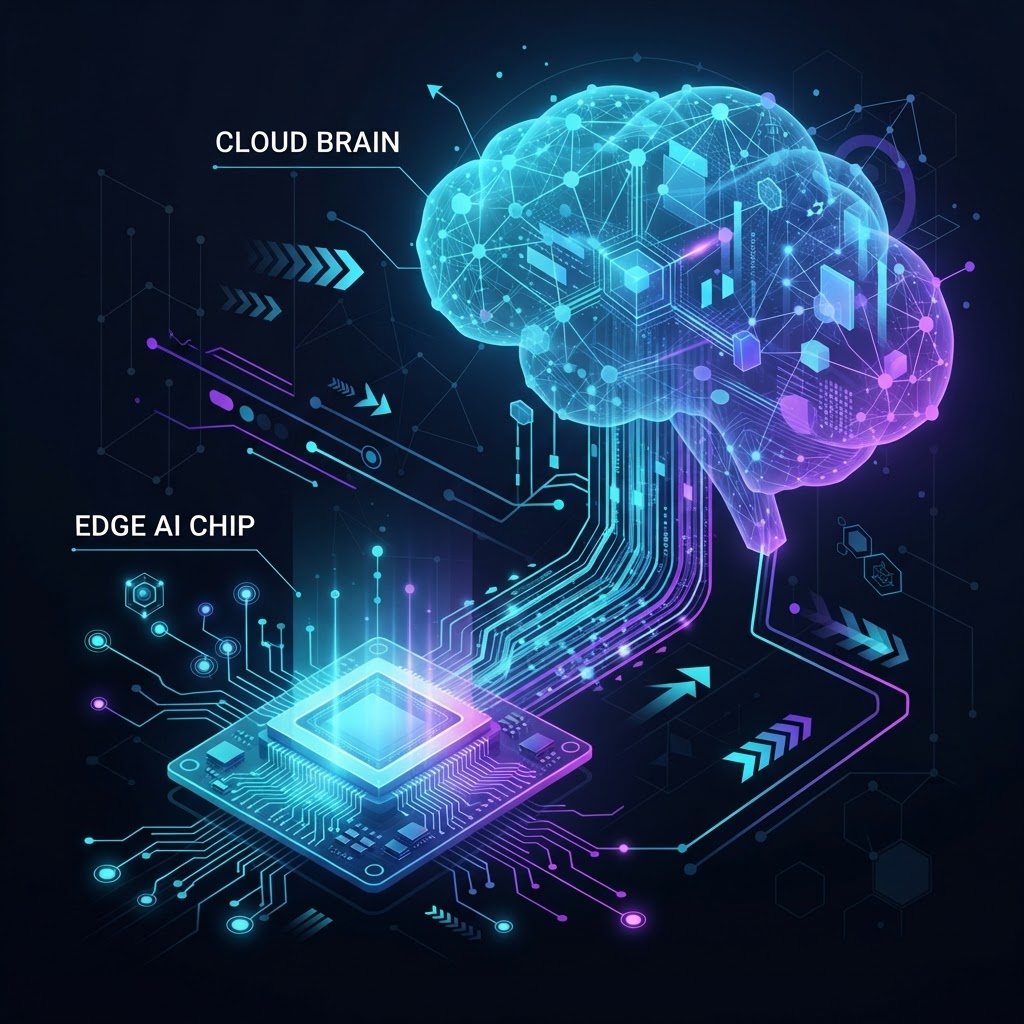
An diesem Punkt der Ernüchterung betritt eine neue Architektur-Generation die Bühne: Small Language Models. Modelle wie Llama 3 (8B), Mistral (7B) oder Microsofts Phi-3-Mini (3.8B) beweisen eindrucksvoll, dass schiere Parametergröße nicht der einzige Prädiktor für nutzbare Intelligenz im Business-Kontext ist. Ein SLM verfügt von Haus aus zwar nicht über das enzyklopädische Weltwissen eines GPT-4o. Doch genau das brauchen Sie auch nicht, um interne Rechnungen zu verarbeiten. Durch gezieltes Fine-Tuning in einer spezifischen Domäne – beispielsweise juristische Vertragsprüfung oder medizinisches Coding – kann ein kleines Modell dieselbe oder sogar eine höhere Genauigkeit erreichen als ein allgemeines Riesenmodell. Wir tauschen dabei bewusst Generalisierung gegen extreme Spezialisierung. Im Gegenzug erhalten wir Modelle, die so leichtgewichtig sind, dass sie lokal auf einer einzelnen Consumer-GPU laufen können.
Parameter-Efficient Fine-Tuning (PEFT) als Gamechanger
Der Grund, warum wir überhaupt über das Training eigener Modelle im Mittelstand sprechen können, liegt in mathematischen Durchbrüchen der jüngsten Zeit, primär LoRA (Low-Rank Adaptation) und dessen quantisierter Variante QLoRA. Anstatt wie beim klassischen Full-Fine-Tuning Milliarden von Parametern anzupassen – was ein Budget von hunderttausenden Euro und massive Compute-Cluster erfordern würde – friert LoRA das zugrundeliegende Basismodell quasi ein. Es trainiert stattdessen nur extrem kleine, rangniedrige Matrizen, die als leichte 'Adapter' auf das Modell gelegt werden. Dieser geniale Ansatz reduziert die benötigten trainierbaren Parameter um über 99 Prozent und senkt den VRAM-Bedarf der Grafikkarten drastisch ab. In unseren Kundenprojekten bei der AI-Software GmbH feintunen wir hochspezialisierte 7B-Modelle auf einem einzelnen A100 (80GB) Node innerhalb von wenigen Stunden, was die Iterationszyklen radikal beschleunigt und Kosten minimiert.
Datenqualität ist die neue Währung
Beim Fine-Tuning gilt das Prinzip 'Garbage In, Garbage Out' unerbittlicher als je zuvor. Schon 100 perfekt kuratierte, von Fach-Experten geschriebene Beispiele schlagen 10.000 synthetisch generierte Datensätze von mittelmäßiger Qualität. Fine-Tuning korrigiert kein schlechtes Daten-Fundament, es zementiert und skaliert es.
Der Tipping Point: Wann Sie von Prompting zu Fine-Tuning wechseln müssen
- Skalierungsvolumen: Wenn Ihre monatlichen API-Inferenzkosten für ein spezifisches Task-Routing 2.500 EUR überschreiten.
- Latenzkritikalität: Wenn System-SLA vorschreibt, dass die Time-to-First-Token (TTFT) zwingend unter 200 Millisekunden liegen muss.
- Deterministische Formate: Wenn Sie 100%ige Zuverlässigkeit in der Ausgabe hochkomplexer, tiefer JSON-Strukturen ohne Halluzinationen benötigen.
- Datenschutz-Compliance: Wenn Sie streng geheime PII- oder Gesundheitsdaten (HIPAA/DSGVO) verarbeiten, die niemals Ihr eigenes VPC (Virtual Private Cloud) verlassen dürfen.
- Spezifischer Tonality & Style: Wenn das Modell die exakte Corporate Identity oder juristische Fachsprache in der Text-Synthese replizieren soll, an der generisches Prompting regelmäßig scheitert.
Vorteile
- 100%ige Datenhoheit und On-Premise-Fähigkeit
- Massiv geringere Latenzen (Edge-Deployment möglich)
- Langfristig bis zu 90% niedrigere Inferenzkosten
- Aufbau von unkopierbarem intellektuellem Eigentum (IP)
- Kein Model-Drift und absolute Vorhersehbarkeit
Nachteile
- Hoher initialer Aufwand für Datenkuration
- Bedarf an speziellem MLOps- und GPU-Infrastruktur-Wissen
- Modelle können 'Katastrophales Forgetting' erleiden
- Kein 'Weltwissen' für Open-Domain-Fragen außerhalb des Trainings
Die Architektur der Zukunft: Compound AI Systems
Ein typischer, naiver Fehler unerfahrener KI-Architekten ist die binäre Annahme, Fine-Tuning sei ein striktes Substitut für Prompting. In der Enterprise-Realität liegt die Wahrheit in einer hybriden Orchestrierung, den sogenannten 'Compound AI Systems'. In dieser Architektur agiert ein blitzschnelles, hochspezialisiertes SLM als intelligenter Router oder Extraktor direkt an der Frontlinie. Es klassifiziert Intents, parst User-Inputs oder extrahiert strukturierte Daten mit deterministischer Genauigkeit – und entscheidet lokal, welche Anfragen es sofort selbst lösen kann. Nur die hochkomplexen Outlier-Anfragen, die tiefes logisches Schlussfolgern über Domänengrenzen hinweg erfordern, werden an schwere, kostenintensive API-Modelle weitergeleitet. Dieses Pattern minimiert Ihre laufenden Ausgaben radikal und kombiniert die Schnelligkeit lokaler Systeme mit der analytischen Tiefe der Cloud-Giganten.
Wir müssen aufhören, KI-Modelle als monolithische Super-Gehirne zu betrachten. Die Zukunft der Enterprise-Architektur ist ein Schwarm aus hunderten hochspezialisierten, gefeintunten Small Language Models, die miteinander kommunizieren – agil, lokal und präzise wie klassische Microservices.
Schritt-für-Schritt: Der Weg zum eigenen Fine-Tuned Model
- 1
Data Curation & Formatting: Bereinigung historischer Daten und Aufbau eines Instruction-Sets (oft im JSONL-Format nach Alpaca- oder ChatML-Standard).
- 2
Base Model Selection: Auswahl des effizientesten Open-Weight-Modells (z.B. Llama-3-8B-Instruct für allgemeine Logik, Qwen für Coding-Tasks).
- 3
Training Setup & LoRA-Config: Definition der Hyperparameter, Lernraten und Ziel-Module (z.B. Q, V Projektionen in der Attention-Schicht) für das Parameter-Efficient Training.
- 4
Rigorous Evaluation: Metrik-basiertes Testen (z.B. ROUGE, BLEU, LLM-as-a-Judge) gegen ein strikt separiertes Holdout-Testset, um Overfitting zu vermeiden.
- 5
Quantization & Deployment: Komprimierung der Gewichte (z.B. auf 4-bit GGUF, AWQ) und lokales Hosting über Hochleistungs-Inferenzserver wie vLLM oder Ollama.
Der absolut kritischste und gleichzeitig am meisten unterschätzte Schritt im gesamten Fine-Tuning-Prozess ist die automatisierte Evaluierung. Während ein Entwickler bei einem simplen System-Prompt relativ schnell manuell testen kann, ob die Ausgabe sich 'irgendwie verbessert' hat, verlangt ernsthaftes Modell-Training nach einer rigorosen, messbaren MLOps-Pipeline. Bei der AI-Software GmbH stützen wir uns auf Methoden wie 'LLM-as-a-Judge'. Hierbei fungieren dedizierte, riesige Modelle wie GPT-4 als neutrale, objektive Schiedsrichter, um die Outputs unseres gefeintunten SLMs anhand harter Rubriken zu bewerten. Nur durch das engmaschige Tracking dieser Metriken können wir das gefürchtete Phänomen des 'Katastrophalen Forgetting' verhindern – also den fatalen Effekt, dass ein Modell zwar seine neue Spezial-Aufgabe perfekt lernt, dabei aber seine grundlegende Sprach- und Grammatikkompetenz unwiderruflich verlernt.
- Ist ein bereinigter Datensatz mit mindestens 500 bis 1.000 Golden-Standard-Beispielen vorhanden?
- Wurde die VRAM-Kapazität der Ziel-Infrastruktur für das Deployment validiert (z.B. 16 GB für ein quantisiertes 7B-Modell)?
- Gibt es ein automatisiertes Evaluation-Set (Holdout), das das Modell während des Trainings nie zu Gesicht bekommt?
- Ist das Problem durch Prompting definitiv nicht mehr stabil und wirtschaftlich lösbar?
Prognose 2025-2027: Die Commoditisierung von Intelligenz
Die Halbwertszeit von KI-Innovationen schrumpft kontinuierlich, doch ein übergeordneter Architektur-Trend ist für die nächsten Jahre völlig irreversibel: Künstliche Intelligenz wird zu einer Commodity, die zunehmend am 'Edge', also extrem nah am Endnutzer oder am proprietären Datensatz, ausgeführt wird. Bis zum Jahr 2027 prognostiziere ich fundiert, dass über 60 Prozent aller transaktionalen, enterprise-internen KI-Tasks durch lokale Modelle abgewickelt werden, die deutlich unter der Grenze von 10 Milliarden Parametern liegen. Techniken wie 'Knowledge Distillation' – bei denen ein massives Teacher-Modell ein kleines, blitzschnelles Student-Modell für eine spezifische Aufgabe automatisiert trainiert – werden zum Standardrepertoire jedes Software-Engineers gehören. Wer heute ausschließlich Prompts für fremde APIs optimiert, baut sein Geschäftsmodell auf fremdem Land und zahlt dafür ewige Miete. Wer dagegen heute lernt, wie man Daten exzellent kuratiert und eigene Modelle verfeinert, baut echtes intellektuelles Eigentum auf.
FAQ für Entscheider und System-Architekten
Fazit: Intelligenz als strategisches Asset, nicht als reiner Service
Der unvermeidliche Paradigmenwechsel vom simplen Prompting zum zielgerichteten Fine-Tuning markiert den eigentlichen Reifeprozess von Enterprise AI. Es ist der harte, aber lohnende Schritt von spielerischer Exploration zu deterministischem, skalierbarem Software-Engineering. Prompt-Engineering wird niemals ganz verschwinden – es bleibt auf absehbare Zeit das Werkzeug der Wahl für Rapid Prototyping und explorative, breite Aufgaben. Doch für geschäftskritische, hochvolumige Kernprozesse ist die Integration und das Training eigener Small Language Models kein technisches 'Nice-to-have' mehr, sondern die schlichtweg einzige nachhaltige Architektur-Entscheidung. Jedes Unternehmen muss sich heute strategisch fragen: Wollen wir dauerhaft für jede kognitive Transaktion eine Infrastruktur-Steuer an Big Tech abführen, oder bauen wir unser eigenes digitales Nervensystem auf, das uns zu 100 Prozent gehört, unsere Daten schützt und organisch mit unserem Geschäft mitwächst?
Bereit für den nächsten Evolutionsschritt Ihrer KI-Infrastruktur?
Lassen Sie uns Ihre API-Kosten drastisch reduzieren und Latenzen minimieren. Die Experten der AI-Software GmbH analysieren Ihre bestehenden Use Cases, validieren Ihre Daten-Pipelines und entwickeln eine maßgeschneiderte, zukunftssichere SLM-Strategie für Ihr Unternehmen. Kontaktieren Sie uns noch heute für einen unverbindlichen Architektur-Review.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.