Context Windows von 10M+ Token nutzen: Code-Bibliotheken in einem Prompt meistern
Die Ära der gigantischen Kontextfenster krempelt die KI-Software-Architektur um. Erfahren Sie, wie Sie Millionen von Token effizient verarbeiten und ganze Code-Bibliotheken analysieren.
Inhalt
Das Wichtigste in Kürze
- Die Skalierung auf 10M+ Token verschiebt den Fokus von komplexen RAG-Pipelines hin zu intelligentem Context-Packing und Caching.
- Hardware-Limits wie der KV-Cache-Speicherbedarf erfordern neue Attention-Mechanismen wie Ring Attention und Sparse Attention.
- Für die ganzheitliche Analyse von Legacy-Codebasen schlägt Long-Context traditionelles Chunking um Längen bei der semantischen Genauigkeit.
- Prompt-Caching reduziert die extremen API-Kosten großer Prompts um bis zu 90 Prozent und macht End-to-End Code-Analysen wirtschaftlich.
Der Moment, als Google Gemini 1.5 Pro mit einem 2-Millionen-Token-Kontextfenster aufschlug und kurz darauf experimentelle 10 Millionen Token demonstrierte, markierte einen Wendepunkt in der KI-Entwicklung. Als Architekten bei der AI-Software GmbH evaluieren wir Systeme, die nicht mehr nur Schnipsel, sondern komplette GitHub-Repositories samt Historie auf einmal schlucken. Die Konsequenzen für die Softwareentwicklung sind monumental: Plötzlich ist es möglich, systemweite Refactorings und Sicherheitsanalysen über Millionen Zeilen Code durchzuführen, ohne die Abhängigkeiten durch fehlerbehaftete Chunking-Verluste zu zerstören.
Der Paradigmenwechsel: Warum 10M+ Token alles verändern
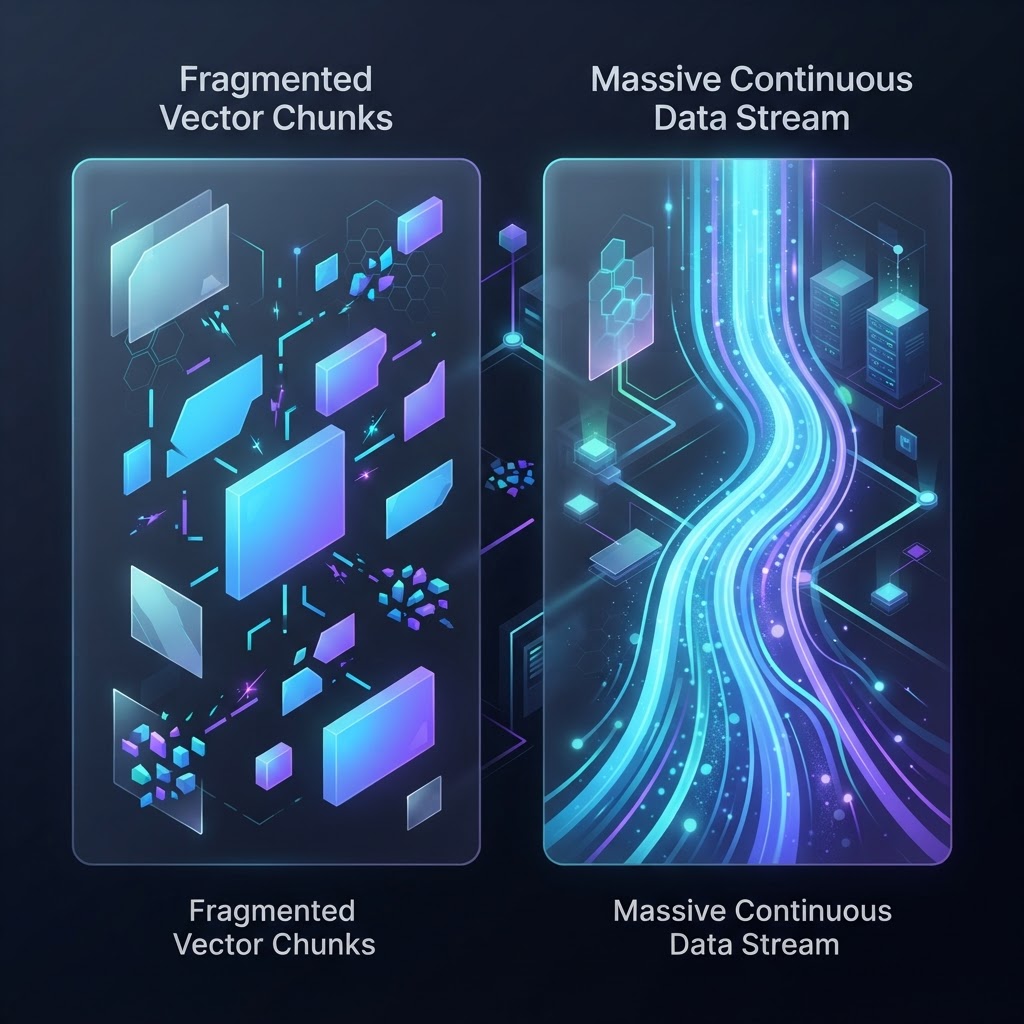
Traditionelles Retrieval-Augmented Generation (RAG) war die architektonische Krücke, die wir brauchten, als Modelle bei 8k oder 32k Token an ihre Grenzen stießen. RAG zerteilt Code in Vektor-Chunks. Das massive Problem dabei: Code ist nicht semantisch isoliert. Eine Variable, die in Modul A definiert, in Modul B mutiert und in Modul C ausgegeben wird, übersteigt die Retrieval-Fähigkeiten eines standardmäßigen k-Nearest-Neighbor-Ansatzes, da der semantische Raum für stark vernetzte Logik nicht ausreicht. Bei einem Kontextfenster von 10 Millionen Token ändert sich die Spielregel fundamental: Wir laden die gesamte Bibliothek direkt in den Arbeitsspeicher des LLMs. Die Needle in a Haystack Genauigkeit (NIAH) aktueller Long-Context-Modelle liegt bei nahezu 99 Prozent, was RAG für spezifische, holistische Code-Analysen schlichtweg obsolet macht.
2M+ Token
Max Context Size (Gemini 1.5 Pro)
>99%
NIAH Accuracy bei 1M Token
~4GB
VRAM für KV-Cache pro 1M Token
O(N^2)
Rechenaufwand Self-Attention
Architektur-Deep-Dive: Der Flaschenhals im KV-Cache
Warum hat dieser Skalierungssprung so lange gedauert? Die Mathematik hinter der Transformer-Architektur ist gnadenlos. Die Standard-Self-Attention skaliert quadratisch bezüglich der Sequenzlänge. Das bedeutet: Verdoppelt man das Kontextfenster, vervierfacht sich der Rechenaufwand der Attention-Matrix. Zudem wächst der Key-Value (KV) Cache, der den Zustand der Token speichert, linear an. Bei 10 Millionen Token sprechen wir von hunderten Gigabyte an VRAM, nur um den State einer einzigen Batch-Size zu halten. Durchbrechen konnten wir diese physikalische Grenze erst durch architektonische Innovationen wie Ring Attention, Blockwise Computation und Sparse Attention. Als Ingenieure müssen wir verstehen: Ein riesiger Kontext ist kein Freifahrtschein. Er erkauft sich kognitive Weitsicht mit massiver Latenz und extremen Inference-Kosten auf GPU-Ebene.
Achtung Kostenfalle
Ein Prompt mit 2 Millionen Token kostet bei aktuellen Premium-Modellen ohne Caching oft zweistellige Dollarbeträge pro API-Aufruf. Wenn Entwickler bei jedem Chat-Turn die gesamte Codebasis neu übertragen, explodieren die Cloud-Kosten innerhalb weniger Tage.
Programmiertechniken: Ein ganzes Repo in den Prompt packen
Um eine 500-MB-Codebasis effektiv in ein LLM zu überführen, reicht es keinesfalls, einfach alle Quelldateien plump aneinanderzuhängen. Die Struktur muss für den Transformer präzise navigierbar bleiben. Wir bei der AI-Software GmbH nutzen strikte XML-ähnliche Tagging-Strukturen, um dem Modell räumliche Orientierung und Dateihierarchien zu vermitteln. Zudem müssen wir das Rauschen eliminieren: Binärdateien, Lock-Files, minimierter Code und Build-Ordner verschwenden nicht nur astronomisch teure Token, sondern degradieren die Attention-Performance drastisch, da das Modell irrelevante Muster gewichtet und dadurch den Fokus auf die eigentliche Business-Logik verliert.
- 1
Repositorium hart filtern: Entfernung von Binaries, .git, node_modules und Lock-Files über .gitignore-Parsing.
- 2
Abstract Syntax Tree (AST) nutzen, um unkommentierten oder irrelevanten Legacy-Code vorab auf Funktionsebene zu minifizieren.
- 3
XML-Strukturierung anwenden: Dateipfade als öffnende und schließende Tags definieren, um Hierarchien als explizite Tokens einzubetten.
- 4
Prompt-Caching-API des Providers aufrufen, um den statischen Code als Prefix zu fixieren und Kosten zu sparen.
- 5
Spezifische Instruktionen (die eigentliche Aufgabe) GANZ AM ENDE des Prompts platzieren, da Modelle dort die höchste Attention-Dichte aufweisen.
Ein oft übersehener Insider-Trick bei der AI-Software GmbH ist die Vorverarbeitung durch Abstract Syntax Trees (AST). Bevor wir zehntausende Zeilen in den Tokenizer jagen, parsen wir den Code und entfernen alle irrelevante Formatierungen oder generierten Boilerplate-Code, der für die semantische Analyse keinen Mehrwert bietet. Wenn das Ziel beispielsweise ein Security-Audit der API-Endpoints ist, extrahiert unser AST-Skript nur die Controller, Middleware und Datenmodelle, während Frontend-CSS-Klassen verworfen werden. Diese Signal-to-Noise-Optimierung maximiert die Qualität der KI-Antworten und verhindert Halluzinationen in tiefen Code-Schichten.
Praxis-Check: Long Context vs. Traditionelles RAG
Vorteile
- Perfektes Verständnis von Cross-File-Dependencies und globalen Variablen
- Keine fehleranfällige und schwer wartbare Chunking-Logik mehr nötig
- Holistisches System-Refactoring in einem einzigen Durchlauf möglich
- Drastisch reduzierte Setup-Zeit im Vergleich zu Vektordatenbanken
Nachteile
- Sehr hohe Latenz (Time to First Token oft bei über 30 Sekunden)
- Massive Kosten pro API-Call, falls kein Prompt-Caching verfügbar ist
- Gefahr der Lost-in-the-Middle-Degradation bei völlig unstrukturiertem Input
- Hardware-Limits zwingen zur Abhängigkeit von wenigen proprietären Cloud-APIs
Insider-Tipp: Die Lost in the Middle Problematik minimieren
Selbst wenn Benchmark-Tests 99 Prozent Retrieval-Genauigkeit versprechen, sieht die Praxis bei extrem komplexen Code-Architekturen anders aus. LLMs leiden weiterhin unter einem Phänomen, das als Lost in the Middle bekannt ist: Informationen am Anfang und am Ende des Prompts werden vom Attention-Mechanismus viel stärker gewichtet als jene in der Mitte. Wenn die entscheidende Abhängigkeit einer Authentifizierungs-Schnittstelle in Token-Position 4.500.000 versteckt ist, kann das Modell sie in komplexen Reasoning-Aufgaben schlicht übersehen. Der Trick liegt in einer Zwei-Phasen-Strategie: Zuerst fordern wir das Modell auf, ein Inhaltsverzeichnis oder eine Dependency-Map des bereitgestellten Codes zu generieren, bevor es die eigentliche Refactoring-Aufgabe löst. Dieses Prinzip zwingt das Netzwerk, Pointer auf relevante Code-Segmente im frischen Output aufzubauen.
Die Fähigkeit, 10 Millionen Token zu verarbeiten, ersetzt nicht das Denken in sauberen Architekturen. Sie verschiebt lediglich unsere kognitive Grenze von der Ebene einzelner Dateien auf die Ebene globaler Systeme. Wer Müll in den riesigen Kontext wirft, erntet extrem teuren Müll.
Zweite-Ordnungs-Effekte: QA und Testing revolutioniert
Zweite-Ordnungs-Effekte dieser Architektur zeigen sich massiv im Testing und der Qualitätssicherung. Bisher mussten KI-gestützte Testgeneratoren Funktion für Funktion abarbeiten, was oft zu isolierten und praxisfremden Unit-Tests führte. Indem wir nun die gesamte Test-Suite zusammen mit der Business-Logik und den Konfigurationsdateien in das 10M-Token-Fenster laden, erkennt das LLM systemische Lücken. Es sieht nicht nur, dass ein Endpunkt getestet wird, sondern begreift, ob die dazugehörigen Datenbank-Mocks mit den tatsächlichen Schema-Migrationen übereinstimmen. Die AI-Software GmbH nutzt diese Technik, um Integrationstests zu generieren, die komplexe User-Journeys über mehrere Microservices hinweg simulieren - ein Prozess, der mit klassischem RAG undenkbar war.
Zukunftsausblick 2025: Prompt Caching als Gamechanger
Der aktuelle Flaschenhals der Inference-Kosten wird sich in den nächsten 12 bis 36 Monaten durch radikale Verbesserungen beim Context Caching auflösen. Provider wie Anthropic und Google bieten bereits heute Features an, bei denen der statische Teil eines Prompts (zum Beispiel das 5-Millionen-Token-Repository) im KV-Cache der Server verbleibt und nur inkrementell geupdatet wird. Sie zahlen dann nur noch einen Bruchteil für nachfolgende Queries auf denselben Kontext. Für unsere Enterprise-Kunden bei der AI-Software GmbH bedeutet dies: Wir bauen heute bereits Systeme, die Repositories als persistenten LLM-State betrachten. Entwickler chatten quasi in Echtzeit mit ihrer gesamten Codebasis, wobei die Latenz dank serverseitigem Caching von Minuten auf wenige Millisekunden sinkt.
Häufig gestellte Fragen (FAQ)
Fazit: Die neue Ära der KI-Programmierung
Die Skalierung auf 10 Millionen Token ist kein bloßes Feature-Update der Modell-Provider, sie ist ein architektonisches Paradigma. Die Möglichkeit, ganze Archiv-Systeme und Codebasen auf einen Schlag semantisch greifbar zu machen, eliminiert die blinden Flecken traditioneller Vektor-Suchen. Doch wie wir gesehen haben, erfordert diese Macht ein Höchstmaß an Engineering-Exzellenz: Vom präzisen AST-Parsing über XML-Strukturierung bis hin zum strategischen Prompt-Caching. Wer diese Techniken beherrscht, verschafft seinem Entwicklungsteam einen unaufholbaren Geschwindigkeitsvorteil bei Systemanalysen und Refactorings.
Jetzt KI-Potenziale im Code entfesseln
Sie möchten Ihre Code-Bibliotheken mit modernster LLM-Technologie analysieren lassen und Legacy-Systeme effizient modernisieren? Die Experten der AI-Software GmbH entwickeln maßgeschneiderte Long-Context-Architekturen für Ihr Unternehmen. Kontaktieren Sie uns für einen technischen Deep-Dive.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.