KI-gestützte Bildung: Die Architektur personalisierter Lernpfade
Wie tutorielle KI-Systeme das Bloom'sche 2-Sigma-Problem lösen, starre Curricula aufbrechen und Lehrkräfte durch prädiktive Daten zu strategischen Mentoren machen.
Inhalt
Das Wichtigste in Kürze
- Das 2-Sigma-Problem ist gelöst: LLMs ermöglichen erstmals die unendliche Skalierung individueller 1:1-Nachhilfe auf höchstem Niveau.
- GraphRAG schlägt Standard-RAG: Für strukturierte Lernpfade benötigen KI-Modelle semantische Knowledge Graphs, keine simplen Vektordatenbanken.
- Sokratisches Prompting: Die größte technische Herausforderung ist es, Modelle (z.B. GPT-4o, Llama 3) darauf zu trimmen, keine direkten Antworten zu geben, sondern den Schüler anzuleiten.
- Rollenwandel der Lehrkraft: Automatisierte Wissensvermittlung entlastet Lehrer, die zu empathischen Mentoren und Daten-Interpreten werden.
Die Ära des 'One-size-fits-all'-Unterrichts kollabiert in Echtzeit. Während traditionelle Bildungssysteme an Skalierungsgrenzen zerbrechen, bauen wir bei der AI-Software GmbH tiefgreifende kognitive Architekturen, die sich dynamisch an die kognitive Kapazität jedes einzelnen Lernenden anpassen.
Das Ende eines 40 Jahre alten Dilemmas: Das Bloom'sche 2-Sigma-Problem
Im Jahr 1984 veröffentlichte Benjamin Bloom seine bahnbrechende Studie zum sogenannten 2-Sigma-Problem. Er bewies, dass Schüler, die durch Einzelnachhilfe (Tutoring) betreut werden, um zwei Standardabweichungen besser abschneiden als solche im klassischen Klassenunterricht. Dies bedeutet, dass ein durchschnittlich begabter Schüler durch gezieltes 1:1-Mentoring das Leistungsniveau der besten 2 Prozent einer regulären Klasse erreicht. Bisher scheiterte die flächendeckende Umsetzung dieses Ideals schlicht an den immensen personellen, zeitlichen und finanziellen Kosten. Mit dem Aufstieg hochperformanter Large Language Models (LLMs) wie GPT-4o oder Claude 3.5 Sonnet hat sich diese Gleichung fundamental verändert. Wir sind heute technologisch erstmals in der Lage, diese hochgradig personalisierte Betreuung als Software-Dienstleistung grenzenlos zu skalieren.
98%
Leistungsperzentil durch 1:1 Tutoring (Bloom, 1984)
< 400ms
Latenzzeit moderner multimodaler KI-Modelle für Audio (z.B. GPT-4o)
50-60%
Reduktion administrativer Aufgaben für Lehrkräfte durch KI
Architektur von KI-Lernsystemen: Warum Standard-RAG im EdTech scheitert
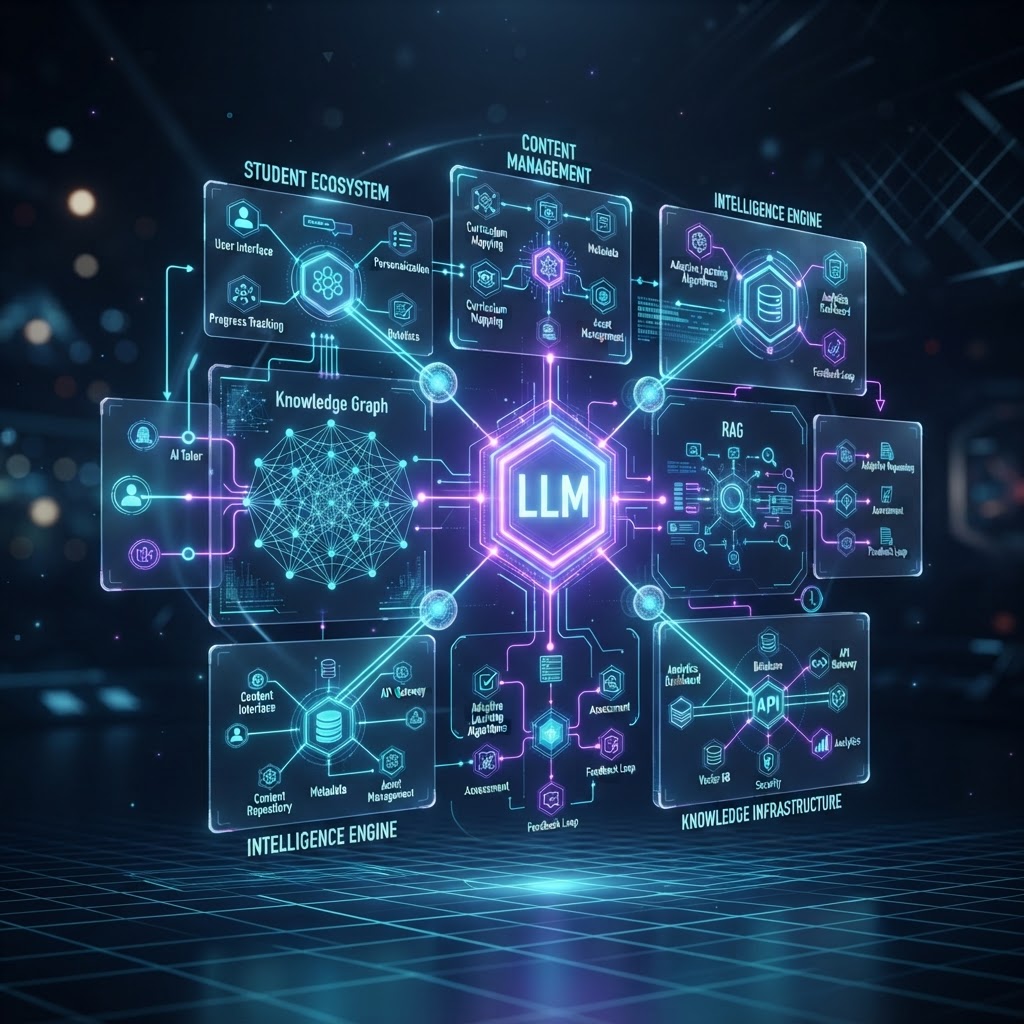
In der Industrie sehen wir oft den Versuch, simple Chatbots für den Bildungsbereich zu bauen. Ein naiver Ansatz, bei dem PDF-Lehrbücher per Chunking in eine Vektordatenbank geworfen und via klassischer Retrieval-Augmented Generation (RAG) abgefragt werden, ist jedoch hochgradig fehleranfällig und pädagogisch wertlos. Lernen ist kein unstrukturierter Informationsabruf, sondern ein sequenzieller, epistemischer Prozess, der zwingend auf Vorwissen aufbaut. Ein Vektor-Suchalgorithmus versteht die didaktische Reihenfolge nicht und könnte einem Schüler komplexe Integralrechnung erklären, ohne zu prüfen, ob die Grundlagen der Algebra verstanden wurden. Wenn wir bei der AI-Software GmbH Lernsysteme auf Enterprise-Niveau konzipieren, umgehen wir dieses Risiko durch den Einsatz von Graph-basierten Architekturen. Das Curriculum muss strukturiert maschinenlesbar vorliegen, um den Lernfortschritt abzusichern.
Insider-Tipp: GraphRAG statt Vektor-Chaos
Verlassen Sie sich im EdTech-Sektor niemals rein auf semantische Ähnlichkeitssuche. Nutzen Sie Knowledge Graphs (z.B. Neo4j), um curriculare Abhängigkeiten abzubilden (sogenanntes GraphRAG). Nur so weiß die KI, welche Konzepte als Vorbedingungen zwingend erfüllt sein müssen, bevor neue freigeschaltet werden.
Dieser GraphRAG-Ansatz kombiniert die semantische Flexibilität eines LLMs mit der deterministischen Strenge eines Graphen. Jeder Knoten im Graph repräsentiert einen Lernschritt, jede Kante eine didaktische Voraussetzung. Der State des Nutzers – also sein aktuelles Verständnislevel – wird kontinuierlich in einer flankierenden SQL- oder NoSQL-Datenbank getrackt. So entsteht ein geschlossener Regelkreis: Die KI wertet die Antwort des Schülers aus, aktualisiert das State-Tracking und entscheidet dynamisch, ob der Schüler den nächsten Knoten im Graphen betreten darf oder ob ein Remediation-Pfad (Wiederholungspfad) generiert werden muss. Das System plant die Route durch den Lehrplan also in Echtzeit um, exakt zugeschnitten auf die kognitive Geschwindigkeit des Nutzers. Es entsteht ein wahrhaft adaptiver Lernpfad, der starre Klassenstrukturen obsolet macht.
Das Sokratische Dilemma: KI-Modelle zur Zurückhaltung zwingen
Ein fundamentaler Konstruktionsfehler vieler KI-Lösungen ist das sogenannte 'Spoon-Feeding'. Basismodelle wurden via RLHF (Reinforcement Learning from Human Feedback) darauf konditioniert, so schnell und präzise wie möglich die korrekte Antwort zu liefern. Genau das ist in einem pädagogischen Kontext fatal: Ein Tutor, der sofort die Lösung verrät, verhindert den entscheidenden kognitiven Lernprozess (Productive Struggle). Wir müssen die Modelle durch rigides Prompt-Engineering und gelegentlich sogar durch eigenes Fine-Tuning zwingen, den Sokratischen Dialog zu führen. Die KI darf die Antwort nicht geben, sondern muss durch gezielte Gegenfragen, Hinweise und Analogien den Schüler selbst zur Lösung navigieren. Dies erfordert komplexe System-Prompts, die Evaluierungs-Frameworks wie 'LLM-as-a-Judge' unterzogen werden, um sicherzustellen, dass die pädagogischen Leitplanken nicht durch Jailbreaking umgangen werden.
Vorteile
- Closed-Source (z.B. GPT-4o): Höchste kognitive Fähigkeiten direkt Out-of-the-Box.
- Closed-Source: Native multimodale Verarbeitung (Audio/Vision) extrem schnell.
- Open-Weight (z.B. Llama 3 70B): Volle Datenkontrolle für DSGVO-konforme On-Premise-Setups.
- Open-Weight: Keine Vendor-Lock-ins und vorhersagbare Inferenzkosten bei Skalierung.
Nachteile
- Closed-Source: API-Kosten können bei massiver Skalierung und Millionen Nutzern explodieren.
- Closed-Source: Kritische DSGVO-Bedenken bei der Übermittlung von sensiblen Schülerdaten an US-Server.
- Open-Weight: Setup und Wartung eigener GPU-Cluster erfordert enormes DevOps-Know-how.
- Open-Weight: Modelle hinken bei tiefer Logik und nativem Voice-Handling dem State-of-the-Art minimal hinterher.
In 5 Schritten: Eine individuelle Tutor-KI auf Enterprise-Level implementieren
Als Softwarearchitekten bei der AI-Software GmbH sehen wir, dass erfolgreiche EdTech-Projekte einem klaren, iterativen Blueprint folgen müssen. Der Versuch, 'einfach mal einen GPT-Wrapper zu bauen', endet unweigerlich in schlechten Nutzererfahrungen und Halluzinationen. Eine belastbare Architektur verlangt eine saubere Trennung von Orchestrierungsschicht, Datenhaltung und LLM-Inferenz. Wenn wir komplexe Mandanten anbinden, beginnen wir stets mit der Daten-Taxonomie. Erst wenn die Lehrinhalte granular zertrennt und indexiert sind, kann die Intelligenz des Sprachmodells überhaupt produktiv wirken. Wir implementieren zudem Agentic Workflows, bei denen ein 'Teacher Agent' die Antwort des LLMs evaluiert, bevor diese an den Schüler gesendet wird. Dieser Multi-Agenten-Ansatz reduziert fachliche Halluzinationen auf ein absolutes Minimum.
- 1
Curriculum Mapping: Transformation des Lehrplans in einen maschinenlesbaren Knowledge Graph (Nodes & Edges).
- 2
RAG & Ingestion: Aufbau einer sicheren Vektordatenbank kombiniert mit Metadaten für das verifizierte Lehrmaterial.
- 3
State Tracking: Entwicklung einer Middleware, die den Wissenstand (Cognitive State) jedes Schülers in Echtzeit speichert.
- 4
Prompt Guardrails: Implementierung von Sokratischen System-Prompts und Multi-Agenten-Checks (LLM evaluiert LLM).
- 5
Dashboarding: Bau einer Analytik-UI für die Lehrkräfte, um Interaktionen zu überwachen und Anomalien zu erkennen.
Lehrkräfte als Daten-Strategen und emotionale Mentoren
Eine weit verbreitete Fehlannahme ist, dass KI-Tutoringsysteme den menschlichen Lehrer ersetzen sollen. Das Gegenteil ist der Fall: Sie transformieren die Rolle des Lehrers von einem monotonen Inhaltsvermittler hin zu einem hochqualifizierten, emphatischen Mentor. Wenn eine Klasse mit 30 Schülern an iPads arbeitet, agiert die KI als der individuelle Mikrotutor für jeden Einzelnen. Die Lehrkraft steht derweil vor einem Dashboard, das Prädiktionsalgorithmen nutzt, um Alarm zu schlagen. Das System signalisiert beispielsweise in Echtzeit: 'Schüler X hängt seit 12 Minuten in einer Frustrationsschleife beim Thema Bruchrechnung fest – menschliche Intervention erforderlich'. Die AI-Software GmbH integriert genau solche Feedback-Schleifen in die UI. Die Lehrkraft greift erst ein, wenn der Schüler auf emotionaler oder hochkomplexer fachlicher Ebene blockiert ist. Das vervielfacht den pädagogischen Impact des Menschen.
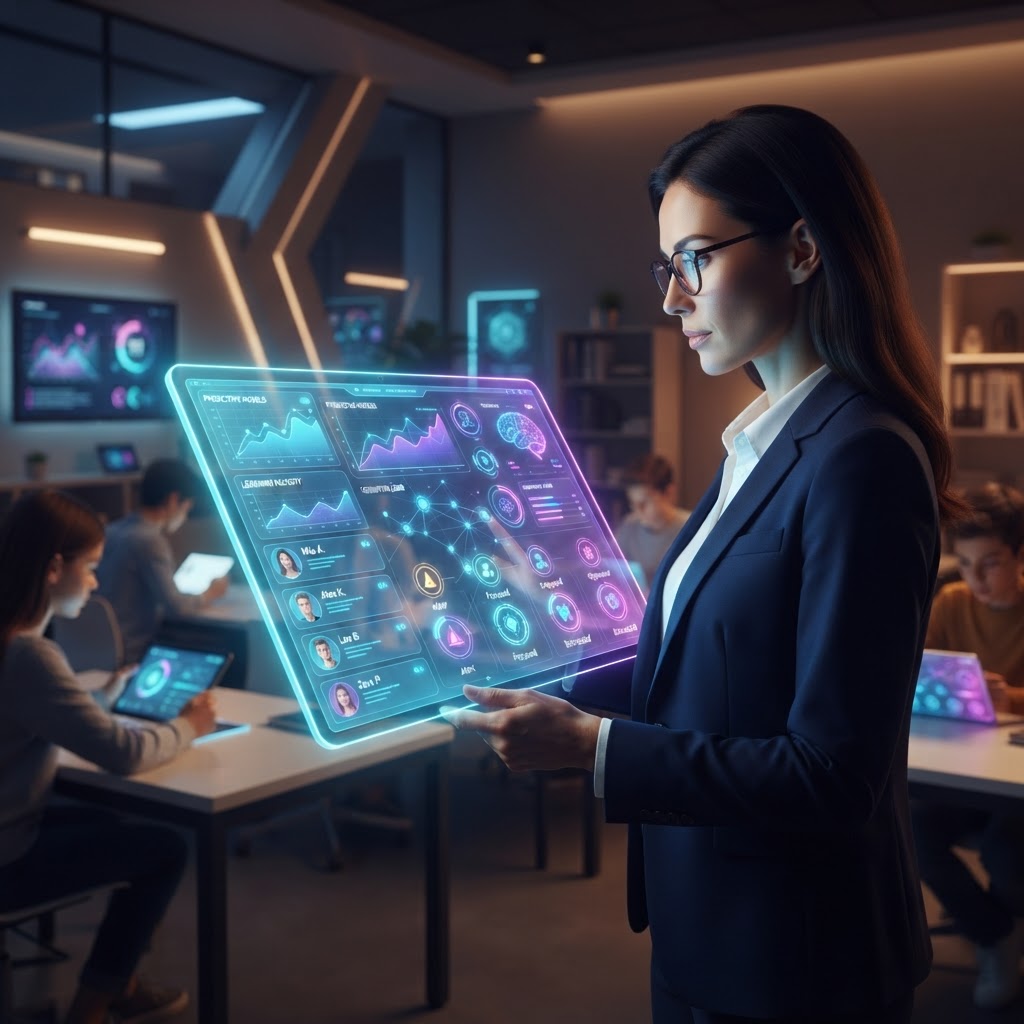
Ein perfekter KI-Tutor gibt niemals die Antwort. Er stellt genau jene brillante Frage, die den Schüler glauben lässt, er hätte das Problem ganz allein gelöst. Das ist die eigentliche Kunst der Prompt-Architektur.
Best Practices: Vermeidung von Halluzinationen im Klassenzimmer
Die Toleranz für KI-Halluzinationen (das selbstbewusste Erfinden von Fakten) liegt im Bildungssektor bei null. Ein Chatbot, der eine historische Jahreszahl fälscht oder eine physikalische Formel inkorrekt anwendet, zerstört das Vertrauen in das gesamte System augenblicklich. Um diese Fehlerrate drastisch zu senken, reicht bloßes Prompting nicht aus. Wir setzen auf strikte Grounding-Verfahren: Das LLM darf nur aus dem injizierten Kontext (RAG) antworten und muss jede Aussage mit Quellenangaben versehen. Zudem nutzen wir strukturierte JSON-Ausgaben für den Datenfluss zwischen Backend und Frontend, um unerwünschte Outputs technisch herauszufiltern. In unternehmenskritischen EdTech-Plattformen schalten wir oft ein kleineres, dediziertes Evaluator-Modell (z.B. Llama-3-8B) dazwischen, das den Output des primären Modells (z.B. GPT-4o) vor der Auslieferung an den Schüler auf fachliche Konsistenz prüft. Diese architektonische Vorsicht trennt professionelle Lösungen von Spielereien.
- Zero-Temperature: Setzen Sie den Parameter 'Temperature' der LLM-API für faktenbasierte Fächer (Mathe, Physik) auf 0 oder sehr niedrig.
- Chain-of-Thought (CoT): Zwingen Sie das Modell, seine didaktischen Überlegungen in einem versteckten Feld zu generieren, bevor es dem Schüler antwortet.
- Human-in-the-Loop: Ermöglichen Sie es Schülern, Antworten mit einem Klick an die echte Lehrkraft zur Überprüfung zu melden (Flagging).
- Strict Grounding: Das System-Prompt muss zwingend den Befehl enthalten: 'Wenn du die Antwort im bereitgestellten Kontext nicht findest, antworte mit: Das weiß ich nicht.'
Prognose 2025-2027: Multimodale Echtzeit-Tutoren
Wenn wir auf den Horizont der nächsten 12 bis 36 Monate blicken, wird die reine Text-Interaktion zum Relikt. Die echte Disruption erfolgt durch Multimodalität. Modelle wie GPT-4o und kommende Gemini-Architekturen verarbeiten Audio und Video nativ, ohne verlustbehaftete Speech-to-Text-Zwischenschritte. Ein KI-Tutor im Jahr 2026 wird durch die Kamera des Tablets erkennen, wenn ein Schüler die Stirn runzelt (Confusion Detection). Die KI wird ihre Stimmlage anpassen, empathischer klingen und das Lerntempo drosseln. Der Schüler wird auf seinem iPad eine Gleichung mit dem Stift kritzeln, und die KI analysiert den Rechenweg in Echtzeit über den Video-Stream. Die Latenzzeiten unter 400 Millisekunden ermöglichen eine natürliche Konversation, die sich wie ein menschliches Gespräch anfühlt. Für uns bei der AI-Software GmbH ist dies der Fokus unserer aktuellen Forschung und Entwicklung: Die Symbiose aus Kognitionspsychologie und hochperformanter multimodaler Streaming-Architektur.
Fazit: Handlungsdruck für Entscheidungsträger
Wir stehen an einem historischen Wendepunkt in der Vermittlung von Wissen. Verlage, EdTech-Unternehmen und Bildungsministerien müssen jetzt strategische Entscheidungen treffen. Die Technologie ist kein Proof of Concept mehr, sie ist produktionsreif und wird den Markt von Grund auf neu verteilen. Die Gefahr besteht darin, in Legacy-Systemen gefangen zu bleiben oder KI lediglich als kosmetisches Chat-Feature (Lipstick on a Pig) anzuflanschen. Erfolgreiche Integration verlangt einen grundlegenden architektonischen Neuentwurf: hin zu datengetriebenen, prädiktiven und vollpersonalisierten Lernpfaden. Organisationen, die diese Infrastruktur jetzt aufbauen, schaffen einen uneinholbaren strategischen Daten-Burggraben (Data Moat). Das maschinelle Verständnis darüber, wie ihre Nutzer lernen, wird zum wertvollsten Asset der Bildungsökonomie des 21. Jahrhunderts.
Bereit für das 2-Sigma-Level? Bauen Sie mit der AI-Software GmbH.
Die Architektur von bildungstechnologischen KI-Systemen duldet keine Kompromisse. Vertrauen Sie auf Experten, die die technischen und pädagogischen Fallstricke kennen. Die AI-Software GmbH entwickelt sichere, performante und voll skalierbare KI-Tutor-Systeme für EdTech-Unternehmen und Verlage. Kontaktieren Sie uns noch heute für einen Proof of Concept.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.