Urheberrecht und KI-Kunst: Die aktuelle Rechtslage für Entwickler und Unternehmen
Status Quo der Gerichtsentscheidungen zu Trainingsdaten, Overfitting und der Schutzfähigkeit von KI-Werken. Ein technischer Deep-Dive in juristische Fallstricke.
Inhalt
Das Wichtigste in Kürze
- Reiner Prompt-Output ist laut US Copyright Office (USCO) grundsätzlich nicht urheberrechtlich schützbar.
- Die TDM-Schranke der EU (Art. 4 DSM-RL) erlaubt kommerzielles Scraping, sofern kein maschinenlesbarer Opt-Out vorliegt.
- Overfitting (Memorization) in Diffusionsmodellen durchbricht die Schutzbehauptung des rein 'konzeptionellen Lernens'.
- Unternehmen benötigen zwingend B2B-Indemnification-Klauseln (Haftungsfreistellung) oder lizensierte Foundation Models.
Die Goldgräberstimmung der generativen KI kollidiert mit der harten Realität der globalen Rechtssysteme. Während Entwickler in rasantem Tempo immer mächtigere Modelle wie Midjourney v6 oder Stable Diffusion 3 auf den Markt werfen, ziehen Gerichte und Gesetzgeber in den USA und Europa nun die juristischen Leitplanken hoch. Die Illusion einer rechtlichen Grauzone ist längst verflogen. Als Software-Architekten und KI-Strategen bei der AI-Software GmbH beobachten wir täglich, wie Unternehmen katastrophale Compliance-Risiken eingehen, weil sie die tiefen technischen Mechanismen hinter dem Urheberrecht nicht verstehen. Dieser Artikel dekonstruiert den Status Quo – von der Datenbeschaffung bis zur Output-Generierung – und zeigt, wie man als Entscheider in diesem Minenfeld überlebt.
Die Illusion der rechtlichen Grauzone: Status Quo der Gerichte
Die rechtliche Bewertung von KI-generierten Inhalten hat in den letzten zwölf Monaten eine dramatische Wende vollzogen. Während die Industrie lange Zeit im Glauben an eine vermeintliche juristische Leerstelle agierte, haben aktuelle Leitentscheidungen eine unmissverständliche Realität geschaffen. Insbesondere der Fall Thaler v. Perlmutter aus dem August 2023 vor einem US-Bundesgericht hat die rechtliche Baseline weltweit zementiert: Ein rein durch KI generiertes Werk kann keinen Urheberrechtsschutz genießen, da das Konzept der 'Human Authorship' unabdingbar ist. Für Unternehmen, die unbedarft auf offene Modelle für ihre Core-Assets setzen, gleicht dies einem juristischen Blindflug mit massivem Haftungspotenzial. Wir bei der AI-Software GmbH müssen in unseren technischen Audits regelmäßig feststellen, wie toxisch unzureichend geklärte Assets in Unternehmensdatenbanken und Marketingmaterialien wirken, da Konkurrenten diese rechtlich ungeschützten Werke straffrei kopieren können.
100%
Ablehnungsquote des USCO bei reinen KI-Werken
5.85 Mrd
Gescrapte Bilder im LAION-5B Datensatz
35 Mio €
Maximale Strafe im neuen EU AI Act (oder 7% Umsatz)
Trainingsdaten: Fair Use oder systematischer Diebstahl?
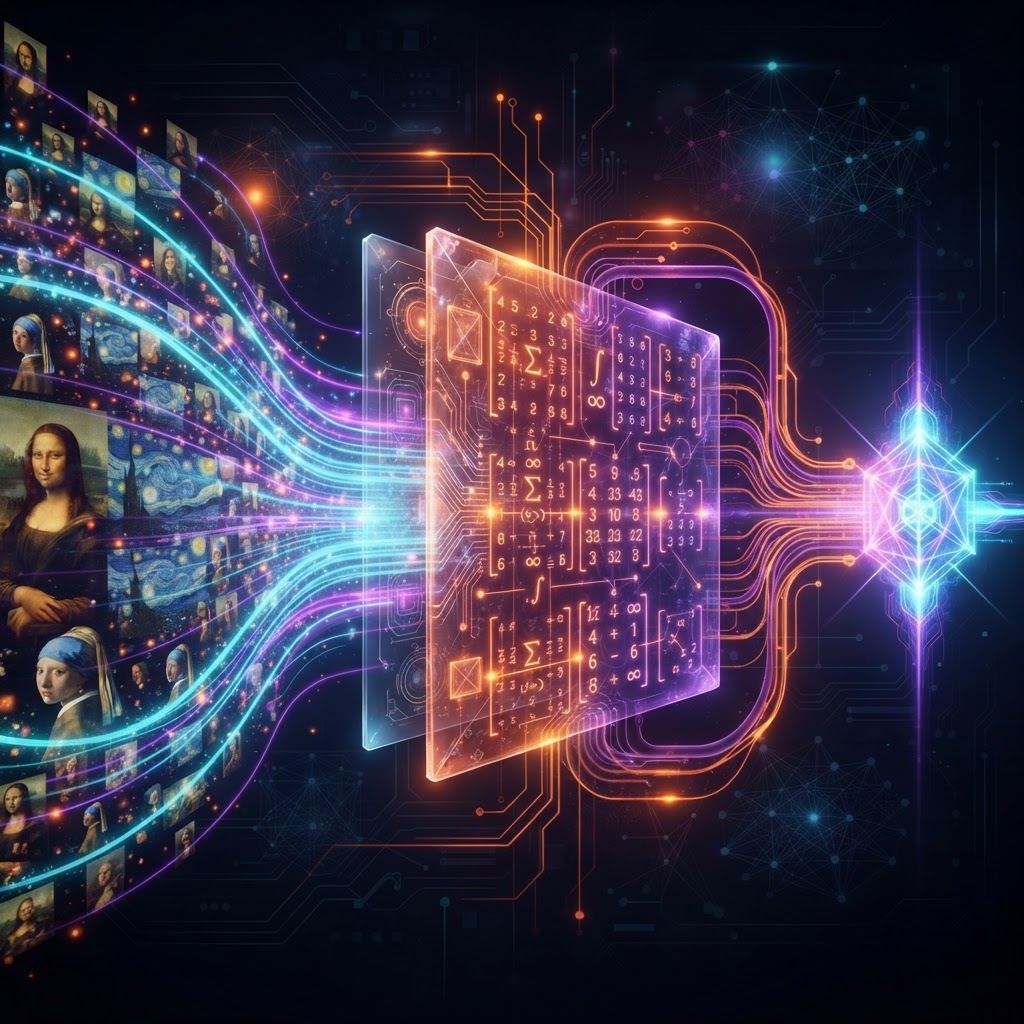
Das Fundament jeder generativen KI sind ihre Trainingsdaten, und genau hier entbrennt der erbittertste juristische Kampf unseres Jahrzehnts. Modellentwickler stützen sich in den USA massiv auf die 'Fair Use'-Doktrin, indem sie argumentieren, dass das Extrahieren statistischer Korrelationen aus urheberrechtlich geschützten Bildern hochgradig transformativ sei. Doch Klagen wie The New York Times vs. OpenAI (Dezember 2023) oder die Sammelklage von Künstlern gegen Midjourney und Stability AI attackieren diese Prämisse fundamental. Technisch gesehen laden Webcrawler Milliarden von Bildern herunter, wandeln sie in hochdimensionale Vektorräume (Latent Space) um und löschen die Originaldateien. Die Kläger beweisen jedoch zunehmend, dass der entstandene Algorithmus nicht nur Konzepte lernt, sondern als gigantisches, verlustbehaftetes Kompressionsarchiv fungiert. Wenn ein Modell auf Kommando das exakte Watermark von Getty Images reproduziert, zerfällt die 'Fair Use'-Verteidigung vor den Augen der Richter.
Achtung: Die europäische Opt-Out-Falle
In der EU greift für das KI-Training die Text-and-Data-Mining-Schranke (Art. 4 DSM-Richtlinie). Das Scraping ist legal, es sei denn, der Urheber hat einen maschinenlesbaren Opt-Out (z. B. in der robots.txt oder per C2PA-Metadaten) hinterlegt. Wer diesen Opt-Out beim Bau von Custom-Modellen ignoriert, begeht eine direkte Urheberrechtsverletzung.
Schutzfähigkeit von KI-Outputs: Der Human Authorship Standard
Die entscheidende Frage für Content-Produzenten lautet: Wann ist ein Werk menschlich genug, um geschützt zu werden? Das US Copyright Office hat im Fall von Kris Kashtanovas Comic 'Zarya of the Dawn' eine glasklare Trennlinie gezogen. Die textliche Handlung und das Layout der Seiten – beides menschlich erstellt – wurden urheberrechtlich geschützt, die durch Midjourney generierten Bilder jedoch explizit ausgenommen. Selbst hunderte Iterationen von Text-Prompts gelten juristisch lediglich als 'Auftragserteilung an einen Automaten', vergleichbar mit den Anweisungen an einen Taxifahrer, aber nicht als kreative Autorenschaft. Die Technologie operiert bei der Denoising-Phase des Diffusionsprozesses zu großen Teilen deterministisch basierend auf einem zufälligen Seed. Der menschliche Nutzer hat bei reinem Prompting keine prädiktive Kontrolle über die exakte Anordnung der Pixel, die Lichtführung oder die mikroskopische Komposition. Ohne diese präzise kreative Kontrolle versagt das Urheberrecht auf ganzer Linie.
Der Algorithmus ist keine Leinwand und der Prompt ist kein Pinsel. Solange die Maschine die finale expressive Ausgestaltung des Bildes durch den Denoising-Prozess diktiert, bleibt sie eine Blackbox – und Blackboxen bekommen kein Copyright.
Technische Steuerung: LoRA, ControlNet und der Weg zum Copyright
Der einzige juristisch gangbare Weg zur Erlangung von Schutzrechten führt aktuell über extreme technische Determinierung und extensive Nachbearbeitung. Wenn Entwickler der AI-Software GmbH KI-Workflows für Marketingabteilungen aufsetzen, raten wir strikt von simplen Text-to-Image-Prozessen ab. Stattdessen implementieren wir Architekturen, die ControlNet nutzen, um die exakte strukturelle Komposition (Canny-Edges, Depth-Maps) eines menschlichen Skizzen-Inputs zu erzwingen. Gepaart mit Low-Rank Adaptations (LoRA), die ausschließlich auf urheberrechtlich einwandfreien, internen Unternehmensdaten trainiert wurden, verschiebt sich die Rolle der KI vom autonomen Creator zum rein ausführenden Werkzeug. In Kombination mit nachweisbarer, substanzieller Nachbearbeitung in Programmen wie Photoshop (Inpainting, manuelles Blending) steigt die Wahrscheinlichkeit massiv, dass das finale Bild den juristischen Schwellenwert der menschlichen Schöpfungshöhe (Modulationshöhe) überschreitet.
Vorteile
- Rechtliche Absicherung durch kommerzielle Anbieter (Indemnification)
- Keine ungeschützten Firmen-Assets, die von Konkurrenten kopiert werden können
- Einhaltung der Transparenzpflichten des EU AI Acts gesichert
Nachteile
- Commercially safe Modelle (wie Adobe Firefly) sind oft ästhetisch schwächer als Midjourney
- Hoher technischer Aufwand für den Aufbau von ControlNet/LoRA-Pipelines
- Signifikante Lizenzkosten für rechtssichere B2B-APIs
Die technische Perspektive: Memorization und Overfitting
Die schärfste Waffe der Rechteinhaber in aktuellen Gerichtsverfahren ist der technische Nachweis von 'Memorization'. In der bahnbrechenden Studie 'Extracting Training Data from Diffusion Models' (Carlini et al., 2023) wurde empirisch bewiesen, dass Modelle wie Stable Diffusion tatsächlich exakte Pixelkopien aus ihren Trainingsdaten ausspucken können. Dies geschieht in der Regel durch Overfitting: Wenn ein bestimmtes Bild (beispielsweise ein berühmtes Filmposter oder das Wasserzeichen einer Stock-Foto-Agentur) zehntausendfach im Trainingsdatensatz dupliziert vorliegt, verankern sich die Gewichte im neuronalen Netz so spezifisch, dass der Latent Space nicht mehr abstrahiert, sondern speichert. Sobald Kläger vor Gericht demonstrieren, dass ein simpler Prompt wie 'Snoopy' eine 1:1 Kopie der urheberrechtlich geschützten Figur generiert, kollabiert die Argumentation der KI-Firmen, dass Modelle Bilder nur 'verstehen' wie ein menschlicher Künstler. Dies ist der Hauptgrund, warum kommerzielle B2B-Kunden extrem vorsichtig bei der Nutzung von Open-Weight-Modellen sein müssen.
Corporate Compliance: Best Practices für Enterprise-Kunden
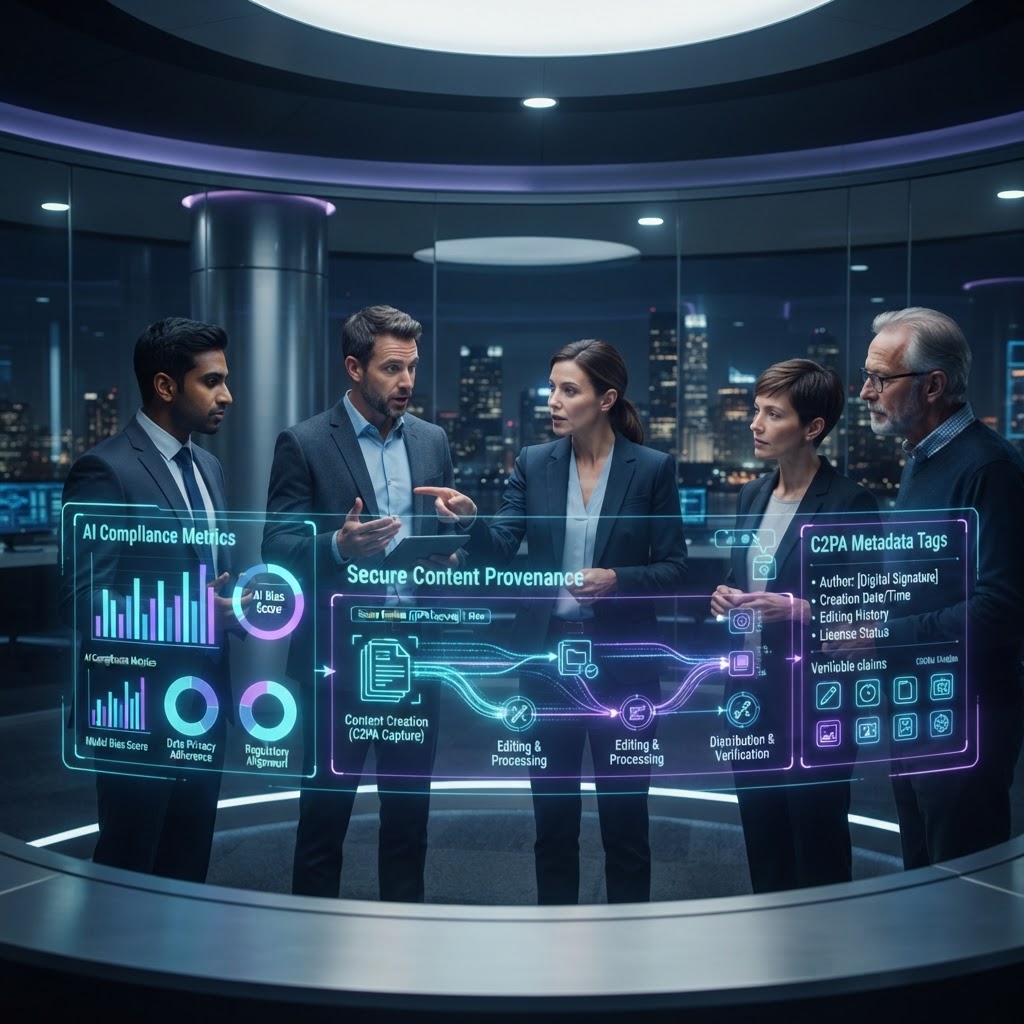
Für CTOs, CIOs und Marketing-Entscheider ergibt sich aus dieser volatilen Rechtslage eine absolute Handlungspflicht. Das unkontrollierte 'Schatten-Prompting' durch Mitarbeiter via Web-Interfaces muss sofort gestoppt werden. Stattdessen müssen Enterprise-Architekturen implementiert werden, die Rechtssicherheit by Design bieten. Die AI-Software GmbH integriert für Großkunden ausschließlich API-Endpunkte, die mit harten B2B-Haftungsfreistellungen (Copyright Indmenification) versehen sind, wie es Microsoft Copilot oder Adobe Firefly bieten. Parallel dazu müssen C2PA-Metadaten (Coalition for Content Provenance and Authenticity) in jeden generierten Asset-Workflow injiziert werden. Diese kryptografisch signierten Zertifikate protokollieren lückenlos, welches Modell, welche Seed-Nummer und welcher menschliche Input zur Erstellung des Bildes geführt haben. Nur mit einer solchen lückenlosen Provenance-Kette kann ein Unternehmen bei rechtlichen Streitigkeiten beweisen, dass die eigenen Assets sauber generiert oder ausreichend menschlich modifiziert wurden.
- 1
Audit: Identifizieren Sie alle unkontrollierten KI-Tools (Schatten-IT), die derzeit in Design- und Marketingteams genutzt werden.
- 2
Restrict: Sperren Sie die Nutzung von Web-Interfaces kommerziell unsicherer Modelle für die Erstellung von Firmen-Assets.
- 3
Implement: Beauftragen Sie Experten wie die AI-Software GmbH mit dem Aufbau einer C2PA-kompatiblen, geschlossenen KI-Pipeline.
- 4
Trace: Etablieren Sie ein revisionssicheres Logging-System für alle Prompts, Seeds und menschlichen Nachbearbeitungsschritte.
- 5
Train: Schulen Sie die Mitarbeiter im Umgang mit ControlNet und iterativen Img2Img-Prozessen zur Sicherstellung der Schöpfungshöhe.
Ausblick 2025-2027: Vom Scraping zur Lizenz-Ökonomie
Die Ära des rücksichtslosen, unregulierten Web-Scrapings (wie Common Crawl oder frühe LAION-Iterationen) neigt sich unweigerlich dem Ende zu. Getrieben durch den EU AI Act und bevorstehende Urteile in den USA bewegen wir uns rasant in Richtung einer regulierten Lizenz-Ökonomie. Große Player wie OpenAI haben dies längst erkannt und schließen strategische Multimillionen-Dollar-Deals mit Verlagen (Axel Springer, News Corp) und Plattformen (Reddit, StackOverflow), um proprietäre, saubere Trainingsdaten zu sichern. Für die Bildgenerierung erwarten wir einen massiven Shift hin zu Retrieval-Augmented Generation (RAG) für visuelle Medien, bei dem lizensierte Datenbanken dynamisch in den Diffusionsprozess eingebunden werden und Tantiemen über Smart Contracts oder Tracking-APIs direkt an die Originalkünstler fließen. Wer jetzt als Unternehmen seine KI-Strategie ausschließlich auf kostenlosen Scraping-Modellen aufbaut, baut sein digitales Fundament auf Treibsand. Zukünftige Modelle werden zwingend nachweisen müssen, dass jedes Gewicht im neuronalen Netz auf legal erworbenen Daten basiert.
- Haben wir vertragliche Haftungsfreistellungen unserer KI-Provider?
- Sind unsere KI-generierten Assets kryptografisch per C2PA signiert?
- Dokumentieren wir den Anteil der menschlichen Nachbearbeitung?
- Wurde ein unternehmensweiter Opt-Out für das Scraping unserer eigenen Daten eingerichtet?
- Entspricht unsere KI-Pipeline den Transparenzvorgaben des EU AI Acts?
Häufig gestellte Fragen (FAQ) zur KI-Rechtslage
Rechtssichere KI-Entwicklung mit der AI-Software GmbH
Überlassen Sie Ihre Corporate Compliance nicht dem Zufall oder der Unberechenbarkeit von Open-Weight-Modellen. Die Experten der AI-Software GmbH auditieren Ihre bestehenden Prozesse, implementieren C2PA-konforme Pipelines und trainieren rechtssichere Custom-KI-Modelle exklusiv für Ihr Unternehmen. Kontaktieren Sie uns noch heute für ein technisches und strategisches Erstgespräch.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.