Nachhaltige KI-Infrastrukturen: Wie Unternehmen den Energiehunger von LLMs drastisch senken
Von der Modellwahl über Quantisierung bis zum Liquid-Cooling-Rechenzentrum: Effiziente Strategien zur Reduzierung des Energieverbrauchs von Unternehmens-KI.
Inhalt
Das Wichtigste in Kürze
- Bis zu 90 % der CO2-Emissionen eines KI-Modells entstehen bei der Inferenz, nicht beim Training.
- Ein Right-Sizing der Modelle (Small Language Models + RAG) senkt den Energiebedarf drastisch bei vergleichbarer Präzision.
- Algorithmische Optimierungen wie 4-Bit-Quantisierung halbieren die Memory-Bandbreite und den Stromverbrauch.
- Der PUE-Wert (Power Usage Effectiveness) des Rechenzentrums entscheidet maßgeblich über die Scope-3-Emissionen in der ESG-Bilanz.
Während die IT-Welt gebannt auf immer neue Rekorde bei Parametergrößen und Kontextfenstern starrt, baut sich im Hintergrund eine massive Krise auf: Der exponentielle Energiehunger moderner generativer KI. Als KI-Stratege und Software-Architekt bei der AI-Software GmbH erlebe ich wöchentlich, wie Unternehmen unüberlegt monolithische Modelle für triviale Klassifizierungsaufgaben deployen und so nicht nur ihre Cloud-Budgets verbrennen, sondern auch ihre ESG-Ziele torpedieren. Es ist Zeit für einen fundamentalen Paradigmenwechsel in der KI-Infrastrukturplanung: Weg von Brute-Force, hin zu hochgradig optimiertem Green Computing.
Die unbequeme Wahrheit: Der reale Energieverbrauch von KI
Lassen Sie uns mit harten Fakten beginnen. Das Training von GPT-3 hat nach Schätzungen rund 1.287 Megawattstunden (MWh) Strom verschlungen. Bei Modellen der GPT-4-Klasse gehen Brancheninsider von Werten jenseits der 50 Gigawattstunden aus. Doch der wahre Infrastruktur-Killer ist nicht das Training, sondern die Inferenz – also die tägliche Nutzung des Modells in der Produktion. Eine einzige Suchanfrage über ein Large Language Model (LLM) verbraucht im Durchschnitt etwa zehnmal so viel Strom wie eine klassische Google-Suche. Jedes generierte Token erfordert Milliarden von Matrixmultiplikationen, die direkt in Abwärme und Stromverbrauch auf GPU-Ebene resultieren.
90 %
Anteil der Inferenz am Gesamt-Energieverbrauch eines Modells
10x
Energieverbrauch einer LLM-Suche vs. Standard-Suche
< 1.15
Ziel-PUE für moderne Green-AI-Rechenzentren
4-Bit
Quantisierung für optimale Balance aus Effizienz und Präzision
Für CTOs und IT-Entscheider ist dies längst kein rein ökologisches Problem mehr. Durch Richtlinien wie die europäische CSRD (Corporate Sustainability Reporting Directive) rücken die Scope-3-Emissionen, zu denen auch die gebuchten Cloud-Ressourcen gehören, direkt in den Fokus der Unternehmensbilanz. Wer heute eine ineffiziente KI-Architektur skaliert, baut enorme technische und regulatorische Schulden (Carbon Debt) auf. Wir bei der AI-Software GmbH verfolgen daher strikt einen 'Efficiency-First'-Ansatz, der beim Use-Case beginnt und bis ins Bare-Metal-Hosting reicht.
Architekturentscheidungen: Right-Sizing statt Kanonen auf Spatzen
Der schwerwiegendste Fehler in der heutigen KI-Planung ist der Reflex, für jedes Problem das größte und fähigste Cloud-Modell (z. B. GPT-4 oder Claude 3 Opus) über eine API anzuzapfen. Für eng umrissene Unternehmensanwendungen – etwa das Extrahieren von Metadaten aus Rechnungen oder RAG (Retrieval-Augmented Generation) auf internen Dokumenten – ist dies energetisch absurd. Ein spezifisch auf diesen Task feinabgestimmtes Small Language Model (SLM) wie Llama-3-8B oder Mistral-7B liefert oft identische oder bessere Ergebnisse bei einem Bruchteil des Rechenaufwands.
Vorteile
- Lokale Small Language Models (SLMs) benötigen massiv weniger Compute (FLOPs) pro generiertem Token.
- Volle Kontrolle über Hardware-Auslastung, Caching und Batching in der eigenen Infrastruktur.
- Reduzierte Latenzzeiten und Unabhängigkeit von den Blackbox-Emissionswerten der großen API-Anbieter.
Nachteile
- Geringere Zero-Shot-Fähigkeiten bei extrem komplexen, domänenübergreifenden Logikaufgaben.
- Aufwändigere initiale Setup- und Fine-Tuning-Phase für das interne Entwicklerteam.
- Manuelles Management der Server-Infrastruktur erforderlich (sofern nicht als Managed Service bezogen).
Algorithmische Effizienz: Quantisierung und PagedAttention
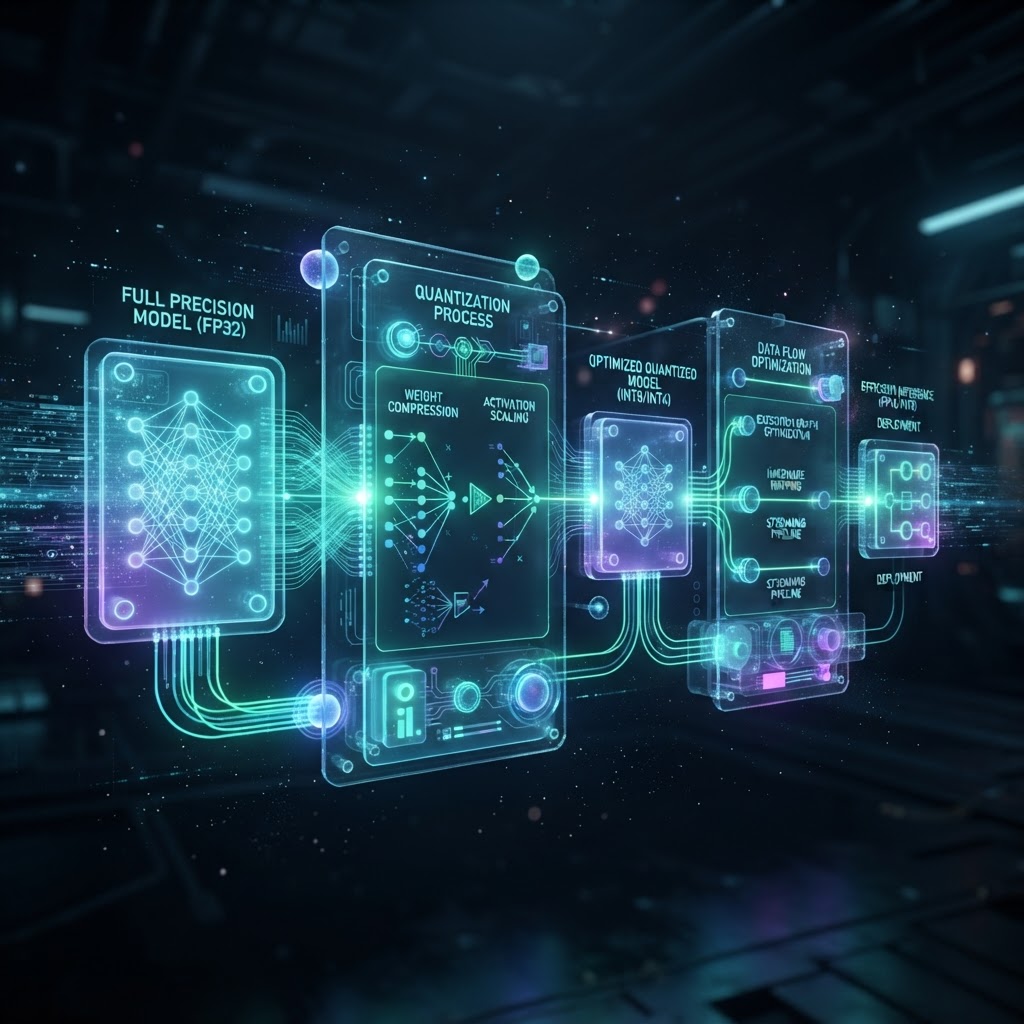
Selbst wenn die Modellgröße reduziert wurde, liegt massives Einsparpotenzial in der Art und Weise, wie die Gewichte des neuronalen Netzes im Speicher der GPU verarbeitet werden. High Bandwidth Memory (HBM) ist der Flaschenhals und größte Energiefresser bei generativer KI. Durch Quantisierung reduzieren wir die Präzision der Modellgewichte von 16-Bit-Fließkommazahlen (FP16) auf 8-Bit (INT8) oder sogar 4-Bit (INT4). Dies halbiert nicht nur den benötigten VRAM, sondern reduziert den Energieaufwand für den Datentransfer zwischen Speicher und Recheneinheit drastisch. Frameworks wie vLLM in Kombination mit PagedAttention sorgen zudem dafür, dass der Key-Value (KV) Cache fragmentierungsfrei verwaltet wird. Das erhöht die maximal mögliche Batch-Größe und senkt den Energieaufwand pro Request erheblich.
Insider-Tipp zur Quantisierung
Achtung vor Über-Quantisierung: Während reine Texterstellung selbst bei INT4 kaum an Qualität einbüßt, brechen die Fähigkeiten bei mathematischem Reasoning und komplexer Code-Generierung oft katastrophal ein. Wir bei der AI-Software GmbH führen stets rigorose Benchmarks durch, um den genauen 'Sweet Spot' zwischen ökologischer Effizienz und Modellqualität für Ihren spezifischen Use-Case zu finden.
Hardware-Evolution: Warum eine H100 ökologischer sein kann als eine A100
Auf Hardware-Ebene mag es zunächst kontraintuitiv klingen: Eine NVIDIA H100 (Hopper-Architektur) verbraucht mit bis zu 700 Watt fast doppelt so viel Strom unter Volllast wie das Vorgängermodell A100 (400 Watt). Dennoch ist sie für Green Computing oft die bessere Wahl. Der Grund liegt im Durchsatz. Die H100 berechnet Inferenz-Workloads etwa dreimal so schnell. Bricht man den Energieverbrauch auf das einzelne generierte Token herunter, ist die neuere Generation effizienter – vorausgesetzt, die Auslastung (Utilization) wird hochgehalten. Eine im Leerlauf laufende High-End-GPU ist ein ökologischer Albtraum. Zukünftig werden wir zudem eine massive Verlagerung weg von Allzweck-GPUs hin zu hochspezialisierten Inference-Chips (NPUs und LPUs wie Groq) sehen, die den Energieverbrauch pro Token um den Faktor 10 senken können.
Green Data Centers: Kühltechnologien und Carbon-Aware Routing
Die physische Infrastruktur bildet das Fundament nachhaltiger KI. Traditionelle Server-Racks erzeugen etwa 10 bis 20 Kilowatt (kW) Abwärme und können mit klassischer Luftkühlung betrieben werden. KI-Racks mit dichter GPU-Bestückung erreichen jedoch schnell 40 bis 120 kW. Hier versagt die Luftkühlung nicht nur physikalisch, sie wird auch extrem ineffizient. Moderne Rechenzentren für nachhaltige KI setzen zwingend auf Direct-to-Chip (D2C) Liquid Cooling oder vollständige Immersion Cooling. Dies senkt den PUE-Wert (Power Usage Effectiveness) von durchschnittlich 1.5 auf Werte nahe 1.1.
Die nachhaltigste KI ist nicht diejenige, die am schnellsten rechnet. Es ist diejenige, die Leerlaufzyklen eliminiert, Hardwareauslastung maximiert und ihre Abwärme in städtische Heiznetze zurückführt.
Der Blueprint: Nachhaltige KI in die Produktion bringen
- 1
Use-Case Evaluierung: Ist Generative AI zwingend nötig, oder reicht ein klassisches Machine-Learning-Modell (z. B. XGBoost) für die Kategorisierung aus?
- 2
Modell-Auswahl (Right-Sizing): Starten Sie immer mit dem kleinstmöglichen Modell (z. B. 7B oder 8B Parameter) und erweitern Sie dessen Wissen via RAG, statt auf 70B+ Parameter zu setzen.
- 3
Software-Optimierung: Nutzen Sie High-Performance-Inferenz-Server wie vLLM oder TensorRT-LLM und wenden Sie mindestens W8A8 (8-Bit Weights/Activations) Quantisierung an.
- 4
Infrastruktur-Audit: Überprüfen Sie den Strommix und den PUE-Wert des Hosters. Setzen Sie auf Anbieter mit 100 % echten erneuerbaren Energien und modernen Kühlkonzepten.
- 5
Kontinuierliches Monitoring: Implementieren Sie FinOps/GreenOps-Dashboards, die nicht nur Latenz und Kosten, sondern auch den CO2-Ausstoß pro 1.000 generierten Token tracken.
Die größte Hürde in der Umsetzung ist oft organisatorischer Natur. Data Scientists wollen mit den größten und fähigsten Modellen arbeiten, während die Infrastruktur-Teams die explodierenden Cloud-Kosten und ESG-Budgets verantworten müssen. Um diese Lücke zu schließen, bedarf es strenger Governance und einer gelebten 'Green FinOps'-Kultur im Unternehmen. Ohne messbare Metriken für Energie pro Token wird Effizienz zu einem theoretischen Wunschdenken, das im operativen Alltag der agilen Entwicklung schnell untergeht.
- Sind regelmäßige und asynchrone Inferenz-Aufgaben zu Batches zusammengefasst, um die GPU auszulasten?
- Wird Semantic Caching genutzt, um identische oder ähnliche Prompts ohne erneute Modellberechnung zu beantworten?
- Ist das Modell auf INT8 oder INT4 quantisiert worden, ohne die fachliche Kernmetrik zu verletzen?
- Verfügt das Rechenzentrum über einen PUE-Wert unter 1.2 und ein zertifiziertes Ökostrom-Konzept?
Ausblick: Die nächsten 36 Monate im Sustainable AI Computing
Der technologische Fortschritt wird uns in den kommenden drei Jahren Werkzeuge an die Hand geben, um das Energieproblem auf architektonischer Ebene zu lösen. MoE-Architekturen (Mixture of Experts) werden zum Standard werden, selbst bei Modellen mit weniger als 10 Milliarden Parametern. Durch MoE wird für jedes Token nur ein Bruchteil des neuronalen Netzes (oft weniger als 10 %) aktiviert, was den Energiebedarf bei der Inferenz drastisch senkt. Parallel dazu wird Carbon-Aware Routing populär: Batch-Verarbeitungen werden dynamisch in die Rechenzentren verschoben, in denen gerade ein Überschuss an Wind- oder Solarenergie herrscht. Die AI-Software GmbH bereitet diese Infrastrukturen bereits heute für Enterprise-Kunden vor.
Unternehmen, die das Thema nachhaltige KI-Infrastruktur heute ignorieren, werden sehr bald in eine Kosten- und Compliance-Falle tappen. Die Regulatorik in Europa zieht merklich an, und ineffiziente IT-Architekturen werden zukünftig durch CO2-Steuern und ESG-Penalties teuer bezahlt. Die technische Schuld von heute ist unweigerlich die Carbon Debt von morgen. Jetzt ist der Zeitpunkt, die Weichen auf hocheffiziente, skalierbare und saubere KI-Prozesse zu stellen.
Bereit für ressourcenschonende und leistungsstarke KI?
Stoppen Sie den Energie- und Budget-Burnrate Ihrer KI-Projekte. Die Experten der AI-Software GmbH analysieren Ihre Architekturen, optimieren Ihre Modelle und implementieren performante Green-AI-Lösungen, die Ihre ESG-Ziele unterstützen.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.