Souveräne Datenräume: GAIA-X und die Evolution industrieller KI-Ökosysteme
Während US-Hyperscaler das KI-Rennen dominieren, baut Europa mit GAIA-X eine föderierte Gegenmacht. Ein exklusiver Deep-Dive in die Architektur souveräner Datenräume für unternehmensübergreifendes KI-Training.
Inhalt
Das Wichtigste in Kürze
- Souveränität ist nicht Verschlüsselung: Echte Data Sovereignty erfordert dezentrale Trust Frameworks und algorithmisch durchgesetzte Nutzungskontrollen.
- Federated Learning als Gamechanger: Durch die Kombination von GAIA-X-Datenräumen und dezentralem KI-Training wandern Algorithmen zu den Daten, nicht umgekehrt.
- Semantik vor Infrastruktur: Ohne unternehmensübergreifende Daten-Ontologien (z.B. Asset Administration Shells) bleiben die besten Datenräume für KI wertlos.
- Strategischer Imperativ: Wer heute keine föderierten Daten-Pipelines aufbaut, verliert in den nächsten 24 Monaten den Anschluss an kollaborative Industrie-Modelle.
Die industrielle KI steht an einem Scheideweg. Während die B2C-Welt ihre gigantischen Foundation Models durch das schamlose Scraping des offenen Internets befeuert, dörren B2B-Anwendungen systematisch aus. Maschinenbauer, Automobilisten und Logistiker sitzen auf Petabytes an hochkarätigen Telemetrie- und Prozessdaten, doch aus Angst vor IP-Verlust und Vendor-Lock-in bleiben diese in lokalen Silos isoliert. Die Lösung liegt nicht im Bau noch größerer zentraler Data Lakes, sondern in der radikalen Föderierung. Mit GAIA-X und souveränen Datenräumen manifestiert sich aktuell ein Architektur-Paradigma, das es Unternehmen erlaubt, KI-Modelle grenzüberschreitend zu trainieren, ohne jemals die Kontrolle über ihre Rohdaten abzugeben.
Das Dilemma der industriellen KI: Datensilos vs. Modellhunger
Ein KI-Modell ist auf Enterprise-Ebene immer nur exakt so leistungsfähig wie die Datenbasis, auf der es operiert. In der stark fragmentierten B2B-Welt Europas führt diese unumstößliche Tatsache zu einem handfesten Architektur-Dilemma, das viele Digitalisierungsstrategien im Keim erstickt. Einerseits benötigen Algorithmen für Predictive Maintenance, Supply Chain Optimierung oder komplexe Computer-Vision-Aufgaben domänenübergreifende Datensätze in nie dagewesener Tiefe. Andererseits verbietet es der Schutz von Geschäftsgeheimnissen und intellektuellem Eigentum strikt, hochsensible Maschinen- oder Prozessdaten in zentrale Cloud-Infrastrukturen der wenigen US-Hyperscaler zu spiegeln. Wir befinden uns in einem industriellen 'Mexican Standoff': Alle Akteure entlang der Wertschöpfungskette haben wertvolle Daten, alle brauchen bessere KI-Modelle, aber niemand zieht zuerst und gibt seine Kronjuwelen unkontrolliert aus der Hand. Ohne eine vertrauenswürdige, dezentrale Infrastruktur stagniert die unternehmensübergreifende KI-Entwicklung unweigerlich auf ewigem Proof-of-Concept-Niveau.
~85%
der generierten Industriedaten in der EU bleiben ungenutzt
150+
Partner im Catena-X Netzwerk für souveränen Datenaustausch
2025
Inkrafttreten des EU Data Acts, der Datenteilung gesetzlich forciert
Die bisherigen Ansätze zur Lösung dieses Problems waren meist von kurzsichtigem Pragmatismus geprägt und scheiterten gnadenlos an Skalierbarkeit oder Compliance. Bilaterale API-Anbindungen zwischen Partnern erzeugen exponentielle Komplexität ('Spaghetti-Architektur') und lassen sich juristisch kaum in skalierbare Verträge gießen. Gleichzeitig bieten traditionelle Cloud-Anbieter zwar Verschlüsselung im Ruhezustand (Encryption at Rest) und beim Transport (in Transit), aber fast nie echte Souveränität während der Verarbeitung (in Use). Um dieses logische Patt zu durchbrechen, benötigt die Industrie zwingend einen Paradigmenwechsel weg von monolithischen Datensilos hin zu föderierten, interoperablen Ökosystemen. Genau hier setzt das Konzept der souveränen Datenräume an, das durch die GAIA-X-Initiative erstmals eine standardisierte technische Realität erhält.
GAIA-X: Vom Buzzword zum belastbaren Architektur-Paradigma
Wer GAIA-X auch im Jahr 2024 noch für eine europäische Konkurrenz zu AWS oder Azure hält, hat das grundlegende Architektur-Paradigma nicht im Ansatz verstanden. GAIA-X baut keine neuen Rechenzentren, sondern definiert eine föderierte Meta-Ebene, ein sogenanntes Trust-Framework, das sich wie eine hochsichere Membran über bestehende Cloud-, Edge- und On-Premise-Infrastrukturen legt. Der Kern dieses Frameworks ist die konsequente architektonische Trennung von Datenspeicherung und Datennutzungskontrolle. Daten verbleiben physisch immer beim Besitzer, während die Nutzungsrechte kryptografisch via Smart Contracts und Verifiable Credentials dezentral ausgehandelt werden. Nur wenn alle algorithmischen und vertraglichen Bedingungen eines elektronischen 'Data Contracts' zweifelsfrei erfüllt sind, wird ein dedizierter Datenfluss initiiert – oft nur für den exakten Zeitraum und Zweck eines KI-Trainingslaufs.
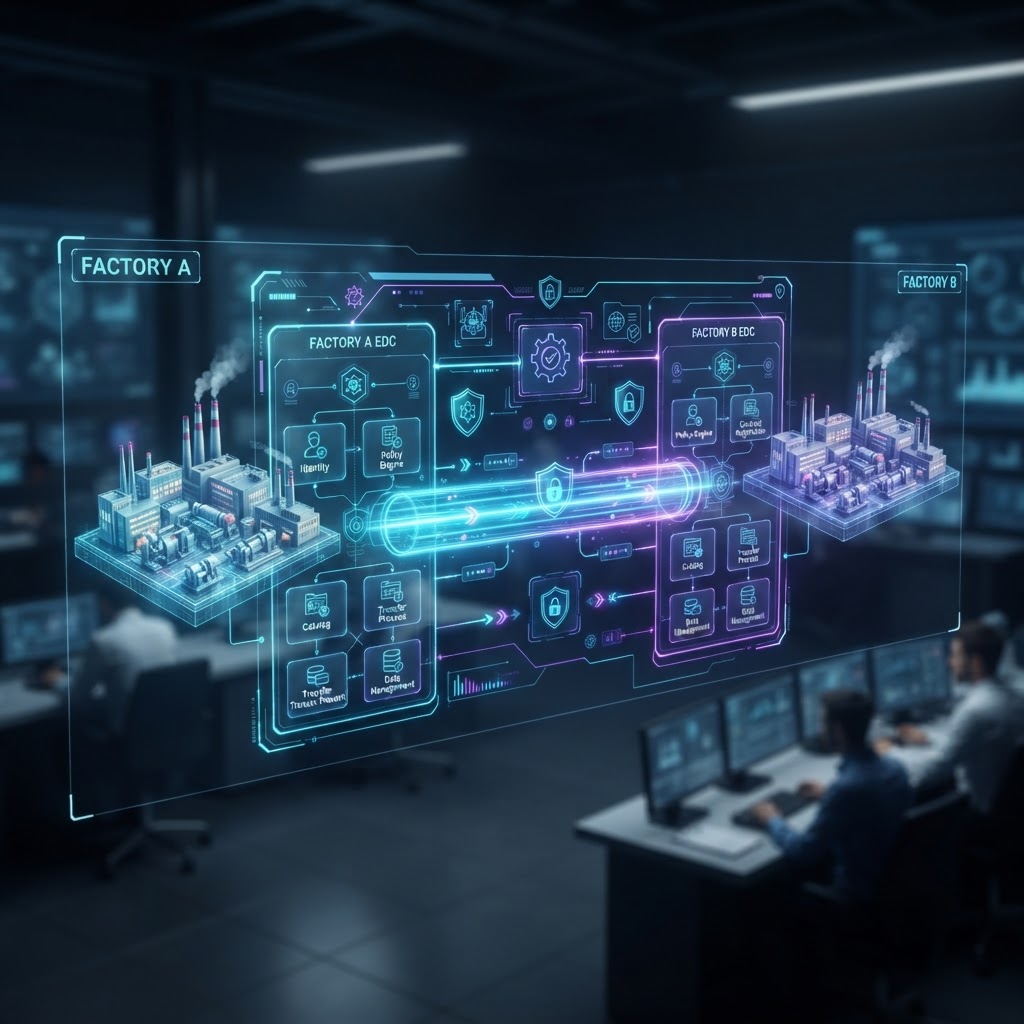
Das technologische Herzstück dieser souveränen Datenräume bilden die sogenannten Eclipse Dataspace Components (EDC), die als standardisierte Gateways zwischen den Akteuren fungieren. Ein EDC orchestriert den gesamten Lebenszyklus eines dezentralen Datenaustauschs: von der Identitätsprüfung über die Aushandlung der Vertragsbedingungen per Dataspace Protocol (DSP) bis hin zur reinen Datenübertragung auf der Data Plane. Der entscheidende Vorteil für das Training von Machine-Learning-Modellen liegt in der vollständigen Nachvollziehbarkeit und der granularen Zugangskontrolle. Als federführende Architekten bei der AI-Software GmbH implementieren wir EDCs so, dass beispielsweise ein LLM-Trainings-Job nur hochspezifischen Lesezugriff auf ausgewählte Sensordaten erhält und die finale Modellausgabe kryptografisch signiert wird. So garantieren wir unseren Kunden, dass ihre kritischen Rohdaten niemals unkontrolliert in einem fremden Modellgewichts-Update verschwinden, sondern exakt im Rahmen des vorher definierten Zwecks genutzt werden.
Der Trugschluss der Pseudo-Souveränität
Wer glaubt, eine HTTPS-verschlüsselte REST-API, ein klassisches IAM-System und ein juristischer NDA reichten für 'Data Sovereignty' aus, irrt gewaltig. Wahre Souveränität bedeutet, dass technische Systeme – nicht Papierverträge – den Missbrauch von Daten algorithmisch unmöglich machen.
Architektur souveräner KI-Ökosysteme: Der moderne Tech-Stack
Die wahre Magie entsteht jedoch erst dann, wenn wir souveräne Datenräume mit modernen, verteilten KI-Methoden wie Federated Learning (FL) oder Secure Multi-Party Computation (SMPC) verheiraten. In einer klassischen, antiquierten Architektur müssten für ein unternehmensübergreifendes Supply-Chain-Optimierungsmodell alle Lieferanten ihre ERP-Daten in eine zentrale Cloud pushen. Im Rahmen eines GAIA-X-kompatiblen Ökosystems drehen wir diesen architektonischen Spieß radikal um: Das untrainierte KI-Modell reist zu den Daten. Über das EDC-Gateway schickt der Aggregator das Modell an den lokalen Edge-Knoten des Lieferanten, wo es isoliert auf den hochsicheren lokalen Daten trainiert wird. Danach fließen lediglich die aktualisierten Modellgewichte (Gradients) – mathematisch verfremdet und ohne Rückschlussmöglichkeit auf die Rohdaten – zurück ins zentrale Ökosystem zur Aggregation.
- Identity Trust Framework: Dezentrale Identitäten (DID) und Verifiable Credentials zur zweifelsfreien Authentifizierung der Teilnehmer.
- Control Plane (EDC): Verhandelt Metadaten, Policies und Data Contracts automatisiert via Dataspace Protocol (DSP).
- Data Plane: Die tatsächliche, hochperformante Datenübertragungsebene (z.B. via S3, Kafka, HTTP), streng getrennt von der Kontrollebene.
- Federated Learning Aggregator: Orchestriert die Verteilung der untrainierten Modelle und die Aggregation der zurückkehrenden Gradienten.
- Privacy Enhancing Technologies (PETs): Einsatz von Differential Privacy und Homomorphic Encryption zum Schutz vor Inversion-Attacks.
Dieser proaktive Prozess der reinen Gewichtsextraktion eliminiert das Risiko des IP-Verlusts fast vollständig und ermöglicht erstmals tiefes kollaboratives Lernen unter direkten Konkurrenten, die sogenannte Coopetition. Um jedoch extrem feingranulare Angriffe auf die Modellgewichte (wie Model Inversion Attacks oder Membership Inference) zu verhindern, härten wir bei der AI-Software GmbH diese Federated-Pipelines zusätzlich mit Differential Privacy und homomorpher Verschlüsselung ab. Dadurch bleibt das Modell während des gesamten Aggregationsprozesses kryptografisch geschützt; selbst der orchestrierende zentrale Server sieht lediglich mathematisches Rauschen, bis das finale, gemittelte Modell entschlüsselt wird. Solche hybriden Architekturen sind keine akademische Spielerei mehr, sondern zwingende Voraussetzung für den Aufbau hochpräziser Foundation Models in Sektoren wie der Automobilindustrie oder dem Gesundheitswesen, wo Datensicherheit über Milliarden-Patente entscheidet.
Make-or-Buy? Der strategische Weg zur Data Sovereignty
Vorteile
- Volle architektonische und strategische Kontrolle über Governance, Policies und Erweiterungen.
- Maßgeschneiderte semantische Ontologien perfekt an die internen Systemgrenzen angepasst.
- Keine Abhängigkeit von den Entwicklungszyklen oder Roadmaps externer Konsortien.
Nachteile
- Immenser initialer Investitionsbedarf (CAPEX) für den Aufbau eines eigenen Trust Frameworks.
- Netzwerkeffekt bleibt aus: Das extrem mühsame Onboarding von Partnern bremst den ROI.
- Gefahr von neuen 'Makro-Silos', die in der Zukunft nicht mit Catena-X oder Manufacturing-X kompatibel sind.
Aus Sicht eines strategisch denkenden CTOs stellt sich beim Aufbau solcher kritischen Infrastrukturen zwangsläufig die Make-or-Buy-Frage, die tiefgreifende langfristige Konsequenzen nach sich zieht. Ein eigener, proprietärer Datenraum bietet zunächst maximale Kontrolle über Governance-Regeln und technische Schnittstellen, erfordert jedoch immense Investitionen in den Aufbau einer Zertifizierungsstelle und das langwierige Onboarding von Zulieferern. Das direkte Anschließen an etablierte Leuchtturm-Ökosysteme wie Catena-X oder Manufacturing-X bietet hingegen sofortige Interoperabilität und Zugang zu hunderten von Teilnehmern, zwingt das Unternehmen aber unweigerlich in ein streng vorgegebenes semantisches Korsett. Die harte Realität in unseren Consulting-Projekten zeigt, dass inkrementelle hybride Strategien am erfolgreichsten sind: Unternehmen etablieren interne Datenräume zur Aufhebung eigener Konzern-Silos als agiles Übungsfeld und verbinden diese später als föderierten Super-Knoten mit großen Branchen-Ökosystemen. Dieser evolutionäre Weg minimiert das Risiko von Fehlinvestitionen und baut das dringend benötigte interne Know-how im Umgang mit Datensouveränität organisch auf.
Daten-Souveränität ist kein juristisches Feigenblatt, das man auf eine API klebt, sondern ein knallhartes technisches Fundament. Wer heute keine föderierten Datenräume baut, wird morgen von den KI-Wertschöpfungsketten der Industrie schlichtweg ausgeschlossen.
In 5 Schritten zum GAIA-X-kompatiblen KI-Use-Case
- 1
Data Readiness Check: Klassifizierung der Datenbestände nach Kritikalität und Harmonisierung der Metadaten auf offene Standards (z.B. Asset Administration Shell).
- 2
Trust Framework Setup: Etablierung oder Anbindung an einen dezentralen Identity Provider zur Ausstellung von Verifiable Credentials für Maschinen und Akteure.
- 3
EDC Deployment: Implementierung der Eclipse Dataspace Components (Control Plane und Data Plane) als sicheres Gateway vor den bestehenden Data Lakes.
- 4
Federated Pipeline Design: Architektur des Machine-Learning-Workflows, Definition von Model Aggregation Strategies (z.B. FedAvg) und Edge-Deployments.
- 5
Contract Negotiation Engineering: Codierung der rechtlichen Datennutzungsbedingungen in maschinenlesbare ODRL-Policies (Open Digital Rights Language).
Trotz der rasanten technologischen Reife von Kernkomponenten wie dem EDC scheitern viele PoCs in der harten Praxis an fehlender semantischer Interoperabilität und mangelnder Datenhygiene. Ein souveräner Datenraum regelt auf Protokollebene zwar das 'Wie' und 'Wer' des Datenaustauschs in Perfektion, aber wenn das 'Was' – also die innere Struktur und Semantik der Datensätze – nicht domänenübergreifend harmonisiert ist, bleibt das KI-Modell blind und ineffektiv. Das Mapping von historisch gewachsenen proprietären Legacy-Daten auf standardisierte Formate oder branchenspezifische Ontologien verschlingt in echten Industrie-Projekten oft bis zu 70% der gesamten Entwicklungszeit. Wir bei der AI-Software GmbH raten deshalb in jedem Strategieworkshop dringend dazu, die Datenraum-Integration niemals als reines IT-Infrastrukturprojekt abzustempeln. Es ist in allererster Linie ein fundamentales Data-Engineering-Vorhaben, das eine tiefgreifende Analyse der eigenen Datenlandschaft und die kompromisslose Einführung moderner Data-Mesh-Prinzipien erfordert, lange bevor der erste EDC in Produktion geht.
Ausblick 2025-2027: Wenn LLMs über Unternehmensgrenzen hinweg lernen
Blicken wir 12 bis 36 Monate in die Zukunft, wird sich der strategische Fokus von klassischen tabellarischen Machine-Learning-Use-Cases rasant in Richtung föderierter Large Language Models (LLMs) verschieben. Wir werden revolutionäre Architekturen in Produktion sehen, in denen unternehmensübergreifende RAG-Pipelines (Retrieval-Augmented Generation) nativ über GAIA-X-Datenräume hinweg operieren. Ein KI-Agent eines Automobilherstellers könnte dann souverän, automatisiert und vollständig auditsicher technische Spezifikationen tief in den Systemen seiner Tier-1- und Tier-2-Zulieferer abfragen, ohne dass diese ihre intellektuellen Konstruktionsdaten jemals in eine öffentliche Vector-Database laden müssen. Die Integration von Smart Contracts wird zudem völlig neue Monetarisierungsmodelle für den B2B-Datenmarkt hervorbringen: Das klassische 'Data as a Service' (DaaS) wandelt sich zu 'AI Insights as a Service', bei dem Unternehmen vollautomatisch Micro-Payments in Echtzeit erhalten, wenn ihre kryptografisch gesicherten Daten maßgeblich zur Vorhersagegenauigkeit eines föderierten KI-Modells beigetragen haben. Eines ist dabei sicher: Wer den Aufbau dieser souveränen Infrastruktur heute aus falscher Sparsamkeit verschläft, wird im exponentiell wachsenden KI-Ökosystem von morgen schlichtweg nicht mehr existieren.
Bauen Sie Ihr souveränes KI-Ökosystem mit der AI-Software GmbH
Sind Ihre Daten bereit für das kollaborative KI-Zeitalter? Die Experten der AI-Software GmbH analysieren Ihre Infrastruktur und designen mit Ihnen eine maßgeschneiderte, souveräne Datenraum-Architektur nach GAIA-X-Standards. Kontaktieren Sie uns noch heute für ein unverkrampftes Tech-Sparring.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.