AI-driven CI/CD Pipelines: Wie LLMs Test-Suiten und Deployments in der Cloud revolutionieren
Klassische Pipelines sind starr und wartungsintensiv. Erfahren Sie, wie intelligente LLM-Orchestrierung CI/CD-Prozesse automatisiert, fehlschlagende Tests selbst heilt und Deployments sicherer macht.
Inhalt
Das Wichtigste in Kürze
- Klassisches CI/CD skaliert nicht mehr: Der Wartungsaufwand für statische Pipelines und Flaky Tests frisst bis zu 40% der Entwicklungsressourcen.
- LLMs als Orchestratoren: Modelle wie Claude 3.5 Sonnet und GPT-4o übernehmen die dynamische Steuerung von Test-Suiten und Fehleranalysen in Echtzeit.
- Self-Healing Tests: KI-Agenten reparieren defekte Unit-Tests autonom durch semantisches Code-Verständnis und RAG-basierten Zugriff auf Git-Historien.
- Autonomous Deployments: LLM-gestützte Canary-Analysen werten Datadog- oder Prometheus-Metriken aus, um Rollbacks bei Anomalien in Millisekunden auszuführen.
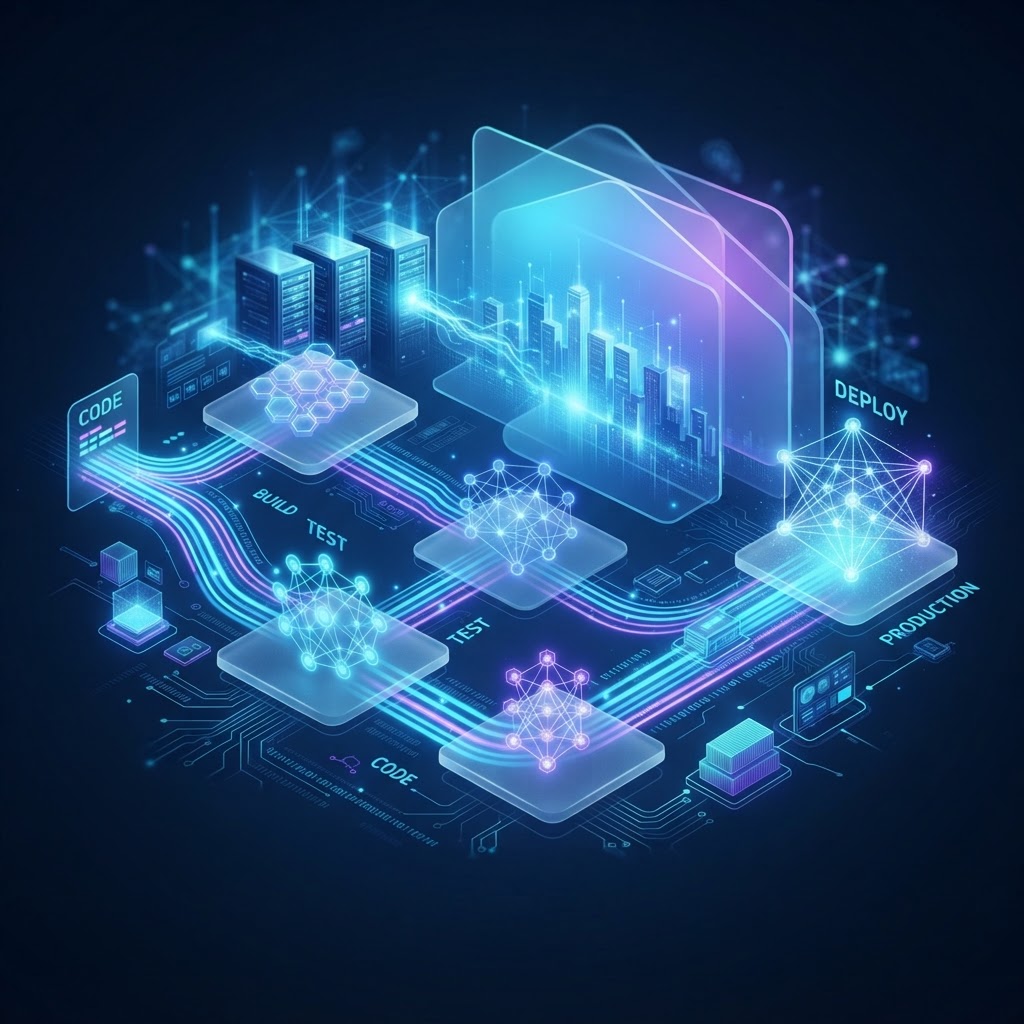
Für mehr als ein Jahrzehnt war das Paradigma der Softwarebereitstellung klar: Wir definieren deterministische, YAML-basierte Workflows, die Code von Commit zu Produktion pushen. Doch wer heute komplexe Cloud-native Microservices skaliert, stößt auf eine harte Realität: Die schiere Masse an Integrationstests, Konfigurations-Drifts und inkonsistenten Deployment-Logs überfordert herkömmliche Regelwerke. Als Architekt, der in den letzten 15 Jahren DevOps-Strukturen für DAX-Konzerne entworfen hat, sage ich Ihnen: Die Zukunft gehört nicht dem nächsten YAML-Linter. Die Zukunft gehört Agentic Workflows. AI-driven CI/CD Pipelines verlagern die Entscheidungsgewalt von starren Skripten auf große Sprachmodelle (LLMs), die Kontext begreifen, Anomalien erkennen und Pipelines in Echtzeit adaptieren.
1. Der Status Quo: Warum klassisches CI/CD an seine Grenzen stößt
Wenn wir uns die DORA-Metriken (DevOps Research and Assessment) moderner Enterprise-Teams ansehen, fällt ein paradoxer Trend auf: Obwohl wir leistungsfähigere Tools als je zuvor besitzen, stagniert die Deployment Frequency in vielen Bereichen. Der Flaschenhals ist die Wartung der Pipeline selbst. Entwickler verbringen unzählige Stunden damit, False-Positives aus Test-Suiten herauszufiltern, 'Flaky Tests' (Tests, die ohne Codeänderung abwechselnd bestehen und fehlschlagen) zu debuggen und Deployment-Skripte an neue Cloud-Infrastrukturen anzupassen. Die rein deterministische Natur klassischer CI/CD-Systeme wie Jenkins, GitLab CI oder GitHub Actions bedeutet, dass sie beim kleinsten unvorhergesehenen Fehler abbrechen. Sie haben keinen Kontext zu dem, was das System eigentlich erreichen soll, sondern führen nur blind Befehle aus. Das führt zu massiven Verzögerungen in der Time-to-Market und frustriert hochbezahlte Engineering-Teams.
45%
Zeitaufwand für Pipeline-Wartung
60%
Anteil an Flaky Tests bei Großprojekten
3.5x
Schnellere MTTR mit KI-Support
2. LLM-Orchestrierung: Die Architektur einer kognitiven Pipeline
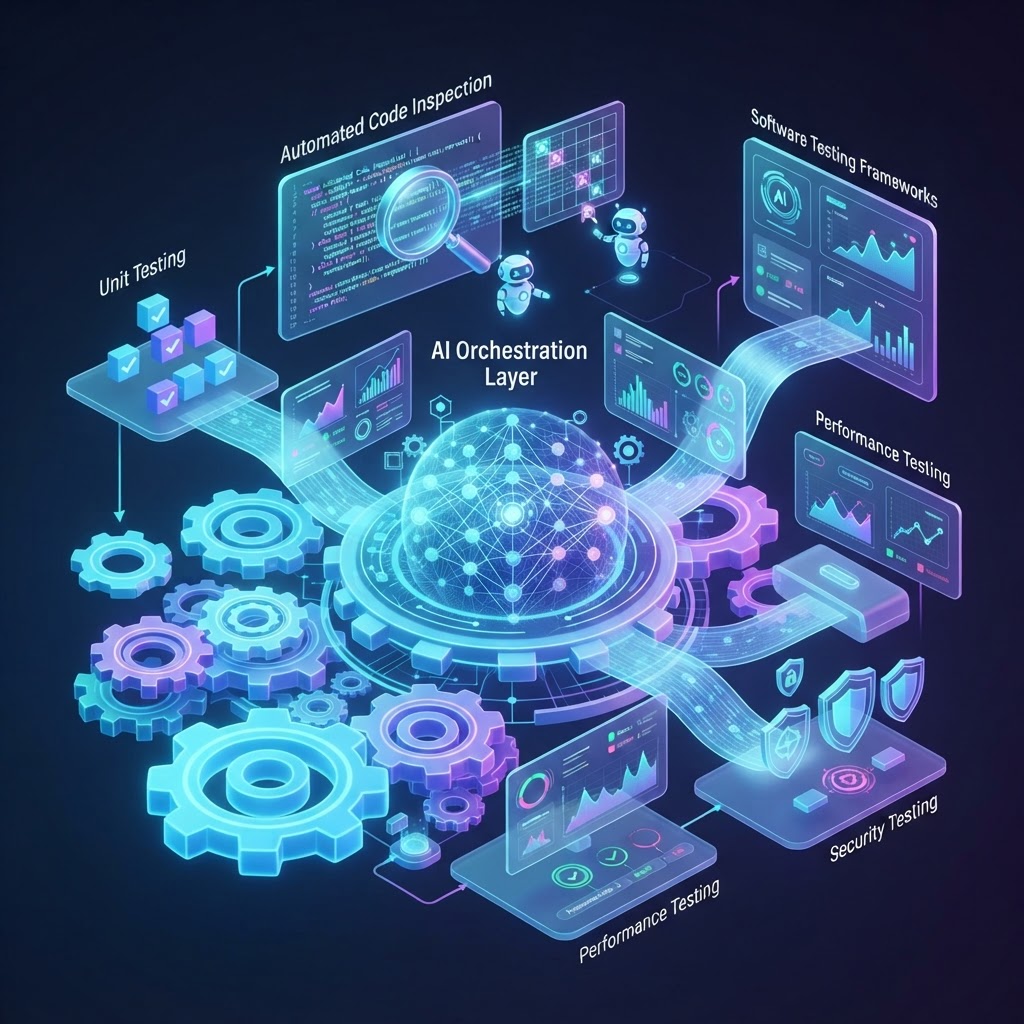
Der Übergang zur AI-driven CI/CD Pipeline erfordert einen grundlegenden Architekturwechsel. Anstatt das LLM (wie GPT-4o oder Claude 3.5 Sonnet) nur als externen Berater zu nutzen, den der Entwickler manuell befragt, wird das Modell über Frameworks wie LangChain oder LlamaIndex direkt als Orchestrierungsschicht in den CI-Server integriert. Wir sprechen hier von einem 'Agentic Workflow'. Wenn ein Build fehlschlägt, feuert der CI-Server ein Event an die Orchestrierungs-Engine. Das LLM nutzt dann RAG (Retrieval-Augmented Generation), um nicht nur den aktuellen Stacktrace, sondern auch die letzten Commits, die Architektur-Dokumentation und historische Fehlermuster aus einer Vektordatenbank abzurufen. Auf dieser Basis analysiert die KI nicht nur den Fehler, sondern generiert einen präzisen Hotfix, validiert diesen in einem Sandbox-Container und schlägt den Merge-Request automatisch vor.
Context is King: Warum einfache Prompts scheitern
Ein häufiger Anfängerfehler bei der Implementierung von KI in der CI/CD ist das einfache Weiterleiten von rohen Log-Dateien an die API. Die meisten Enterprise-Build-Logs umfassen Zehntausende von Zeilen. Selbst bei Modellen mit Kontextfenstern von 128k Token führt dieser Noise zu Halluzinationen oder übersehenen Details ('Lost in the Middle'-Phänomen). In unseren Umsetzungen bei der AI-Software GmbH filtern wir den Output im Vorfeld streng. Wir nutzen deterministische AST-Parser (Abstract Syntax Trees) in Kombination mit semantischer Suche, um exakt die Code-Pfade und Log-Abschnitte zu isolieren, die für den Fehler relevant sind. Erst dieses verdichtete, strukturierte JSON-Paket wird an das LLM übergeben. Diese Vorverarbeitung reduziert Token-Kosten massiv, senkt die Latenz der API-Antwort auf unter zwei Sekunden und erhöht die Präzision des KI-Agenten drastisch.
Achtung: Der Non-Determinismus-Falle entgehen
LLMs operieren probabilistisch, nicht deterministisch. Eine KI darf niemals den finalen Merge in den Main-Branch ausführen, ohne dass eine deterministische Test-Suite den von der KI generierten Code verifiziert hat. Die KI schreibt den Code, aber klassische Tests behalten das Veto-Recht.
3. Intelligente Test-Suite-Automatisierung und Self-Healing
Der vielleicht größte sofortige Mehrwert einer AI-driven Pipeline liegt im Bereich Software-Testing. Die Generierung von Unit- und Integrationstests war bisher eine lästige Pflicht. KI-Modelle haben in den letzten 12 Monaten bewiesen, dass sie – wenn sie mit dem richtigen Architekturkontext (System-Prompts + RAG) versorgt werden – Tests generieren können, die nicht nur Code-Coverage simulieren, sondern reale Edge-Cases abbilden. Das eigentliche Meisterstück ist jedoch das 'Self-Healing'. Ändert sich das Datenmodell oder eine API-Schnittstelle in Microservice A, brechen unweigerlich die Tests in Microservice B. Anstatt dass Entwickler diese Brüche manuell nachziehen, erkennt der KI-Orchestrator den ursächlichen Commit, versteht die beabsichtigte strukturelle Änderung und passt die Test-Assertions in Microservice B vollautomatisch an. Das Resultat ist eine sich selbst korrigierende Test-Infrastruktur.
- Dynamische Test-Selektion: LLMs analysieren den Git-Diff und führen nur die Tests aus, die semantisch von der Änderung betroffen sein könnten (Predictive Test Selection).
- Flaky-Test-Erkennung: KI-Agenten analysieren die Historie von fehlschlagenden Tests. Liegt es an Timing-Problemen oder externen APIs, kapseln sie den Test robuster oder schlagen Mocks vor.
- Automatische Dokumentations-Updates: Jeder Self-Healing-Vorgang aktualisiert parallel die technische Dokumentation im Repository, um Entwickler über Systemänderungen zu informieren.
4. Automated Canary Deployments: Wenn die KI den Rollout steuert
Continuous Deployment (CD) scheitert in komplexen Umgebungen oft an der mangelnden Vertrauensbasis für autonome Releases. Traditionelles Canary-Release-Management leitet 5% des Traffics auf die neue Version und überwacht vordefinierte Schwellenwerte (HTTP 500er, CPU-Last). Doch was passiert bei subtilen semantischen Fehlern, wie etwa leicht abweichenden JSON-Strukturen in einer Response, die keinen harten Fehler werfen, aber ein Drittsystem kompromittieren? Hier glänzt LLM-gestützte Log-Analyse. Moderne KI-Pipelines injizieren die Telemetriedaten, Logs und APM-Traces in ein speziell trainiertes Modell. Dieses versteht das 'normale' Verhalten der Applikation im Kontext des aktuellen Datenverkehrs. Es identifiziert semantische Anomalien, die statische Schwellenwerte übersehen würden, und trifft extrem schnell datengetriebene Rollback-Entscheidungen, bevor der Fehler den Großteil der Nutzer betrifft.
- 1
Pre-Flight Check: Der KI-Agent scannt die Docker-Images auf Schwachstellen und validiert die Helm-Charts auf Konfigurationsfehler vor dem Deployment.
- 2
Canary Rollout (5% Traffic): Die neue Version wird in Kubernetes provisioniert. Datadog/Prometheus-Metriken werden live als Vektoren gestreamt.
- 3
Semantische Log-Analyse: Das LLM vergleicht die Log-Muster der Canary-Pods mit der Baseline. Es sucht nach subtilen Abweichungen in den Stacktraces.
- 4
Entscheidungsfindung: Bei Anomalien löst die KI sofort den ArgoCD-Rollback aus und generiert parallel ein Post-Mortem-Ticket mit der Fehlerursache.
- 5
Full Release: Zeigt die Analyse keine Regressionen, gibt die KI das Go für den 100% Rollout und benachrichtigt das Team via Slack.
5. Paradigmenwechsel: Pro und Contra der KI-Pipelines
Vorteile
- Massive Reduktion der MTTR (Mean Time to Recovery) durch KI-generierte Hotfixes.
- Signifikant weniger Entwickleraufwand für die Wartung von Test-Suiten (Self-Healing).
- Tiefgehende semantische Überwachung bei Canary-Deployments verhindert stille Fehler.
Nachteile
- Hohe initiale Komplexität und Abhängigkeit von LLM-Infrastrukturen und API-Kosten.
- Halluzinationsrisiko erfordert strikte, deterministische Fallbacks und Sicherheitsnetze.
- Datenschutz und Compliance: Code und Logs dürfen oft nicht an externe SaaS-LLMs gesendet werden (erfordert lokale Modelle wie Llama-3).
6. Praxis-Insights: Harte Lektionen aus der Enterprise-Realität
In unseren zahlreichen Beratungsmandaten und Implementierungen bei der AI-Software GmbH sehen wir immer wieder die gleiche Falle: Unternehmen behandeln KI in der Pipeline wie eine magische Blackbox. Sie leiten unmaskierte Produktionsdaten und Hardcoded-Secrets versehentlich in API-Calls an externe Provider. Das ist ein absolutes No-Go. Eine professionelle AI-driven Pipeline erfordert strikte Data Loss Prevention (DLP) auf Orchestrierungsebene. Sensible Daten, API-Keys und Kundendaten aus Logs müssen durch Hashes ersetzt werden, bevor sie das Unternehmensnetzwerk verlassen. Zudem muss die Pipeline so konzipiert sein, dass sie auch bei einem Totalausfall der KI-APIs noch funktioniert. Fällt das LLM aus, muss die Pipeline elegant auf ein klassisches, rein deterministisches Fallback-Szenario zurückstufen können, ohne den Release-Prozess zu blockieren.
Eine KI-Pipeline ohne deterministische Ankerpunkte ist wie ein Sportwagen ohne Bremsen. Die Intelligenz des LLMs bringt uns Geschwindigkeit, aber die traditionellen Unit-Tests und starren Rollback-Skripte liefern uns die nötige Sicherheit in der Kurve.
Ein Blick in die Zukunft: In den nächsten 12 bis 36 Monaten werden wir eine Abkehr von generischen LLMs hin zu hochspezialisierten, lokal trainierten 'DevOps-Small-Language-Models' (SLMs) erleben. Gartner prognostiziert, dass bis 2027 über 70% der agilen Teams autonome CI/CD-Orchestrierung nutzen werden. Diese SLMs werden nativ im Kubernetes-Cluster des Kunden laufen und den extremen Datenschutz-Anforderungen der europäischen Märkte gerecht werden. Durch Parameter-Efficient Fine-Tuning (PEFT) auf der spezifischen Code-Basis und den System-Logs des jeweiligen Unternehmens werden diese Agenten eine Präzision erreichen, die aktuelle Frontier-Modelle übertrifft – bei einem Bruchteil der Latenz und Infrastrukturkosten.
7. Fazit: Wer jetzt nicht automatisiert, verliert den Anschluss
Die Evolution von statischen CI/CD-Pipelines hin zu kognitiven, AI-gesteuerten Orchestrierungssystemen ist nicht bloß ein Hype, sondern eine zwingende technologische Antwort auf die explodierende Komplexität moderner Cloud-Architekturen. Entwicklungsabteilungen, die den Schritt in Richtung intelligenter Test-Suiten und autonomer Deployments verschlafen, werden zunehmend von den Wartungskosten ihrer eigenen Infrastruktur erdrückt. Der Einsatz von LLMs in der Pipeline bedeutet den Übergang von blindem Befehlsausführen zu kontextuellem Handeln. Richtig implementiert, mit starken deterministischen Sicherheitsnetzen und sauberem Data-Masking, werden diese Systeme zum ultimativen Produktivitäts-Booster für jedes High-Performing-Engineering-Team.
Bereit für die Pipeline der Zukunft?
Die AI-Software GmbH unterstützt Sie dabei, Ihre Entwicklungs- und Releaseprozesse zukunftssicher zu machen. Kontaktieren Sie unsere Architekten für einen unverbindlichen Proof-of-Concept und transformieren Sie Ihre starre CI/CD in eine kognitive Pipeline.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.