Ethisches Design in der KI: Wie Architektur Bias verhindert und Neutralität erzwingt
KI-Modelle sind nicht inhärent neutral, sondern spiegeln die Vorurteile ihrer Trainingsdaten wider. Ein Deep Dive in die technische Architektur von Responsible AI und die systematische Vermeidung von Bias.
Inhalt
Das Wichtigste in Kürze
- KI-Bias ist kein reines Datenproblem, sondern ein architektonischer Defekt, der in der MLOps-Pipeline gelöst werden muss.
- Blindes Entfernen geschützter Merkmale (z.B. Geschlecht) führt zum 'Proxy-Problem' und verschlechtert paradoxerweise oft die Modell-Fairness.
- Der EU AI Act verlangt ab 2026 lückenloses Bias-Monitoring (Art. 10) – Non-Compliance droht mit Strafen bis zu 35 Millionen Euro.
- Ethisches Design erfordert harte mathematische Entscheidungen zwischen konkurrierenden Fairness-Metriken wie 'Demographic Parity' und 'Equalized Odds'.
Die gefährlichste Illusion in der Softwareentwicklung ist der Glaube an die kalte Objektivität von Algorithmen. Wer als CTO oder Data Scientist heute noch annimmt, ein neuronales Netz sei per se neutral, baut eine tickende Compliance-Zeitbombe. Modelle optimieren lediglich Verlustfunktionen basierend auf historischen Daten – und diese Historie ist tief durchsetzt von menschlichen Vorurteilen, systemischer Diskriminierung und statistischen Anomalien. Bei der AI-Software GmbH haben wir in den letzten Jahren Dutzende von hochskalierbaren KI-Systemen in Produktion gebracht, und die Lektion war immer dieselbe: Ethisches Design ist keine philosophische Kür, die man am Ende auf das System klebt. Es ist harte, tiefgreifende Systemarchitektur, die vom ersten Datenbank-Query an mitgedacht werden muss.
Die Anatomie von Bias in der KI-Entwicklung
Um Bias effektiv zu bekämpfen, müssen wir zunächst seinen Ursprung dekonstruieren. In der Praxis unterscheiden wir hauptsächlich drei Vektoren: Historischer Bias, Repräsentations-Bias und Mess-Bias. Historischer Bias entsteht, wenn die Welt, die wir abbilden, bereits diskriminierend ist. Ein klassisches Beispiel war das rekrutierende KI-System eines Tech-Giganten im Jahr 2018, das weibliche Bewerber systematisch abwertete, weil die Trainingsdaten aus Lebensläufen der letzten zehn Jahre bestanden – einer Zeit, in der fast nur Männer eingestellt wurden. Das Modell tat genau das, wofür es gebaut wurde: Es fand Muster in den historischen Erfolgsdaten und replizierte sie gnadenlos.
Repräsentations-Bias (auch Sampling-Bias) tritt auf, wenn bestimmte Demografien im Trainingsdatensatz statistisch unterrepräsentiert sind. Die NIST (National Institute of Standards and Technology) bewies dies 2019 eindrucksvoll in ihrer umfassenden Studie zur Gesichtserkennung (FRVT). Die Fehlerquoten bei der Identifikation von Women of Color waren teilweise 10- bis 100-mal höher als bei weißen Männern, schlichtweg weil die Trainingsdaten für diese Gruppe nicht ausreichend Varianz und Quantität aufwiesen. Wenn wir bei der AI-Software GmbH neue Modelle für Computer Vision trainieren, ist die Stratifizierung der Datensätze nach exakten demografischen Schlüsseln daher ein nicht-verhandelbarer Bestandteil der ETL-Pipeline.
10-100x
Höhere Fehlerquote für PoC-Frauen in frühen Gesichtserkennungsmodellen (NIST, 2019)
83%
Aller KI-Bildgeneratoren zeigten 2023 starken systemischen Gender-Bias
€35 Mio
Maximale Strafe unter dem EU AI Act bei Verletzung der Daten-Governance
Technische Mechanismen: Fairness mathematisch definieren
Das Hauptproblem der angewandten KI-Ethik ist, dass 'Fairness' kein eindeutig definierbarer, universeller Zustand ist. In der maschinellen Lernarchitektur müssen wir Fairness in harte mathematische Gleichungen übersetzen – und diese widersprechen sich oft gegenseitig. Nehmen wir das Beispiel der Kreditvergabe: Streben wir 'Demographic Parity' an, bedeutet das, dass jede demografische Gruppe (z.B. Männer und Frauen) den gleichen Anteil an positiven Vorhersagen (Kreditzusagen) erhalten muss, unabhängig von der zugrunde liegenden Verteilung der Bonität. Dies ist politisch oft gewollt, ruiniert aber die Vorhersagekraft des Modells, wenn echte statistische Unterschiede in den Basisraten existieren.
Die Alternative ist 'Equalized Odds' oder 'Equal Opportunity', bei der wir sicherstellen, dass die False-Positive-Raten und False-Negative-Raten über alle Subgruppen hinweg identisch sind. Das bedeutet, dass ein kreditwürdiger Antragsteller Gruppe A genau die gleiche Chance auf einen Kredit hat wie ein kreditwürdiger Antragsteller aus Gruppe B. Wie Jon Kleinberg eindrucksvoll mathematisch bewiesen hat, ist es unmöglich, Kalibrierung, Equalized Odds und Demographic Parity gleichzeitig zu optimieren, wenn die Basisraten der Gruppen unterschiedlich sind. Diese Unmöglichkeits-Theoreme zwingen uns Architekten, den Business Case extrem genau zu verstehen, bevor wir uns für eine Loss-Function-Penalisierung entscheiden.
Die Proxy-Variablen-Falle
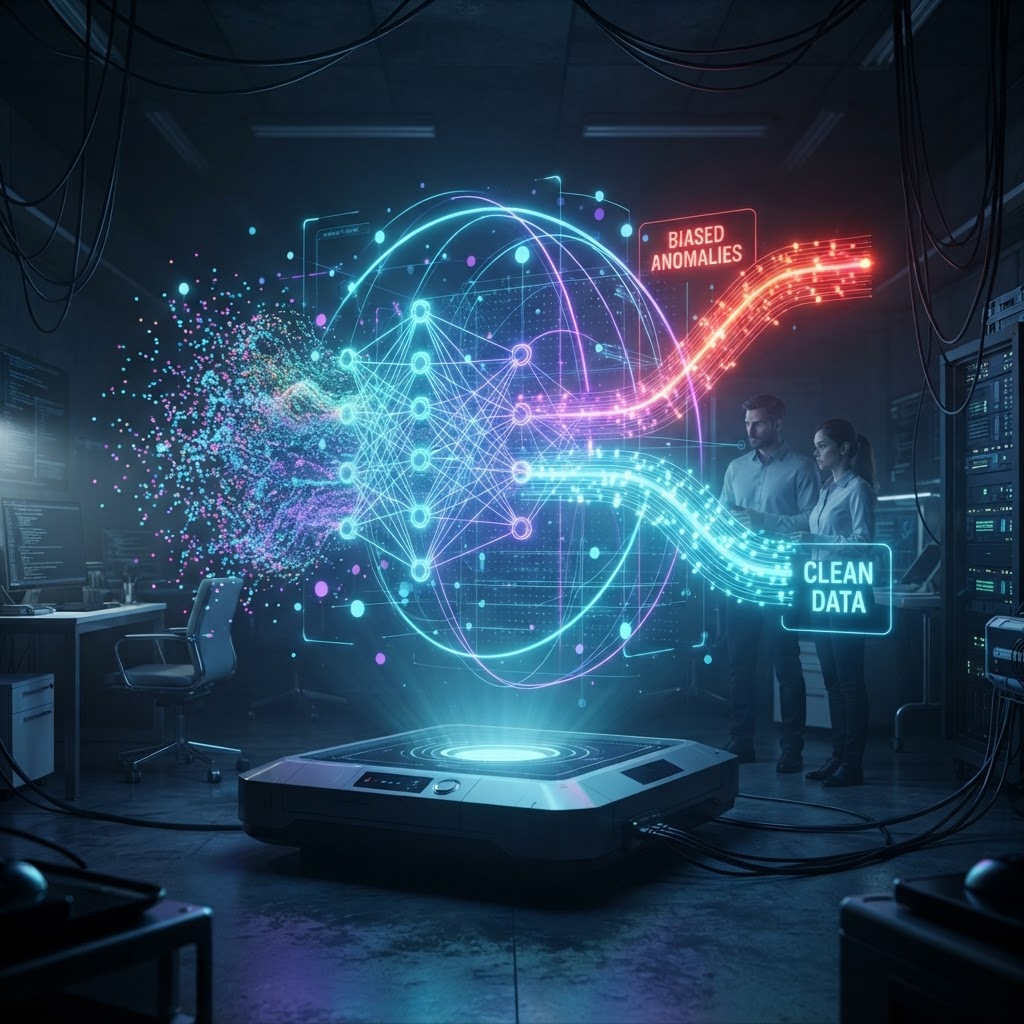
Der Versuch, geschützte Merkmale (wie Geschlecht, Herkunft, Alter) einfach aus dem Trainingsdatensatz zu entfernen, ist ein klassischer Anfängerfehler. Diese Methode wird 'Fairness through Blindness' genannt und funktioniert in der Praxis nie. Modelle rekonstruieren diese geschützten Attribute stattdessen aus hochkorrelierten Proxy-Variablen – etwa über Postleitzahlen, Einkaufsverhalten oder Hobbys. Das Modell bleibt rassistisch oder sexistisch, aber es wird unmöglich, dies nachzuweisen, da die Referenzdaten fehlen.
Framework für Responsible AI: Integration in MLOps
Eine neutrale KI entsteht nicht durch gute Vorsätze, sondern durch rigoroses Testing und kontinuierliches Monitoring im Rahmen des MLOps-Lifecycles. Tools wie Fairlearn von Microsoft, IBMs AI Fairness 360 oder das Aequitas-Framework von der University of Chicago gehören heute zum Standard-Arsenal eines jeden fähigen Data Scientists. Sie ermöglichen es uns, während der Entwicklungsphase unzählige Intersektionalitäten zu testen. Es reicht nicht, nur 'Männer vs. Frauen' zu testen – was ist mit 'älteren Frauen aus einer bestimmten Einkommensschicht'? Erst die granulare Betrachtung deckt den tatsächlichen systemischen Bias auf, der sich an den Rändern unserer Verteilungen versteckt.
- 1
Pre-Processing: Exploratory Data Analysis (EDA) mit starkem Fokus auf Subgruppen-Repräsentanz und der bewussten Anwendung von Resampling-Methoden (z.B. SMOTE für Minderheiten).
- 2
In-Processing: Definition und mathematische Fixierung der Fairness-Metrik. Einsatz von Adversarial Debiasing während des Trainings (z.B. via PyTorch FairGrad), um dem Netz eine Strafe für korrelierende Entscheidungen zu geben.
- 3
Post-Processing: Kalibrierung der Entscheidungsschwellenwerte (Thresholds). Verschiedene Demografien erhalten unterschiedliche Thresholds, um Equalized Odds in der Produktion sicherzustellen.
- 4
Monitoring: Implementierung kontinuierlicher Model-Drift-Detection im Produktivbetrieb. Wenn sich die Verteilung der Echtdaten ändert (Concept Drift), verändern sich auch die Fairness-Metriken.
Ethisches KI-Design ist keine oberflächliche Politur, die man vor dem Deployment aufträgt. Wer Fairness nicht in der Architektur seiner Datenbanken, im Design seiner Features und im Kern seiner Loss-Function verankert, betreibt lediglich performative Compliance.
Generative KI: Die neue Frontier des kulturellen Bias
Mit dem massiven Siegeszug von Large Language Models (LLMs) wie GPT-4, Claude 3 oder Llama 3 hat sich die Debatte um Bias grundlegend gewandelt. Wir kämpfen nicht mehr nur gegen binäre Fehlerquoten in Klassifikationssystemen, sondern gegen subtilen kulturellen und semantischen Bias. Foundation Models werden auf dem unstrukturierten Dump des gesamten Internets trainiert – sie haben Rassismus, Sexismus und westliche Zentriertheit in den Vektorräumen ihrer Milliarden Parameter inhärent enkodiert. Wenn ein solches Modell für RAG-Pipelines (Retrieval-Augmented Generation) in Unternehmen eingesetzt wird, potenziert sich das Risiko, da interne Firmendokumente oft unreflektiert als Ground Truth verarbeitet werden.
Der aktuelle De-facto-Standard zur Behebung dieses Verhaltens ist RLHF (Reinforcement Learning from Human Feedback) sowie dessen Derivate wie DPO (Direct Preference Optimization). Hier bewerten menschliche Annotatoren die Antworten der KI auf toxische oder diskriminierende Inhalte, womit ein Belohnungsmodell trainiert wird, das die Gewichte des Hauptmodells anpasst. Doch auch dieser Ansatz ist tückisch: Wer sind diese Annotatoren? Welche kulturellen Werte vertreten sie? Wir beobachten zunehmend das Phänomen der 'Sycophancy' – die KI wird durch das Alignment so stark darauf trainiert, es dem Nutzer recht zu machen, dass sie ihre Objektivität verliert oder historische Fakten aus übertriebener Vorsicht überschreibt.
Vorteile
- Reduziert toxischen und offensichtlich diskriminierenden Output massiv.
- Ermöglicht schnelles Alignment an Corporate Guidelines und Brand Voice.
- Verbessert Zero-Shot Fairness bei hochkomplexen, mehrdeutigen User-Prompts.
Nachteile
- Gefahr des 'Mode Collapse', bei dem das Modell nur noch harmlose, platte Antworten gibt.
- Erhöhtes Risiko von 'Sycophancy' (Zustimmungssucht gegenüber dem Nutzer).
- Verschleiert tieferliegenden systemischen Bias lediglich durch polierte Sprachstrukturen.
Der 36-Monats-Horizont: Regulierung trifft auf Technologie
Wenn wir in die Zukunft blicken, wird die Überschneidung von Technologie und Gesetzgebung den Markt bereinigen. Der EU AI Act ist bereits in Kraft und wird in den nächsten 12 bis 36 Monaten tiefgreifende operative Konsequenzen nach sich ziehen. Artikel 10 des AI Acts fordert für Hochrisiko-KI-Systeme explizit eine strenge Datengovernance-Strategie. Das bedeutet konkret: Die Repräsentativität und Fairness der Daten muss nicht nur getestet, sondern lückenlos und revisionssicher dokumentiert werden. Für CTOs und Vorstände verschiebt sich Bias von einem Reputationsrisiko zu einem harten Haftungsrisiko, das bei Nichtbeachtung Strafen von bis zu 7% des weltweiten Jahresumsatzes oder 35 Millionen Euro nach sich ziehen kann.
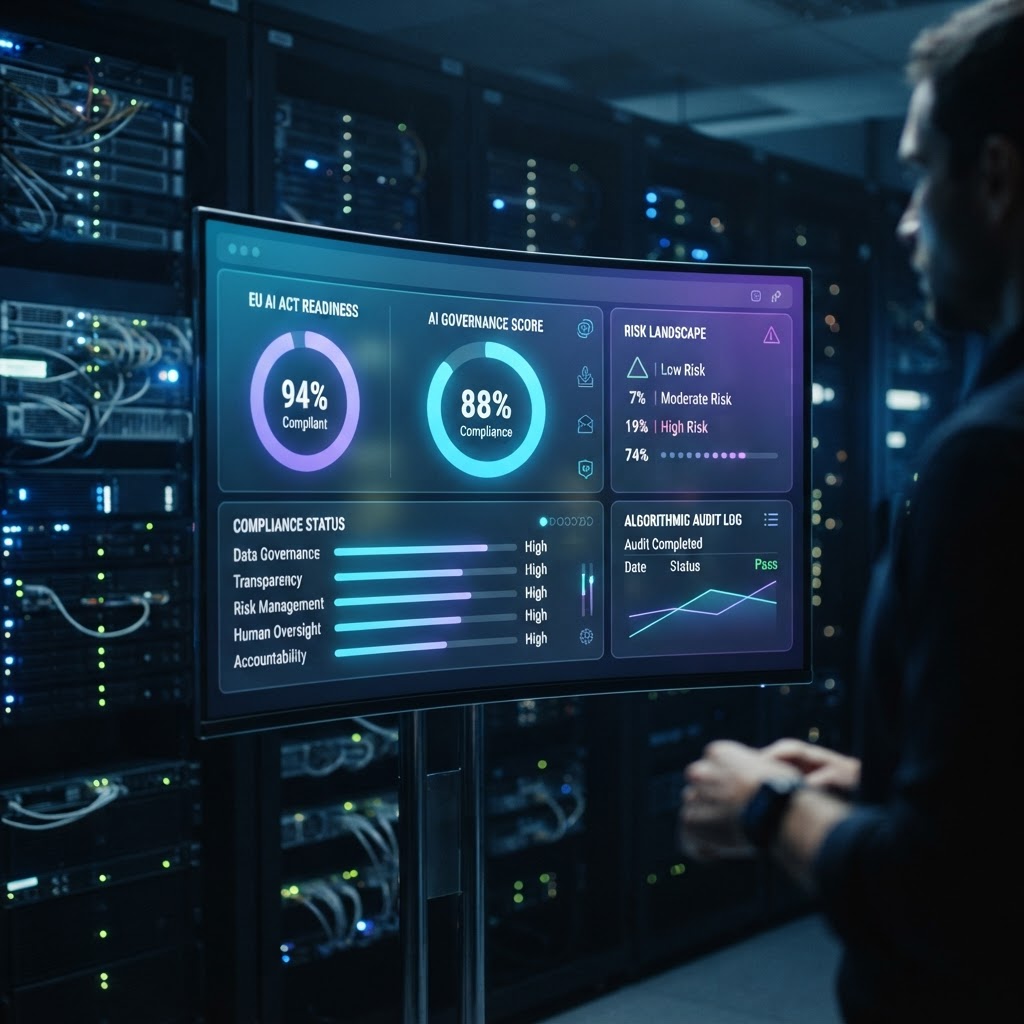
Genau aus diesem Grund ist die AI-Software GmbH nicht nur ein reines Code-Haus. Wir bauen KI-Architekturen, die von Tag eins an auf 'Compliance by Design' ausgelegt sind. Wir implementieren Automated Fairness Dashboards, richten Model-Card-Generierung ein und integrieren Explainable AI (XAI) Module wie SHAP und LIME direkt in unsere Inferencing-APIs. Nur wenn wir die Black Box der Algorithmen aufbrechen und die Faktoren für Bias sichtbar machen, können wir verlässliche Systeme bauen, die auch in drei Jahren noch regulatorischen Prüfungen standhalten. Ethisches Design ist die Basis für das Vertrauen in Enterprise-AI – und Vertrauen ist die eigentliche Währung der digitalen Transformation.
FAQ: Ethisches Design & Bias in KI-Systemen
Bereit für ethisch einwandfreie, performante KI-Systeme?
Überlassen Sie Fairness und Compliance nicht dem Zufall. Die AI-Software GmbH entwickelt maßgeschneiderte, ethisch fundierte KI-Lösungen, die tiefgreifende Performance mit regulatorischer Sicherheit verbinden. Lassen Sie uns die Architektur Ihrer nächsten Innovation besprechen – kontaktieren Sie unsere KI-Experten noch heute.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.