Hyper-Personalisierung im E-Commerce: Wie KI-Modelle Kundenwünsche vorhersagen, bevor sie entstehen
Vergessen Sie starre Kundensegmente. Erfahren Sie, wie moderne E-Commerce-Plattformen durch GNNs, Vector Search und Real-Time-Streaming zu prädiktiven Verkaufsmaschinen mutieren.
Inhalt
Das Wichtigste in Kürze
- Regelbasierte Segmentierung ist tot: Modernes E-Commerce erfordert die Berechnung hochdimensionaler Vector-Embeddings in Echtzeit.
- Technologischer Shift: GNNs (Graph Neural Networks) und Transformer-Modelle ersetzen klassisches Collaborative Filtering.
- Infrastruktur als Bottleneck: Latenzen über 50ms in der Recommendation-Engine zerstören Conversion-Raten. Feature Stores sind Pflicht.
- Generative UI ist die Zukunft: Die nächste Stufe der Personalisierung generiert das komplette Shop-Frontend dynamisch pro Nutzer.
Wer im Jahr 2024 noch auf 'Kunden, die X kauften, kauften auch Y' vertraut, verliert den Anschluss. Die Speerspitze des digitalen Handels hat die Ära der statischen Regeln längst hinter sich gelassen. Heute orchestrieren führende Plattformen ein Ensemble aus Deep-Learning-Modellen, die Millionen von Mikrosignalen in Millisekunden verarbeiten, um den exakten 'Next Best Action' zu prädizieren – lange bevor der Nutzer selbst weiß, was er will.
Das Ende der Segmentierung: Der Paradigmenwechsel zu 'Segments of One'
Klassische IF-THEN-Regeln in Legacy-Systemen skalieren linear und scheitern katastrophal daran, nicht-lineares Nutzerverhalten zu erfassen. Moderne Hyper-Personalisierung bedeutet, dass 'Segments of One' nicht länger ein Marketing-Buzzword, sondern eine berechenbare, mathematische Realität in hochdimensionalen Vektorräumen ist. Die AI-Software GmbH sieht in System-Audits regelmäßig, wie Unternehmen Millionen an Umsatzpotenzial vernichten, weil sie ihre Kunden in vordefinierte, starre Kohorten zwängen. Anstatt Personas zu definieren, müssen individuelle Embeddings berechnet werden, die Clickstreams, Dwell-Times, Scroll-Tiefen und sogar Cursor-Bewegungen in Echtzeit prozessieren. Dieser radikale Wechsel von Heuristiken zu probabilistischen Modellen ist der grundlegende Hebel für exponentielles Wachstum im heutigen E-Commerce.
+24%
Average Order Value (AOV) Uplift durch KI
<50ms
Kritische Latenz für Next-Best-Action
-60%
Reduktion der 'Zero-Result' Suchanfragen
Unter der Haube: Graph Neural Networks und Transformer-Architekturen
Auf architektonischer Ebene bewegen wir uns rapide weg von veralteten Matrix-Faktorisierungs-Methoden (wie ALS) hin zu Two-Tower Neural Networks und Graph Neural Networks (GNNs). Modelle wie LightGCN mappen den bipartiten Graphen von Nutzern und Produkten in einen gemeinsamen latenten Raum und erfassen dabei kollaborative Signale höherer Ordnung mit extremer Präzision. Wenn wir diese räumliche Repräsentation mit Transformer-basierten sequenziellen Modellen (beispielsweise BERT4Rec oder SASRec) kombinieren, kann die Engine den exakten Artikel vorhersagen, den ein Nutzer als nächstes kaufen wird – basierend auf der chronologischen Historie seiner Session. Die Implementierung einer solchen Dual-Encoder-Architektur reduziert Latenzen drastisch und verbessert den Mean Reciprocal Rank (MRR) typischerweise um 30 bis 40 Prozent. Die Zeiten von nächtlichem Batch-Processing für Empfehlungen sind damit definitiv vorbei.
Echtzeit-Infrastruktur: Warum Latenz den Umsatz tötet
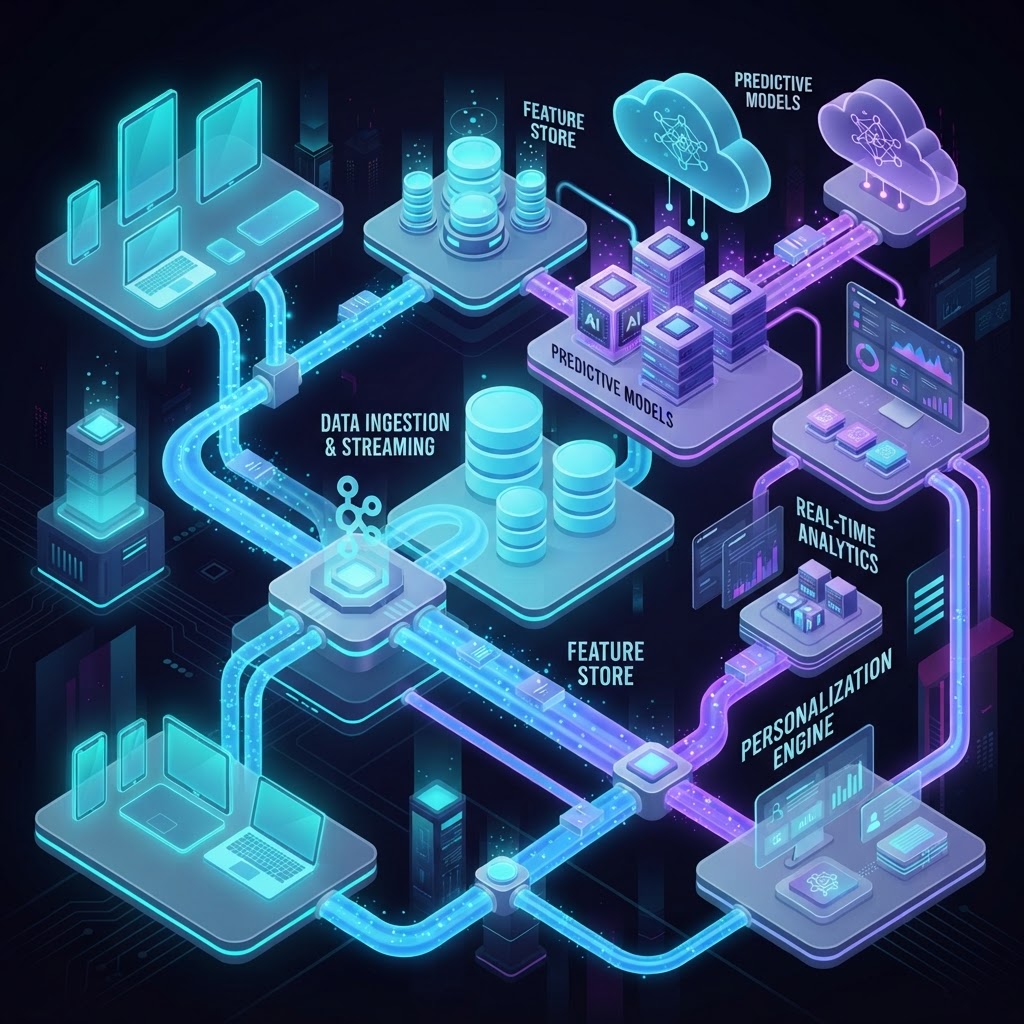
Um diese hochkomplexen Modelle zu füttern, ist eine robuste, ereignisgesteuerte Streaming-Architektur nicht verhandelbar. Technologien wie Apache Kafka oder Redpanda dienen als zentrales Nervensystem des Shopsystems und erfassen Roh-Events, die unmittelbar von Apache Flink verarbeitet werden, um Echtzeit-Features zu berechnen. Solche Features – etwa die 'Kategorie-Affinität der letzten 5 Minuten' – werden in extrem latenzarmen Feature Stores wie Redis, Feast oder Hopsworks zwischengespeichert und für die Modell-Inferenz bereitgestellt. Ohne diese spezialisierte MLOps-Infrastruktur verhungern selbst die fortschrittlichsten Algorithmen an veralteten Batch-Daten. Genau dieses Infrastruktur-Defizit verschärft in der Praxis das gefürchtete 'Cold Start'-Problem massiv, wenn ein unbekannter Nutzer die Seite betritt und innerhalb der ersten drei Klicks klassifiziert werden muss.
Warnung vor Data Drift
Modelle in Produktion degradieren rasend schnell. Wenn Sie Ihre Recommendation-Engine nur einmal im Quartal auf statischen CSV-Dumps neu trainieren, fallen Sie dem 'Data Drift' zum Opfer. Saisonalität, Trends und vergriffene Bestände verändern die Datenverteilung täglich. Continuous Training (CT) Pipelines sind Pflicht.
Die Revolution der Produktsuche durch LLMs und RAG
Die Integration von Large Language Models (LLMs) hat die Discovery-Phase der Customer Journey in den letzten 12 Monaten völlig neu definiert. Traditionelle lexikalische Suchmaschinen, die auf BM25 oder TF-IDF (wie klassische Elasticsearch-Setups) basieren, scheitern kläglich, wenn Nutzer ihren Intent beschreiben, anstatt exakte Produktnamen abzutippen. Durch den Einsatz von Vector Databases in Kombination mit Retrieval-Augmented Generation (RAG) verstehen E-Commerce-Plattformen nun komplexe, semantische Suchanfragen wie 'Outfit für eine Sommerhochzeit in Italien, das im Koffer nicht knittert'. Das LLM übersetzt diesen abstrakten Intent in semantische Vektoren, gleicht sie hochperformant mit dem Produktkatalog ab und generiert eine personalisierte Suchergebnisseite. Diese semantische Durchdringung des Katalogs senkt die 'Zero-Result-Raten' drastisch und erhöht die Conversion von Such-Nutzern signifikant.
- Pinecone: Fully-managed SaaS Vector Database, ideal für schnelle RAG-Implementierungen.
- Weaviate: Open-Source mit starken Out-of-the-Box LLM-Integrationen für E-Commerce-Kataloge.
- Milvus: Hochgradig skalierbar für Enterprise-Kataloge mit hunderten Millionen von Vektoren.
- Qdrant: Exzellente Performance und Payload-Filtering, essenziell für die Filterung nach Größen oder Verfügbarkeiten in der Vector Search.
Warum 70% der Hyper-Personalisierungs-Projekte scheitern
Trotz des immensen wirtschaftlichen Potenzials scheitern über 70 Prozent der Initiativen zur Hyper-Personalisierung daran, innerhalb der ersten 12 Monate einen positiven ROI zu liefern. Die tieferliegende Ursache ist dabei extrem selten die Leistungsfähigkeit des KI-Modells selbst, sondern massive organisatorische Reibung und fragmentierte Datensilos quer durch CRM-, ERP- und PIM-Systeme. Oft werden Machine-Learning-Modelle in isolierten Proof-of-Concepts (PoCs) von Data Scientists entwickelt, ohne eine Brücke zur Engineering-Abteilung für das finale Deployment zu schlagen. Ohne strikte CI/CD-Pipelines für Machine Learning verrotten diese Modelle bei der Überführung in die Produktion. Genau hier setzt die AI-Software GmbH an: Wir bauen keine akademischen Modelle für die Schublade, sondern integrierte MLOps-Architekturen, die ab Tag eins skalieren, Latenzen minimieren und messbaren Business-Value treiben.
Vorteile
- Custom Architecture (Build): Volle Kontrolle über die Algorithmen und keine Vendor-Lock-ins.
- Custom Architecture (Build): Eigene Daten als echter Wettbewerbsvorteil (Moat) nutzbar.
- Custom Architecture (Build): Keine Limits bei Integrationstiefe in proprietäre ERP-Systeme.
Nachteile
- SaaS Personalization (Buy): Oft eine Blackbox ohne Einfluss auf Gewichtungen der Parameter.
- SaaS Personalization (Buy): Hohe wiederkehrende Lizenzkosten, die bei Traffic-Spitzen explodieren.
- SaaS Personalization (Buy): Daten fließen an Drittanbieter ab, was Datenschutz-Audits erschwert.
Der Blueprint für CTOs: Architektur für den Erfolg
- 1
Data Foundation & Tracking-Audit: Konsolidierung von Zero-, First- und Third-Party-Daten in einem modernen Data Warehouse (z.B. Snowflake oder BigQuery) mit strikter Schema-Validierung.
- 2
Streaming Pipeline Setup: Implementierung von Kafka und Flink für die Real-Time Event-Verarbeitung und Feature-Berechnung.
- 3
Feature Store Deployment: Zentralisierung aller Features (Batch & Streaming) in einer Tecton- oder Hopsworks-Instanz, um Trainings- und Serving-Skew zu eliminieren.
- 4
Modell-Entwicklung & MLOps: Aufbau einer Continuous-Training-Pipeline. Auswahl passender GNN- oder Transformer-Modelle anhand der spezifischen Katalog-Dichte.
- 5
A/B-Testing & Shadow-Deployment: Soft-Launch der Modelle im Shadow-Mode zur Latenz-Prüfung, gefolgt von rigorosen, statistisch signifikanten A/B-Tests gegen die Legacy-Heuristiken.
Prognose (12-36 Monate): Generative UI und Server-Driven Interfaces
Blicken wir 12 bis 36 Monate in die Zukunft, wird sich der Fokus der Hyper-Personalisierung von bloßen Produktempfehlungen auf die dynamische Generierung der gesamten Benutzeroberfläche verschieben. Das Konzept der 'Generative UI' nutzt Server-Driven UI (SDUI) Frameworks, die von Reinforcement Learning Agents gesteuert werden, um Layouts, Wording und visuelle Hierarchien On-the-Fly zusammenzusetzen. Ein hochgradig analytischer Käufer bekommt dann automatisch detaillierte Spezifikationen und dichte Vergleichstabellen präsentiert. Ein impulsiver Käufer hingegen sieht auf derselben URL großformatige Lifestyle-Bilder, stark verkürzten Copy-Text und aggressive Social-Proof-Elemente. Dieser Wandel wird starre Frontend-Templates endgültig obsolet machen und erfordert eine tiefe Entkopplung von Backend-Logik und Frontend-Rendering.
Agentic Commerce: Wenn KI für Kunden einkauft
Parallel zur Generative UI erleben wir den Anbruch des 'Agentic Commerce'. Die Customer Journey wandelt sich schrittweise von B2C zu A2A (Agent-to-Agent). Nutzerseitige KI-Assistenten werden das Web crawlen, Spezifikationen evaluieren und autonom mit den Pricing-Modellen der Händler verhandeln. In diesem radikal neuen Szenario überlebt nur der E-Commerce-Player, dessen Predictive Analytics bis tief in die Supply Chain integriert sind, um dynamische, gewinnmaximierende Preise (Dynamic Pricing) in Echtzeit über APIs bereitzustellen. Händler, die heute nicht die technologische Grundlage für API-first, Headless-Commerce und maschinenlesbare Kataloge legen, werden in dieser aufkommenden Agenten-Ökonomie schlichtweg unsichtbar sein.
Der wahre Wettbewerbsvorteil (Moat) im modernen E-Commerce sind nicht länger die Modell-Gewichte der KI, sondern die proprietären Daten-Pipelines und die Agilität der zugrundeliegenden MLOps-Infrastruktur.
Fazit: MLOps statt Marketing-Gags
Echte Hyper-Personalisierung ist kein Feature, das man einfach als SaaS-Tool kauft und als Plug-and-Play an einen veralteten Monolithen anflanscht. Es ist ein fundamentaler architektonischer Paradigmenwechsel, der tiefgreifendes technisches Know-how erfordert. Unternehmen müssen aufhören, KI als kurzlebigen Marketing-Gag zu betrachten, und stattdessen substanziell in ihre Data-Engineering-Ressourcen und Machine-Learning-Infrastruktur investieren. Die AI-Software GmbH verfügt über die jahrelange Praxiserfahrung, um CTOs und Entscheider bei dieser hochkomplexen Transformation sicher zu begleiten. Wer jetzt die Weichen stellt, baut sich ein prädiktives System auf, das dem Markt um Jahre voraus ist und in jeder Session messbar mehr Umsatz generiert.
- Sind Ihre Kundendaten in einem zentralen DWH konsolidiert?
- Haben Sie eine Event-Streaming-Lösung (z.B. Kafka) im Einsatz?
- Können Features in unter 50ms für Inferenz abgerufen werden?
- Ist ein Feature Store für Training/Serving-Konsistenz vorhanden?
- Existiert eine CI/CD Pipeline speziell für Machine Learning Modelle?
FAQ: Hyper-Personalisierung in der Praxis
Bereit für den Paradigmenwechsel?
Ihre E-Commerce-Plattform verliert täglich Umsatz an starre Heuristiken. Kontaktieren Sie die KI-Architekten der AI-Software GmbH für ein unverbindliches Deep-Dive Audit Ihrer Dateninfrastruktur. Wir bauen Predictive Engines, die dominieren.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.