Hyper-Personalisierung im Marketing: Wie KI-Modelle in Echtzeit Kundenverhalten prädizieren
Weg von starren Segmenten, hin zur 1:1-Interaktion in Millisekunden. Erfahren Sie, wie moderne KI-Architekturen Customer Journeys prädizieren und Kampagnen ohne Streuverlust orchestrieren.
Inhalt
Das Wichtigste in Kürze
- Echtzeit-Inferenz ist Pflicht: Batch-Processing von Kundendaten führt zu veralteten Modellen und verschenktem ROI.
- Composable Architecture: Monolithische Marketing-Suites werden durch entkoppelte Microservices, Feature Stores und Vektordatenbanken abgelöst.
- Prädiktiv trifft Generativ: Die wahre Macht entfaltet sich, wenn Predictive AI den Kontext erkennt und LLMs den Content on-the-fly generieren.
- Cold Start Problematik: Mit Contextual Bandits und Reinforcement Learning lässt sich Personalisierung auch ohne historische Datenlandschaften umsetzen.
Die Ära, in der ein 'Hallo [Vorname]' in der Betreffzeile als Personalisierung galt, ist endgültig vorbei. Wahre Hyper-Personalisierung bedeutet heute, dass ein System die Intention eines Nutzers in Millisekunden prädiziert – noch bevor dieser selbst genau weiß, wonach er sucht. Als Architekten solcher Systeme bei der AI-Software GmbH sehen wir täglich, dass der Wechsel von regelbasierten Segmenten zu prädiktiven, dynamischen KI-Modellen nicht nur ein Upgrade ist, sondern ein Paradigmenwechsel, der über die Marktdominanz im E-Commerce und B2B-Sektor entscheidet.
Die Evolution: Von A/B-Testing zu prädiktiven Transformer-Modellen
Das klassische Marketing operierte jahrzehntelang auf Basis starrer demografischer Cluster und reaktiver Trigger. Man definierte grobe Personas, baute Wenn-Dann-Workflows und hoffte, durch extensives A/B-Testing die Conversion-Rate im Promillebereich zu steigern. Dieses Vorgehen ignoriert jedoch die feingranulare, nicht-lineare Realität moderner Customer Journeys, in denen Nutzerkontexte innerhalb von Sekunden wechseln. Heute setzen wir bei der AI-Software GmbH auf prädiktive Transformer-Architekturen und Two-Tower Neural Networks, die den gesamten historischen Interaktionsgraph eines Users erfassen. Diese Modelle erkennen versteckte Muster in scheinbar unzusammenhängenden Datenpunkten – etwa dem Scroll-Verhalten, der Tageszeit und vergangenen Retouren –, um die Kaufwahrscheinlichkeit für spezifische Kategorien in Echtzeit zu berechnen. Der Streuverlust sinkt dadurch drastisch, da keine statischen Regeln mehr greifen, sondern dynamisch berechnete Wahrscheinlichkeitsvektoren.
71%
der Konsumenten erwarten personalisierte Interaktionen (McKinsey)
< 50ms
maximale Latenzzeit für effektive Real-Time-Inference im E-Commerce
10-15%
durchschnittlicher Uplift im Umsatz durch prädiktive Personalisierung
Die System-Architektur einer Echtzeit-Personalisierungs-Engine
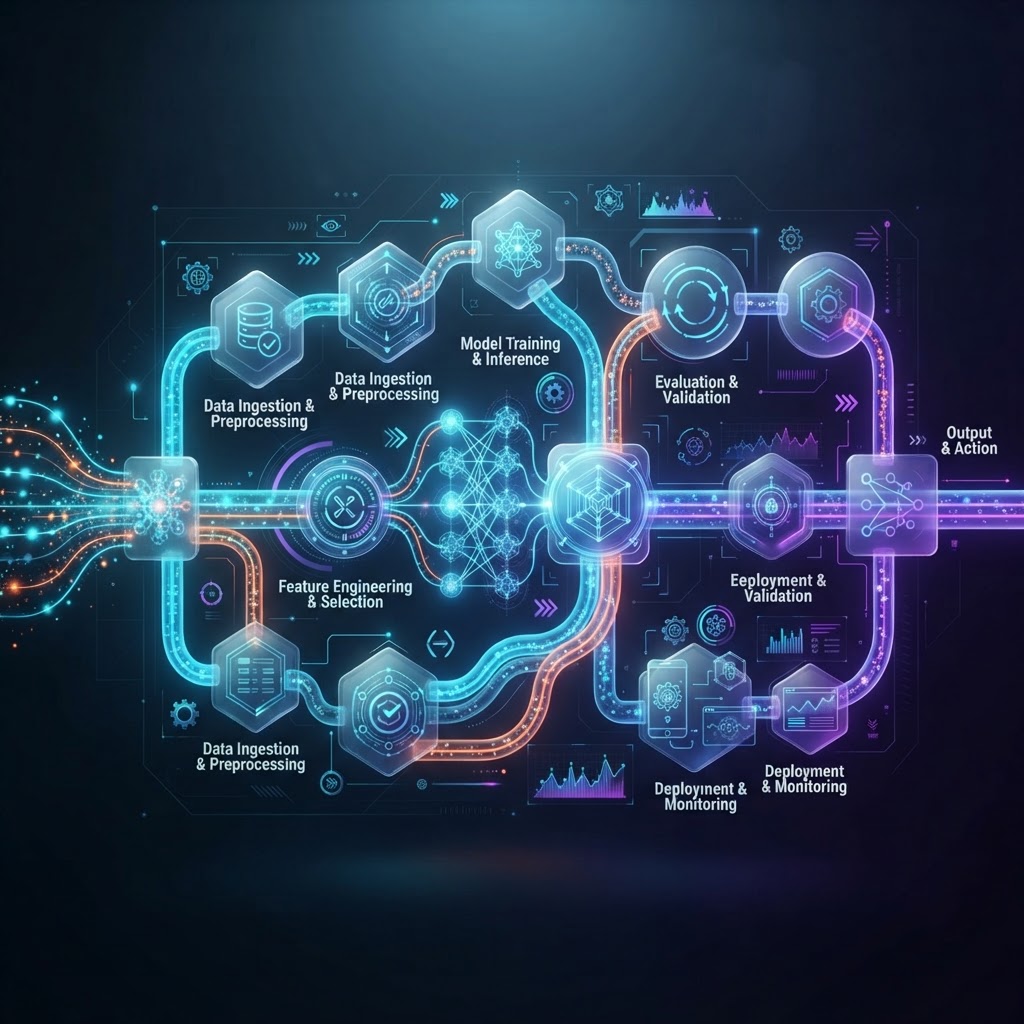
Um eine Latenz im zweistelligen Millisekundenbereich zu garantieren, reicht eine traditionelle relationale Datenbankstruktur längst nicht mehr aus. Moderne Echtzeit-Personalisierungs-Engines basieren auf einer entkoppelten Streaming-Architektur, bei der Technologien wie Apache Kafka oder Flink kontinuierlich und asynchron Klickströme verarbeiten. Diese Event-Daten werden in hochperformanten Feature Stores wie Feast oder Databricks aggregiert, um den Machine-Learning-Modellen ohne jegliche Verzögerung die aktuellsten User-Vektoren zur Inferenz bereitzustellen. Erst durch den Einsatz von In-Memory-Datenbanken und Vektor-Suchmaschinen wie Pinecone oder Milvus können wir die semantische Ähnlichkeit zwischen dem akuten Nutzerkontext und Millionen von Produkt-Embeddings in Echtzeit berechnen. Wer heute noch auf nächtliche Batch-Jobs vertraut, um Segmente zu aktualisieren, hat den Kunden bereits an die Konkurrenz verloren, bevor die personalisierte E-Mail überhaupt gerendert oder ausgespielt wurde.
Architektur-Warnung: Silos töten die Prädiktion
Die größte Gefahr bei der Implementierung von Hyper-Personalisierung sind Datensilos. Wenn das CRM-System, die E-Commerce-Plattform und der Customer Support ihre Daten nicht in einer einheitlichen, echtzeitfähigen Pipeline zusammenführen, wird das KI-Modell auf unvollständigen Vektoren trainiert. 'Garbage in, garbage out' gilt bei Predictive AI in Millisekunden-Geschwindigkeit.
Generative AI meets Predictive AI: Dynamische Content-Assemblierung
Während Predictive AI entscheidet, WELCHES Produkt WANN für WEN relevant ist, löst Generative AI das Problem des WIE. Wir kombinieren bei der AI-Software GmbH prädiktive Modelle wie XGBoost mit modernen Large Language Models (LLMs) wie GPT-4o oder Claude 3.5 Sonnet, um nicht nur Produktempfehlungen, sondern den gesamten Content-Layer on-the-fly zu personalisieren. Mittels Retrieval-Augmented Generation (RAG) stellen wir sicher, dass die generierten Werbetexte streng markenkonform (Brand Safety) bleiben und auf validen Produktdaten basieren. Das bedeutet konkret: Wenn das System erkennt, dass ein Nutzer hochgradig preisaffin ist, generiert das LLM im Bruchteil einer Sekunde einen Teaser-Text, der den Rabattwert fokussiert. Erkennt das Modell hingegen einen qualitätsfokussierten Käufer, wird exakt dasselbe Produkt mit einer Tonalität beworben, die auf Langlebigkeit und Premium-Materialien abstellt. Diese Mikro-Assemblierung von Inhalten reduziert die Notwendigkeit für riesige Content-Bibliotheken radikal.
- Predictive Layer: Berechnet Intent, Churn-Wahrscheinlichkeit und Next-Best-Action.
- Context Layer: Liefert aktuelle Umgebungsdaten (Wetter, Tageszeit, Gerätetyp).
- Generative Layer: Erstellt Copywriting, Subject Lines und Image-Prompts in Echtzeit.
- Orchestration Layer: Führt alle Komponenten zusammen und liefert sie via API an das Frontend aus.
Vorteile
- Drastische Reduktion von Streuverlusten und irrelevanter Werbung
- Erhöhung der Customer Lifetime Value (CLV) durch Relevanz
- Automatisierung der Content-Erstellung spart massive Agenturkosten
- Echtzeit-Anpassung an sich ändernde Markttrends ohne manuelles Eingreifen
Nachteile
- Hohe initiale Setup-Kosten für Data Engineering und MLOps
- Erfordert exzellente Datenqualität und Auflösung von Datensilos
- Komplexere Compliance-Anforderungen bezüglich DSGVO und Privacy
Das 'Cold Start'-Problem lösen: Contextual Bandits im Einsatz
Eine der größten technischen Herausforderungen in der Hyper-Personalisierung ist das sogenannte Cold-Start-Problem: Wie personalisiert man die User Experience für einen komplett anonymen Erstbesucher, über den keinerlei historische Daten vorliegen? Klassische Recommender-Systeme scheitern hier kläglich und fallen auf generische 'Top Seller'-Listen zurück. Die Lösung, die wir bei der AI-Software GmbH tief in unsere Architekturen integrieren, nennt sich 'Contextual Bandits', ein Teilbereich des Reinforcement Learnings. Diese Algorithmen nutzen den spärlichen Kontext der aktuellen Session – wie etwa Referrer-URL, Browser-Sprache, Geo-IP und Tageszeit –, um Hypothesen aufzustellen und kontinuierlich das Exploration-Exploitation-Dilemma zu optimieren. Sie testen dynamisch (Exploration) verschiedene Inhalte und lernen in Millisekunden aus dem Feedback, um erfolgreiche Kombinationen sofort häufiger auszuspielen (Exploitation). So wird aus einem unbekannten Besucher innerhalb von nur drei Klicks ein messbares und hochgradig personalisierbares Profil.
Personalisierung im Zeitalter der KI bedeutet nicht mehr, dem Kunden hinterherzulaufen. Es bedeutet, mit mathematischer Präzision bereits dort auf ihn zu warten, wo er seinen nächsten gedanklichen Schritt hinsetzen wird.
Blueprint: In 5 Phasen zur maßgeschneiderten KI-Architektur
Die Theorie klingt verlockend, doch die Praxis scheitert oft an monolithischen Software-Suiten, die Versprechungen machen, aber keine granulare Anpassung an das spezifische Geschäftsmodell erlauben. Als Experten für Individualsoftware warnen wir unsere Klienten davor, komplexe KI-Logik aus der Box zu kaufen, da die Kern-IP eines Unternehmens in seinen spezifischen Datenstrukturen liegt. Eine erfolgreiche Transformation zur Hyper-Personalisierung erfordert einen strukturierten, iterativen Engineering-Prozess. Wir bauen Systeme nach dem Prinzip der Composable Architecture auf, was Flexibilität und Skalierbarkeit garantiert. Jeder Microservice – vom Event-Ingestion-Layer bis zum Inference-Endpoint – wird so dimensioniert, dass er Lastspitzen am Black Friday ebenso mühelos bewältigt wie komplexe B2B-Kaufzyklen. Der folgende Blueprint zeigt, wie ein solches Projekt methodisch umgesetzt wird.
- 1
Data Foundation & Tracking: Aufbau einer echtzeitfähigen Datenpipeline (z.B. Kafka, Snowplow) zur lückenlosen Erfassung von First-Party-Data.
- 2
Feature Store Implementierung: Definition und Berechnung von hunderten User-Features, die für die Modelle in Millisekunden abrufbar sind.
- 3
Modell-Training & MLOps: Entwicklung prädiktiver Kernmodelle (z.B. LightGBM, Graph Neural Networks) und Aufbau einer CI/CD-Pipeline für kontinuierliches Re-Training.
- 4
Inference & API-Layer: Bereitstellung der Modelle als skalierbare Microservices, die Next-Best-Action-Empfehlungen direkt ans Frontend oder die CDP liefern.
- 5
Feedback Loop & GenAI-Integration: Anbindung von LLMs für dynamische Textgenerierung und Etablierung automatisierter Feedback-Schleifen zur Modelloptimierung.
Ausblick 2025-2027: Federated Learning und Edge AI
Die Zukunft der Personalisierung wird massiv von den regulatorischen Entwicklungen rund um Datenschutz und dem Ende der Third-Party-Cookies getrieben. Die nächste Evolutionsstufe, die wir in unseren Forschungslabors bei der AI-Software GmbH bereits evaluieren, ist der Shift hin zu Edge AI und Federated Learning. Dabei verlassen sensible Rohdaten das Endgerät des Nutzers nicht mehr. Stattdessen wird das Machine-Learning-Modell dezentral auf dem Smartphone oder Laptop des Users trainiert. Nur die anonymisierten Modell-Updates (Gewichtungen) werden an den zentralen Server gesendet und dort aggregiert. Initiativen wie Apples Private Cloud Compute geben hier die Richtung vor. Für das Marketing bedeutet das: Wir können eine extreme Hyper-Personalisierung auf Basis tiefster privater Daten erreichen, ohne jemals gegen die DSGVO zu verstoßen, da wir die PII (Personally Identifiable Information) technisch unangetastet lassen. Dieser Privacy-First-Ansatz wird in den nächsten 36 Monaten zum entscheidenden Wettbewerbsvorteil.
Zusammenfassend lässt sich festhalten: Die technologische Kluft zwischen Unternehmen, die auf echte, echtzeitfähige KI-Architekturen setzen, und jenen, die weiterhin statische Segmente in Legacy-Systemen verwalten, wächst exponentiell. Die Fähigkeit, Kundendaten in prädiktive Handlungen zu übersetzen, ist keine reine Marketing-Spielerei mehr, sondern die fundamentale Infrastruktur für zukünftiges Wachstum. Wer jetzt zögert und auf veraltete Batch-Prozesse setzt, wird von datengetriebenen Mitbewerbern schlichtweg ausmanövriert. Die Implementierung erfordert zwar anfangs mutige architektonische Entscheidungen und ein solides Fundament im Data Engineering, doch die Skaleneffekte und der dramatische Anstieg des Customer Lifetime Values rechtfertigen jeden investierten Entwickler-Tag. Es ist an der Zeit, Marketing von einer spekulativen Kunst in eine präzise Datenwissenschaft zu transformieren.
Insider-Tipp für CTOs
Beginnen Sie nicht mit einem komplexen LLM-Setup, wenn Ihre grundlegenden Event-Streams noch unsauber sind. Investieren Sie zuerst 80% Ihrer Ressourcen in ein wasserdichtes Data Engineering und einen soliden Feature Store. Die KI ist nur der Motor; die Datenstruktur ist das Fundament.
Häufig gestellte Fragen (FAQ)
Bereit für den Paradigmenwechsel?
Ihre aktuelle Marketing-Automation stößt an ihre Grenzen und Sie wollen den Schritt zu echter, prädiktiver KI-Personalisierung machen? Sprechen Sie mit den Architekten der AI-Software GmbH. Wir bauen maßgeschneiderte, hochskalierbare KI-Systeme, die aus Ihren Daten einen unfairen Wettbewerbsvorteil generieren. Lassen Sie uns Ihre Architektur unverbindlich analysieren.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.