Marketing-Attribution in einer KI-dominierten Welt: Das Ende von Last-Click und die Evolution der Erfolgsmessung
Wenn Customer Journeys zunehmend nicht-linear verlaufen und deterministische Datenpunkte wegbrechen, versagen klassische Tracking-Methoden. Erfahren Sie, wie moderne Machine-Learning-Algorithmen und bayessches Marketing Mix Modeling (MMM) den wahren ROI entschlüsseln.
Inhalt
Das Wichtigste in Kürze
- Der Kollaps des deterministischen Trackings: Apple ITP und strenge DSGVO-Auslegungen machen granulare Multi-Touch-Attribution (MTA) zunehmend unzuverlässig.
- Renaissance des MMM: Angetrieben durch bayessche Statistik und Machine Learning feiert das Marketing Mix Modeling (MMM) ein massives, datenschutzkonformes Comeback.
- Hybride Architekturen sind Pflicht: Die Zukunft der Attribution liegt in der Triangulation aus Incrementality Testing, aggregiertem MMM und probabilistischem User-Level-Scoring.
- Data Engineering vor Data Science: Ohne ein robustes, zentrales Cloud-Data-Warehouse (z.B. Snowflake, BigQuery) scheitern 80% aller KI-Attributionsprojekte.
Die Ära des linearen Last-Click-Trackings ist unwiderruflich vorbei. In einer Welt, in der B2B-Kaufentscheidungen über 27 Touchpoints iterieren und Cookie-Consent-Raten im freien Fall sind, steuern CMOs zunehmend im Blindflug. Doch während das deterministische Tracking stirbt, ebnet Künstliche Intelligenz den Weg für eine völlig neue Form der Erfolgsmessung: probabilistisch, plattformübergreifend und radikal wahrheitsgetreu.
Der Kollaps der deterministischen Illusion
Vor zehn Jahren glich die Welt der Performance-Marketer einem mathematischen Idyll: Ein User klickte auf eine Anzeige, ein Cookie wurde in seinem Browser platziert, und der finale Kaufabschluss konnte punktgenau und mit trügerischer Gewissheit auf diesen spezifischen Touchpoint zurückgeführt werden. Diese deterministische Illusion ist inzwischen restlos kollabiert. Angetrieben durch Apples radikale Intelligent Tracking Prevention (ITP), Googles Privacy Sandbox-Initiativen und immer restriktivere DSGVO-Auslegungen durch europäische Aufsichtsbehörden, blicken Marketer heute auf fragmentierte Daten-Silos. Die Customer Journey verläuft de facto nicht mehr linear, sondern zerfasert über diverse mobile Geräte, Inkognito-Modi und Offline-Touchpoints hinweg in ein unleserliches Rauschen.
Die Konsequenz für Unternehmen, die weiterhin auf archaische Heuristiken wie Last-Click oder First-Click vertrauen, ist fatal. Sie allozieren Millionenbudgets auf Basis unvollständiger oder schlichtweg falscher Daten. Wenn wir in unseren Projekten bei der AI-Software GmbH historische Werbeausgaben mit modernen Machine-Learning-Verfahren nachträglich auditieren, stellen wir regelmäßig massive Fehlallokationen fest. Der native Algorithmus eines Werbenetzwerks optimiert lediglich auf das, was er isoliert sehen kann – und reklamiert jeden Conversion-Credit für sich. Er ignoriert dabei völlig die oft ausschlaggebenden, aber schwer messbaren Upper-Funnel-Aktivitäten wie organische PR, Content Marketing oder Out-of-Home-Kampagnen.
27
Durchschnittliche B2B-Touchpoints vor Kaufabschluss (Stand 2023)
< 30%
Tatsächliche Cookie-Opt-In-Raten in restriktiv regulierten EU-Märkten
40%
Typische Budget-Fehlallokation durch reine Last-Click-Modelle
KI-Modelle im Einsatz: Von Markov-Ketten zu Shapley Values
Um die massive Datenlücke zu füllen, die Browser-Restriktionen und serverseitige Tracking-Blocker hinterlassen haben, setzen Data Scientists heute konsequent auf probabilistische Machine-Learning-Ansätze. Etablierte statistische Modelle wie Markov-Ketten analysieren die Übergangswahrscheinlichkeiten zwischen den verschiedenen Touchpoints. Sie berechnen den sogenannten 'Removal Effect' – also die Frage: Wie stark würde die Conversion-Rate einbrechen, wenn wir exakt diesen einen Kanal (z.B. Display Ads) aus der Gesamtgleichung entfernen? Dieser Ansatz bietet bereits einen enormen Sprung weg von der starren, regelbasierten Attribution hin zu einer dynamischen, datengetriebenen Bewertung der realen Customer Journey.
Noch präziser arbeiten Algorithmen, die auf den Shapley Values aus der kooperativen Spieltheorie basieren. Ein Shapley-basiertes Attributionsmodell betrachtet jeden Marketing-Kanal als Spieler in einem kooperativen Spiel, bei dem der finale Kauf der Gewinn ist. Das Modell kalkuliert den marginalen Beitrag jedes Kanals in jeder erdenklichen Kombination. Während diese Modelle mathematisch elegant sind, erfordern sie immense Rechenleistung und vor allem unkorrumpierte Klick-Pfad-Daten, was uns in der heutigen Zeit wieder vor Herausforderungen stellt. Deshalb kombinieren führende KI-Strategen diese Modelle zunehmend mit probabilistischen Graph-Netzwerken, um fehlende Knotenpunkte in der User-Historie synthetisch zu approximieren.
Die Black-Box-Falle der Walled Gardens
Verlassen Sie sich bei der Budgetallokation niemals ausschließlich auf die in sich geschlossenen Auto-Attributions-Features der großen Ad-Netzwerke. Meta, Google und Co. neigen strukturell dazu, ihre eigenen Plattformen (Self-Attributing Networks) zu überbewerten. Echte, neutrale Attribution erfordert immer eine netzwerkunabhängige Infrastruktur, die Sie selbst kontrollieren.
Die Renaissance des Marketing Mix Modeling (MMM)
Eine der faszinierendsten Entwicklungen der letzten 18 bis 24 Monate ist die unerwartete Wiederauferstehung einer Methode, die viele schon auf dem Friedhof der Werbehistorie wähnten: Marketing Mix Modeling (MMM). Ursprünglich in den 1980er Jahren für die FMCG-Branche entwickelt, um den Effekt von TV- und Printwerbung auf Supermarktverkäufe zu messen, war klassisches MMM oft zu träge, zu teuer und zu grob für das hochdynamische Digitalgeschäft. Doch in einer Post-Cookie-Welt, in der das User-Level-Tracking zerbröckelt, erweist sich die grundlegende Methodik von MMM als brillanter, zukunftssicherer Anker. Da MMM ausschließlich mit aggregierten historischen Zeitreihendaten arbeitet (z.B. tägliche Spendings pro Kanal vs. täglicher Umsatz), ist es völlig immun gegen Ad-Blocker, ITP und DSGVO-Restriktionen.
Was das moderne MMM ('MMM 2.0') jedoch revolutioniert, ist der Einsatz von bayesscher Statistik gepaart mit Open-Source Machine-Learning-Bibliotheken wie PyMC oder Googles LightweightMMM. Bei der AI-Software GmbH nutzen wir diese bayesschen Frameworks, um Vorwissen (Priors) – etwa Ergebnisse aus harten Inkrementalitätstests oder Branchen-Benchmarks – algorithmisch mit historischen Zeitreihendaten zu verschmelzen. Das Modell lernt selbstständig die Adstock-Effekte (Verzögerung der Werbewirkung) und Diminishing Returns (Sättigungseffekte) jedes einzelnen Kanals. Gleichzeitig integriert es Makro-Faktoren wie Feiertage, Saisonalität oder Wetterdaten als externe Regressoren. Das Ergebnis ist eine hochpräzise ROI-Schätzung, die C-Level-Entscheidern aufzeigt, bei welchem Spend-Level der Grenznutzen eines Kanals ins Negative kippt.
Vorteile
- Völlig datenschutzkonform, da keine User-Identifikation oder Cookies benötigt werden.
- Integriert externe Variablen (Inflation, Wetter, Saisonalität) für ganzheitliche Analysen.
- Identifiziert den exakten Sättigungspunkt (Diminishing Returns) für optimale Budgetallokation.
Nachteile
- Hohe Anforderungen an das anfängliche Data Engineering zur Bereitstellung der Zeitreihen.
- Keine Echtzeit-Granularität: Eignet sich nicht zur tagesaktuellen Optimierung einzelner Ad-Creatives.
- Erfordert mindestens zwei Jahre saubere historische Daten, um saisonale Effekte verlässlich zu lernen.
Die bittere Wahrheit: Architektur und Data Clean Rooms
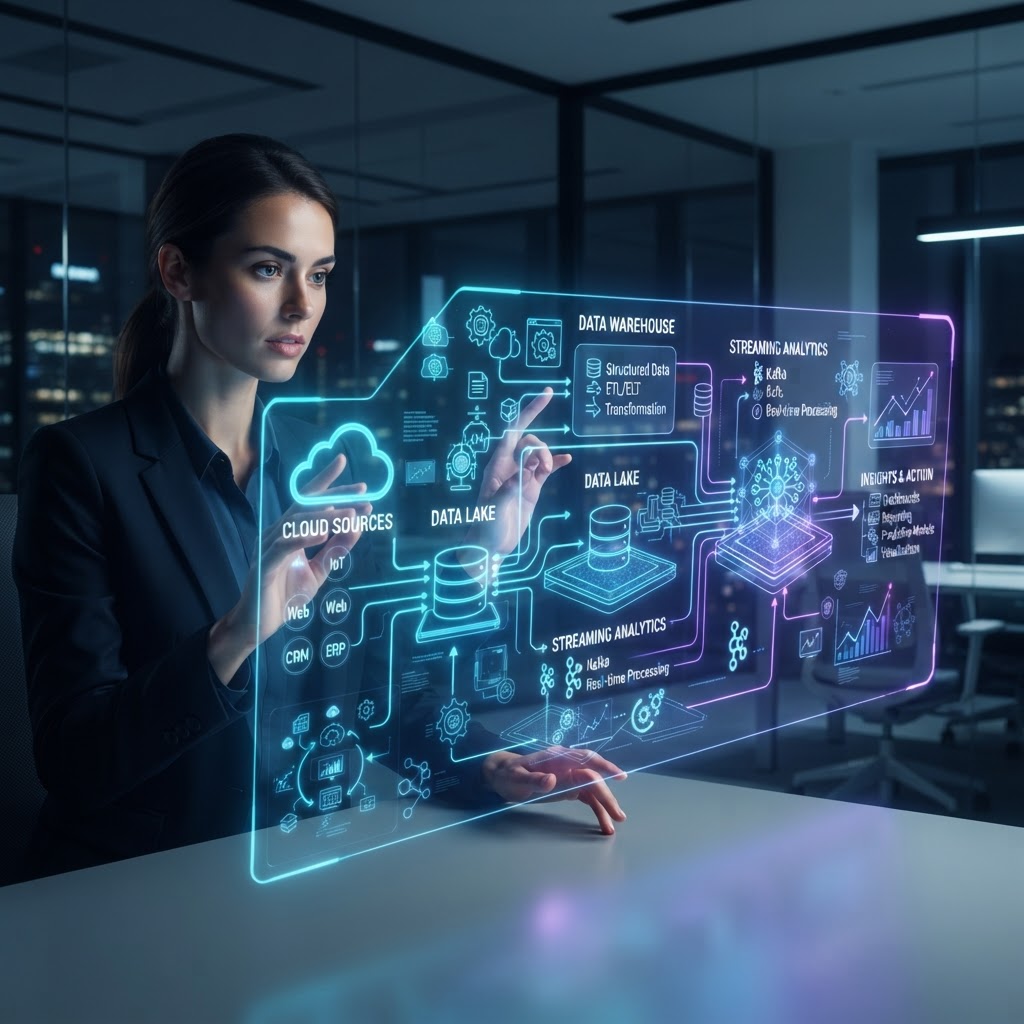
Als Software-Architekt habe ich Dutzende teure Attributions-Initiativen scheitern sehen – und der Grund war fast nie der Algorithmus selbst. Die Ursache lag nahezu immer in unzureichendem Data Engineering. Der Versuch, fortschrittliche KI-Modelle auf kaputte, fragmentierte CSV-Exporte loszulassen, ist der sichere Weg ins Verderben ('Garbage In, Garbage Out'). Um in einer KI-dominierten Welt echte Attribution zu betreiben, benötigen Sie zwingend eine moderne Cloud-Datenarchitektur. Alle Touchpoints aus CRM-Systemen (Salesforce, HubSpot), Web-Analytics, ERP und Ad-Plattformen müssen automatisiert über ETL-Pipelines in einem zentralen Data Warehouse (z.B. Google BigQuery, Snowflake) normalisiert und historisiert werden.
Ein Algorithmus, egal wie fortschrittlich, kann kaputte Data-Pipelines nicht heilen. Marketing-Attribution ist heute zu 80% ein hartes Data-Engineering-Problem und nur zu 20% Data Science. Die wahre Magie passiert in der Normalisierung der Rohdaten, nicht im Hyperparameter-Tuning.
In 4 Phasen zur KI-gestützten Attributions-Engine
- 1
Data Foundation: Aufbau eines Single Source of Truth im Cloud Data Warehouse. Etablierung täglicher ETL-Prozesse zur Aggregation von Spend-Daten, Impressions, Klicks und Offline-Conversions.
- 2
Identity Resolution: Einsatz einer Customer Data Platform (CDP) oder von deterministischen Graphen, um fragmentierte User-Profile anhand von First-Party-Data (Logins, E-Mails) geräteübergreifend zusammenzuführen.
- 3
Model Engineering: Entwicklung der hybriden Architektur. Implementierung von Multi-Touch-Attribution (MTA) für das taktische Tagesgeschäft und paralleles Aufsetzen eines bayesschen MMMs für strategische Quartalsentscheidungen.
- 4
Activation & Feedback Loop: Rückführung der modellierten Conversion-Wahrscheinlichkeiten (Predicted LTV) über APIs in die Bidding-Algorithmen von Google Ads und Meta, um die Smart-Bidding-Systeme mit korrigierten, wahrheitsgemäßen Werten zu steuern.
Prognose: Agentic AI und synthetische Daten (2025-2027)
Blicken wir 12 bis 36 Monate in die Zukunft, wird sich der Fokus der Marketing-Attribution von der reinen Vergangenheitsbewältigung hin zur hochdynamischen, prädiktiven Simulation verschieben. Synthetische Daten werden zur Norm: Da wir immer weniger echte User auf individuellem Level tracken dürfen, generieren Generative Adversarial Networks (GANs) auf Basis aggregierter Muster synthetische User-Journeys, an denen Modelle gefahrlos und DSGVO-konform trainiert werden können. Wir sehen bereits erste Proof-of-Concepts, in denen synthetische Kohorten das Training von Attributionsmodellen massiv beschleunigen und gleichzeitig den Privacy-By-Design-Standard erfüllen.
- Haben Sie eine ausgereifte Zero- und First-Party-Data-Strategie etabliert?
- Sind Ihre zentralen Marketing-Datenbanken bereit für Machine-Learning-Workloads?
- Evaluieren Sie bereits den Einsatz von Data Clean Rooms für den sicheren Datenaustausch?
- Führen Sie regelmäßig georeferenzierte Incrementality-Tests durch, um MMM-Modelle zu kalibrieren?
- Verfügt Ihr Team über ausreichende Data-Engineering-Ressourcen (nicht nur Analysten)?
Fazit: Die Triangulation ist der neue Goldstandard
Die harte Realität der modernen Marketing-Attribution lautet: Das eine allwissende, fehlerfreie Tracking-System gibt es nicht mehr – und wird es auch nie wieder geben. Wer das akzeptiert, verschafft sich einen massiven Wettbewerbsvorteil. Erfolgreiche Tech-CMOs und KI-Strategen setzen deshalb auf methodische Triangulation. Sie kombinieren die mikroskopische Sicht einer eingeschränkten, aber datengestützten Multi-Touch-Attribution mit der makroskopischen Vogelperspektive des bayesschen Marketing Mix Modelings und kalibrieren beide Systeme kontinuierlich durch harte, isolierte Inkrementalitätstests (A/B-Holdouts). Nur durch das algorithmische Übereinanderlegen dieser drei Perspektiven offenbart sich die wahre Wirksamkeit von Marketingbudgets in einer komplexen Welt.
FAQ: Deep Dive Marketing-Attribution & KI
Bereit für datengetriebene Gewissheit?
Verlieren Sie Budgets im Dunkelfeld archaischer Tracking-Methoden? Die Experten der AI-Software GmbH konzipieren und implementieren für Ihr Unternehmen hochmoderne, datenschutzkonforme Cloud-Architekturen und hybride Attributionsmodelle. Lassen Sie uns Ihren wahren Marketing-ROI entschlüsseln.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.