WebAssembly und Edge-AI: Komplexe KI-Modelle direkt im Browser ausführen
Der Paradigmenwechsel von der Cloud zur Edge ist in vollem Gange. Erfahren Sie, wie Sie mittels WebAssembly und WebGPU KI-Inferenz ohne Serverkosten und Latenz direkt beim Endnutzer realisieren.
Inhalt
Das Wichtigste in Kürze
- Zero-Latency Inferenz: Eliminierung von Netzwerk-Flaschenhälsen für Echtzeit-KI-Anwendungen.
- Kostenrevolution: Inferenzkosten werden auf die Client-Hardware verlagert, Serverkosten sinken drastisch.
- WebGPU-Synergie: Wasm orchestriert, WebGPU beschleunigt Matrixmultiplikationen über den lokalen Grafik-Chip.
- Privacy by Design: Keine Übertragung sensibler Daten an Backend-Server, 100% DSGVO-konform.
Die Ära der reinen Cloud-KI neigt sich dem Ende zu. Wenn jeder einzelne Token, jedes Audio-Sample und jeder Frame für die Verarbeitung an ein zentrales Backend geschickt werden muss, entstehen Systeme, die träge, teuer und in Bezug auf den Datenschutz höchst problematisch sind. Die Lösung liegt in der Edge: Mit der Reife von WebAssembly (Wasm) und modernen Browser-APIs verlagern wir hochkomplexe Inferenz-Workloads zurück dorthin, wo die Daten entstehen – auf das Endgerät des Nutzers.
Die Cloud-Falle: Warum Netzwerklatenz Ihre KI-Architektur zerstört
Seit Jahren bauen wir komplexe KI-Pipelines in der Cloud, nur um festzustellen, dass das ständige Hin- und Hersenden von Tensordaten über HTTP/REST-Schnittstellen oder WebSockets den eigentlichen Flaschenhals darstellt. Eine Round-Trip-Latenz von 200 Millisekunden mag für eine simple Textgenerierung akzeptabel sein, doch für Echtzeit-Audioverarbeitung, Computer Vision bei 60 FPS oder hochgradig interaktive UI-Assistenten ist sie ein absoluter Produktkiller. In der Praxis addieren sich Netzwerk-Jitter, TLS-Handshakes und Server-Warteschlangen zu Verzögerungen auf, die jegliche Illusion von 'Echtzeit' zerstören. Zudem skalieren die Cloud-Inferenzkosten bei starker Nutzung exponentiell, was die Unit-Economics vieler SaaS-Unternehmen buchstäblich ruiniert. Die Verlagerung der Inferenz auf die Edge – direkt in den Browser des Nutzers – löst dieses Problem radikal, vorausgesetzt, man versteht die zugrundeliegenden architektonischen Eigenheiten.
-80%
Reduktion der Inferenz-Latenz bei Echtzeit-Anwendungen
-95%
Einsparungspotenzial bei Cloud-Compute-Kosten
4x
Kompression durch asymmetrische INT8-Quantisierung
WebAssembly: Der unsichtbare Motor für Browser-Inferenz
Lassen Sie uns mit einem hartnäckigen Mythos aufräumen: WebAssembly (Wasm) ist nicht einfach nur ein 'schnelleres JavaScript', sondern ein binäres Kompilierungsziel, das eine nahezu native Ausführungsgeschwindigkeit im Browser ermöglicht. Für uns KI-Architekten bedeutet dies, dass wir in C++ oder Rust geschriebene Inferenz-Engines wie GGML oder das Kernsystem der ONNX Runtime hochperformant im Client laufen lassen können. Dabei profitieren wir von essenziellen Hardware-Features wie Wasm SIMD (Single Instruction, Multiple Data) für vektorisierte Matrixoperationen. Zudem ermöglicht Wasm in Kombination mit Web Workern und SharedArrayBuffer echtes Multithreading auf CPU-Ebene. Ohne diese tiefgreifende Thread-Kontrolle würde der Main-Thread des Browsers bei der ersten schweren Matrixmultiplikation blockieren und die User Experience (UX) völlig zerstören.
Der Durchbruch: WebGPU und die ONNX Runtime Web
Doch die wahre Revolution für Browser-KI ist die Synergie aus WebAssembly und der WebGPU-API. Während die ältere WebGL-Spezifikation historisch für grafisches Rendering konzipiert wurde und wir KI-Berechnungen extrem ineffizient über Pixel-Shader erzwingen mussten (sogenanntes GPGPU), bietet WebGPU dedizierte Compute-Shader, die nativen Zugriff auf die Architektur der lokalen Grafikkarte erlauben. Die ONNX Runtime Web nutzt dieses Setup meisterhaft: WebAssembly übernimmt die Orchestrierung, das komplexe Memory-Management und asymmetrische Fallbacks auf die CPU, während WebGPU die hochparallelen Matrixoperationen direkt auf der VRAM des Nutzers ausführt. In unseren internen Benchmarks bei der AI-Software GmbH sehen wir dadurch bei Transformer-Modellen enorme Performance-Steigerungen um den Faktor 10 bis 15 im Vergleich zum reinen Wasm-CPU-Backend.
Insider-Warnung: Memory Leaks bei Wasm-Tensoren
Vergessen Sie niemals, dass JavaScript den WebAssembly-Speicher nicht automatisch durch den Garbage Collector bereinigt! Wenn Sie in JS Tensoren allozieren und an Wasm übergeben, müssen Sie diese nach der Inferenz zwingend manuell per `tensor.dispose()` freigeben. Tun Sie dies nicht, wird der Browser-Tab bei kontinuierlicher Verarbeitung nach wenigen Sekunden unweigerlich mit einem OOM-Error (Out of Memory) abstürzen.
Post-Training Quantisierung: Der Kampf gegen die Payload
Der Elefant im Raum bei jeder Edge-AI-Strategie ist und bleibt die Payload-Größe. Ein Machine-Learning-Modell, das 500 Megabyte oder mehr auf die Waage bringt, wird beim initialen Seitenaufruf jeden Endnutzer vergraulen und die Bounce-Rate maximieren. Hier greift die Kunst der Post-Training-Quantisierung (PTQ). Durch hochoptimierte Verfahren werden die internen Gewichte des Modells von speicherintensiven 32-Bit-Fließkommazahlen (FP32) auf 8-Bit-Ganzzahlen (INT8) oder sogar auf noch kleinere 4-Bit-Formate reduziert. Durch asymmetrische dynamische Quantisierung lässt sich beispielsweise ein 100 MB großes BERT-Derivat auf gut 25 MB eindampfen – und das bei einem marginalen Genauigkeitsverlust (Accuracy Drop) von unter 1,2 Prozent. Man tauscht also ein kaum wahrnehmbares Maß an Präzision gegen eine vierfach schnellere Netzwerk-Ladezeit und einen signifikant reduzierten Speicherbedarf im RAM des Endgeräts.
- 1
Modell in PyTorch trainieren oder feintunen und auf minimalen Parameter-Footprint optimieren.
- 2
Architektur in das hardwareunabhängige ONNX-Format (Open Neural Network Exchange) exportieren.
- 3
Post-Training Quantisierung (PTQ) anwenden, um die Genauigkeit von FP32 auf INT8 zu reduzieren.
- 4
Integration in die JavaScript-Umgebung mittels 'onnxruntime-web' unter expliziter Angabe des WebGPU-Backends.
- 5
Offline-Caching via Service Worker und IndexedDB implementieren, um zukünftige Ladezeiten zu minimieren.
Die Zukunft der KI ist hybrid. Wir werden weiterhin massive Foundation-Modelle in der Cloud trainieren, aber die Inferenz wird sich rasend schnell an die Edge verlagern. WebAssembly ist die Brücke, die diese Entwicklung auf allen Plattformen ohne Vendor-Lock-in ermöglicht.
Professionelles Caching: Ladezeiten meisterhaft umgehen
Ein klassischer Anfängerfehler bei der Implementierung von Browser-KI ist das redundante Herunterladen der schweren Modellgewichte bei jedem einzelnen Session-Start. Dies frustriert Nutzer und treibt die CDN-Kosten des Betreibers massiv in die Höhe. Eine professionelle und ausgereifte Edge-Architektur nutzt zwingend die Browser-eigene IndexedDB in Kombination mit der Cache-API, um die quantisierten '.onnx' oder '.bin' Modell-Dateien persistent im lokalen Speicherbereich des Nutzers abzulegen. Ein intelligent konfigurierter Service Worker steuert im Hintergrund das Background-Fetching und prüft per ETag oder Hash-Abgleich, ob eine aktualisierte Version des Modells auf dem Server verfügbar ist. Erst diese Kombination aus sofortiger Offline-Verfügbarkeit und im Hintergrund laufenden, inkrementellen Updates macht eine Edge-AI-Applikation wirklich 'Production Ready' und absolut resilient gegenüber kurzzeitigen Netzwerkschwankungen.
Privacy by Design: Ein Segen für die DSGVO
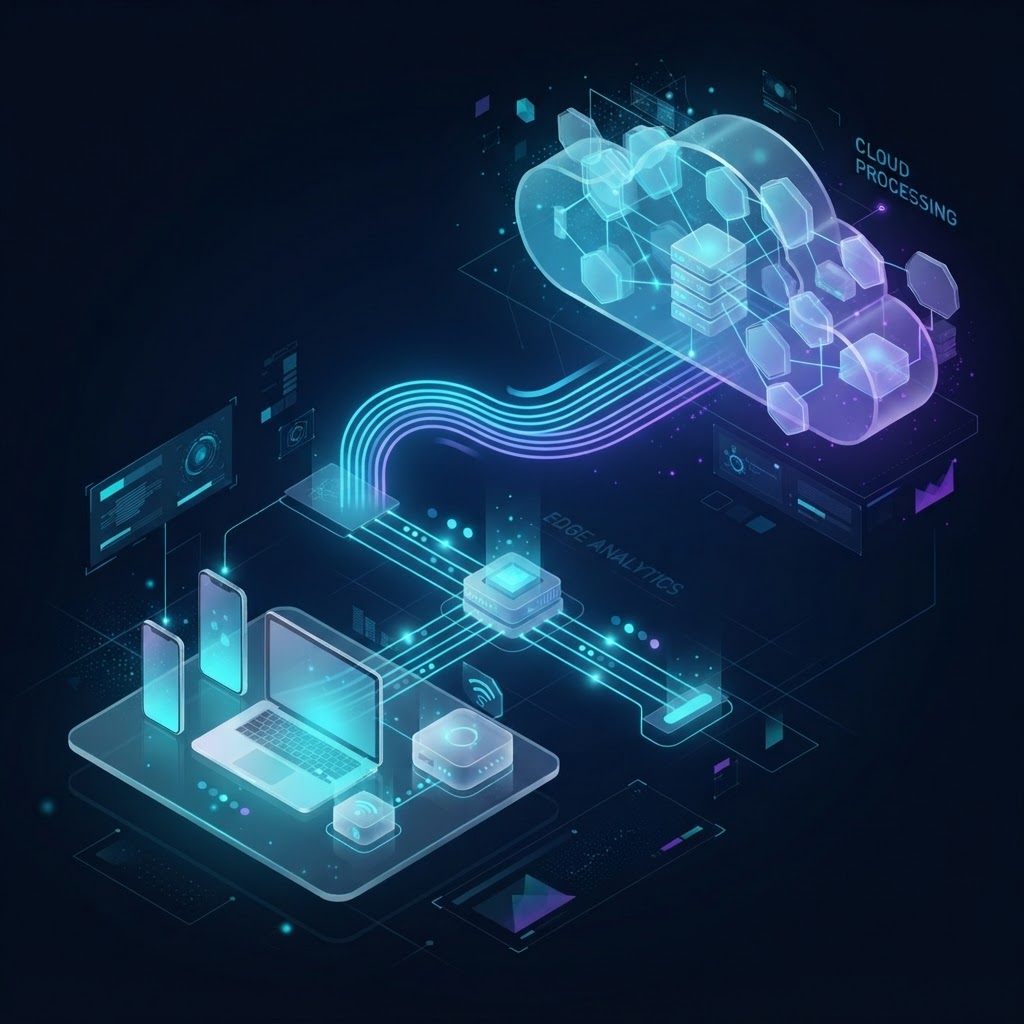
Abseits von den immensen Latenz- und Kostenvorteilen gibt es einen weiteren, hochgradig unterschätzten Treiber für WebAssembly in der angewandten KI: Data Privacy by Design. Sobald das Modell im lokalen Browser ausgeführt wird, verlassen die potenziell hochsensiblen Nutzdaten – seien es vertrauliche Finanzdokumente, biometrische Sensordaten, private Fotos oder intime Spracheingaben – das Endgerät niemals. Für uns als Architekten bei der AI-Software GmbH ist dies ein entscheidendes und unschlagbares Argument, wenn wir mit Enterprise-Kunden aus stark regulierten Sektoren wie Healthcare, Insurance oder Fintech sprechen. Die Einhaltung der europäischen Datenschutzgrundverordnung (DSGVO) wird nahezu trivialisiert, da faktisch gar keine Verarbeitung personenbezogener Daten auf fremden Drittanbieter-Servern stattfindet; die gesamte Inferenz ist hardware-isoliert, streng lokal und damit kryptografisch unbedenklich.
Die nackte Wahrheit: Vor- und Nachteile von Browser-KI
Vorteile
- Vollständiger Wegfall von Inferenz-Serverkosten (Zero-Cost Compute)
- Ultra-Low Latency, perfekt für 60FPS Computer Vision oder Realtime-Audio
- Absolute Datensicherheit und Out-of-the-Box DSGVO-Konformität
- Die Kern-KI-Funktionalität der Web-App bleibt auch komplett offline verfügbar
Nachteile
- Sehr große Initial-Payloads verzögern die Time-to-Interactive beim allerersten Seitenaufruf
- Leistung ist extrem abhängig von der Hardware und GPU des jeweiligen Endnutzers
- Erhöhtes Risiko für Model-Theft, da die Gewichte direkt an den Client übermittelt werden
- Strikte Wasm-Speicherlimits (aktuell 4GB Limitierung) begrenzen die maximale Modellgröße
Der Ausblick: WebNN und die Zukunft der Edge-Inferenz
Wenn wir 12 bis 36 Monate in die Zukunft blicken, wird die Web Neural Network API (WebNN) die technischen Spielregeln des Internets erneut grundlegend verändern. Während wir uns heute primär auf WebGPU und WebAssembly verlassen müssen, um Hardware-Beschleunigung mühsam zu abstrahieren, wird WebNN den nativen, direkten Zugriff auf dedizierte Neural Processing Units (NPUs) gewähren – wie etwa die Apple Neural Engine oder neueste Snapdragon NPUs. Diese spezialisierten Chips sind exakt auf Tensor-Operationen zugeschnitten, arbeiten um ein Vielfaches energieeffizienter als herkömmliche GPUs und schonen den Akku mobiler Geräte massiv. Wenn WebNN breite, standardisierte Browser-Unterstützung erhält, werden wir nicht nur kleine Klassifizierungsmodelle, sondern ausgewachsene, quantisierte Small Language Models (SLMs) mit Milliarden Parametern flüssig in einem einfachen Chrome-Tab laufen sehen.
Zusammenfassend lässt sich sagen, dass der strategische Shift zu Edge-AI durch WebAssembly weniger ein bloßes technisches Feature ist, sondern vielmehr eine tiefgreifende betriebswirtschaftliche Revolution darstellt. Unternehmen verlagern die rohen Compute-Kosten von ihrer eigenen teuren Cloud-Rechnung elegant auf die ohnehin vorhandene, brachliegende Hardware ihrer Nutzerschaft. Für SaaS-Anbieter bedeutet dieses Paradigma eine fast magische Entkopplung der KI-Inferenzkosten vom linearen Nutzerwachstum: Ob nun 100 oder 100.000 Nutzer gleichzeitig mit dem Modell interagieren, Ihre Server- und Backend-Kosten bleiben nahezu bei Null. Diese unendliche Skalierbarkeit, gepaart mit absoluter Privatsphäre und Echtzeit-Latenz, ist der exakte Grund, warum wir bei der AI-Software GmbH für zukunftssichere Projekte immer öfter zu rein WebAssembly-basierten Architektur-Patterns raten.
- ONNX-Modell zwingend asymmetrisch quantisieren (INT8), um Payload zu verringern.
- Web Workers für die Wasm-Ausführung nutzen, um den Main-Thread des Browsers nicht zu blockieren.
- IndexedDB-Caching-Strategie implementieren, um den Download bei wiederkehrenden Usern zu überspringen.
- WebGPU als Execution Provider priorisieren, mit robustem Wasm-CPU-Fallback für ältere Geräte.
- Tensor-Lifecycles im JavaScript-Code explizit managen, um fatale Memory-Leaks zu verhindern.
Bereit für KI ohne Latenz und Serverkosten?
Möchten Sie hochkomplexe KI-Modelle latenzfrei und ohne horrende Cloud-Kosten direkt in der Infrastruktur Ihrer Nutzer ausführen? Die Experten der AI-Software GmbH entwickeln für Sie maßgeschneiderte, extrem performante Edge-AI-Architekturen. Kontaktieren Sie uns noch heute für eine tiefe technische Evaluierung und heben Sie Ihr SaaS-Produkt auf das nächste Level!
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.