Automatisierte Testsuite-Generierung: Wie KI das Unit-Testing revolutioniert
KI-gestütztes Unit-Testing eliminiert manuellen Mehraufwand und hebt die Code-Qualität auf ein neues Level. Ein Deep-Dive in aktuelle LLM-Architekturen, Integrationen in die CI/CD-Pipeline und die autonome Zukunft der Quality Assurance.
Inhalt
Das Wichtigste in Kürze
- KI-Test-Generatoren wie CodiumAI oder Diffblue Cover reduzieren den manuellen Testaufwand in Enterprise-Projekten um bis zu 60 Prozent.
- Die Qualität der generierten Tests hängt extrem stark vom Context-Window und der implementierten RAG-Architektur für Dependency-Auflösungen ab.
- KI-gestütztes Mutation Testing verhindert die Entstehung von trügerischen Tautologie-Tests, bei denen das Modell lediglich die fehlerhafte Logik bestätigt.
- Bis 2026 werden 'Self-Healing Tests' der unangefochtene Industriestandard in modernen, autonomen CI/CD-Pipelines sein.
Jahrzehntelang war Unit-Testing das ungeliebte Stiefkind der agilen Softwareentwicklung, ein notwendiges Übel zwischen Feature-Deployment und Deadline-Druck. Doch mit dem rasanten Aufstieg großer Sprachmodelle (LLMs) und spezialisierter Coding-Agenten stehen wir vor einer architektonischen Zäsur, die den gesamten Quality-Assurance-Prozess auf den Kopf stellt. Entwickler mutieren von Test-Schreibern zu Reviewern hochkomplexer, KI-generierter Test-Suiten, die Edge-Cases abdecken, an die menschliche Prüfer niemals gedacht hätten. Dieser Paradigmenwechsel ist nicht nur eine Frage der Bequemlichkeit, sondern ein massiver wirtschaftlicher Hebel, der die Time-to-Market drastisch verkürzt und die Robustheit kritischer Systeme exponentiell steigert.
Das Ende des Boilerplate-Wahnsinns: Der unhaltbare Status Quo
Wer heute noch zulässt, dass Senior-Developer Stunden damit verbringen, manuell Standard-Mocks für simple CRUD-Operationen zu schreiben, verbrennt wissentlich massiv Unternehmenskapital. Entwickler verbringen laut diversen DevSecOps-Studien einen erheblichen Teil ihrer produktiven Arbeitszeit mit dem Schreiben und Warten von Testfällen, die oft nur absolute triviale Standardpfade abdecken. Diese rein manuelle Fleißarbeit ist nicht nur extrem kostenintensiv und frustrierend, sondern auch hochgradig fehleranfällig, da komplexe Edge-Cases aus kognitiver Ermüdung schlichtweg übersehen werden. Mit dem Siegeszug leistungsfähiger und code-optimierter LLMs wie Claude 3.5 Sonnet oder GPT-4o ändert sich diese gefährliche Dynamik in den Entwicklungsabteilungen gerade fundamental. Moderne Software-Teams verlagern ihren Fokus von der testgetriebenen Syntax-Produktion auf die übergeordnete architektonische Validierung und überlassen die harte Code-Generierung spezialisierten KI-Systemen.
~40%
der produktiven Entwicklungszeit fließt historisch betrachtet in das Schreiben und Warten von Tests
< 3s
Dauer pro KI-generiertem, voll funktionsfähigem Test-Case inklusive Dependency-Mocking
50-85%
durchschnittlicher Anstieg der Code-Coverage innerhalb der ersten Wochen nach KI-Integration
Die Evolution der Test-Agenten: Von AST-Parsing zu generativer KI
Klassische Test-Generatoren wie EvoSuite basierten historisch auf reinen Abstract Syntax Trees (AST) und heuristischen Suchalgorithmen, die zwar syntaktisch fehlerfreie, aber oft semantisch völlig bedeutungslose Tests erzeugten. Heute übernehmen generative Grundlagenmodelle oder spezialisierte Code-Modelle wie StarCoder2-15B diese Aufgabe auf einem gänzlich anderen, kognitiven Niveau. Sie verstehen nicht nur die nackte Syntax der Zielsprache, sondern analysieren den fachlichen Kontext, die Intention des Entwicklers aus den Docstrings und die impliziten Geschäftsregeln im Code. Dieser gewaltige Paradigmenwechsel verwandelt Test-Generierung von einer reinen Code-Abdeckungssimulation hin zu einem echten, wertschöpfenden Behavior-Testing. Entwickler orchestrieren nun KI-Agenten, die selbstständig komplexe Randbedingungen identifizieren, Abhängigkeiten erkennen und die passenden Mocks direkt und syntaktisch einwandfrei mitgenerieren.
Context is King: Die Macht von RAG in der Testgenerierung
Ein LLM ist bei der Generierung von Tests exakt nur so gut wie der technische Kontext, der ihm während der Inferenz zur Verfügung gestellt wird. Die einfache Übergabe einer isolierten Funktionsdatei führt fast zwangsläufig zu halluzinierten Imports oder falschen Annahmen über globale State-Objekte, da das Modell die umliegende Projektstruktur nicht kennt. Aus diesem Grund setzen führende Tools auf Retrieval-Augmented Generation (RAG), bei der AST-Parser im Vorfeld alle relevanten Abhängigkeiten, Interfaces und Typendefinitionen aus dem Repository extrahieren und in einer Vektordatenbank indizieren. Wenn die KI nun einen Test für eine bestimmte Service-Klasse schreibt, ruft sie vollautomatisch die exakten Signaturen der injizierten Repositories ab und generiert hochpräzise, kompilierbare Mocks. Nur durch diese tiefgreifende Kontext-Anreicherung verwandelt sich ein generischer Code-Vorschlag in eine direkt lauffähige und wertvolle Test-Suite.
Vorsicht vor der Halluzinations- und Tautologie-Falle
Die größte Gefahr bei unzureichendem Kontext ist die sogenannte Tautologie-Falle. Wenn das Modell nur den fertigen Quellcode ohne Schnittstellen-Dokumentation sieht, schreibt es Tests, die exakt das fehlerhafte Verhalten des Codes bestätigen. Der Test wird grün, obwohl die Geschäftslogik fundamental falsch ist. Wir nennen das bei der AI-Software GmbH 'Quality Theater'.
Architektur-Blueprint: KI tief in die CI/CD-Pipeline integrieren
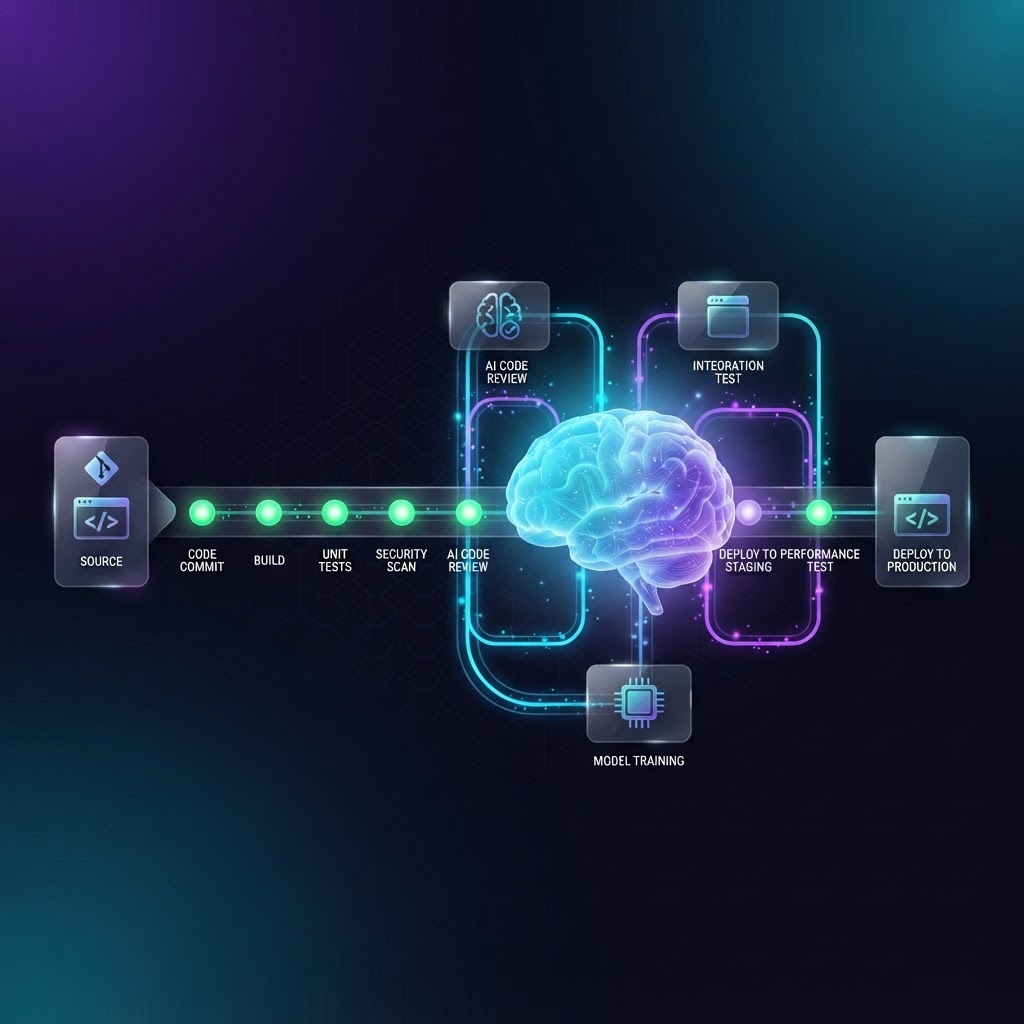
Lokale IDE-Plugins wie GitHub Copilot oder JetBrains AI Assistant sind fantastische Produktivitäts-Booster für den individuellen Entwickler, aber sie lösen das Qualitätsproblem nicht auf architektonischer Team-Ebene. Für eine echte Transformation muss die Test-Generierung als obligatorischer, autonomer Schritt fest in die CI/CD-Pipeline, beispielsweise in GitHub Actions oder GitLab CI, integriert werden. Wir sprechen hier von einem echten Shift-Left-Ansatz, bei dem ein KI-Agent jeden neuen Pull Request abfängt, die diff-Dateien analysiert und völlig autark fehlende Testabdeckungen berechnet. Anschließend schreibt die KI die fehlenden Tests in einer isolierten Sandbox, führt sie iterativ aus und korrigiert auftretende Kompilier- oder Laufzeitfehler selbstständig durch eine interne Feedback-Schleife. Erst wenn der generierte Test fehlerfrei durchläuft und die Coverage-Ziele erfüllt, wird er dem menschlichen Entwickler als fertiger Code-Vorschlag in den Pull Request gepusht.
- 1
Webhook-Trigger: Die Pipeline wird beim Öffnen eines Pull Requests ausgelöst und isoliert die veränderten Codezeilen.
- 2
Context Aggregation: Ein AST-Parser sammelt alle relevanten Abhängigkeiten, Interfaces und die bestehende Testsuite als RAG-Kontext.
- 3
LLM Inference Loop: Das Sprachmodell generiert erste Test-Kandidaten, inklusive Mocks und Assertions basierend auf den Business-Anforderungen.
- 4
Sandbox Execution & Self-Correction: Die Tests werden automatisiert ausgeführt. Bei Fehlschlägen liest das Modell den Stacktrace und passt den Test-Code iterativ an.
- 5
Automated Commit: Die fertige, verifizierte Testdatei wird als separater Commit oder Kommentar direkt in den Pull Request des Entwicklers injiziert.
ROI und Business Impact: Eine ehrliche Gegenüberstellung
Die wirtschaftliche Betrachtung der automatisierten Testsuite-Generierung geht weit über die reinen Lizenzkosten für KI-Tools oder API-Aufrufe hinaus. Einerseits sinken die Initialkosten für das Aufsetzen der Quality-Gates dramatisch, da tausende Zeilen Boilerplate-Code innerhalb von Minuten generiert werden. Andererseits verlagert sich der Aufwand extrem in Richtung Code-Review und langfristiger Wartbarkeit, denn KI-generierter Code neigt manchmal zu überkomplexen Assertions, die schwer zu lesen sind. Wenn Teams nicht rigoros auf Clean-Code-Prinzipien auch im Test-Code pochen, entsteht schnell eine unübersichtliche Legacy-Test-Codebase, die bei jedem kleinen Refactoring vollständig zerbricht. Der wahre Return on Investment stellt sich nur dann ein, wenn die generierten Tests deterministisch, leichtgewichtig und strikt an das erwartete Systemverhalten statt an die exakte Implementierung gekoppelt sind.
Vorteile
- Massive Zeitersparnis bei der Erstellung von Standard-Tests und Mocks
- Zuverlässige Aufdeckung von Edge-Cases durch unvoreingenommene LLM-Analysen
- Deutliche Erhöhung der Code-Coverage ohne zusätzlichen Personalaufwand
- Reduktion kognitiver Ermüdung im Entwickler-Team bei monotonen QA-Aufgaben
Nachteile
- Gefahr von False-Positives und tautologischen Tests ohne echtes Quality-Gate
- Erhöhter Review-Aufwand für komplexe KI-generierte Code-Strukturen
- Mögliche Flakiness der Tests bei inkonsistenten oder veralteten Context-Prompts
- Initiale Einrichtungs- und Integrationskosten für die CI/CD-Architektur
Ein KI-generierter Test ist nur dann wertvoll, wenn er auch deterministisch und begründet fehlschlägt. Generiert das Modell lediglich endlose Zeilen Code, die die fehlerhafte Implementierung blind absegnen, haben wir kein Quality-Gate etabliert, sondern lediglich ein kostspieliges, technologisches Theaterstück inszeniert.
Fallstricke & Insider-Best-Practices aus echten Enterprise-Projekten
In unseren zahlreichen Enterprise-Projekten bei der AI-Software GmbH haben wir gelernt, dass eine unreflektierte 'One-Click-Generierung' kompletter Repositories unweigerlich in einer Wartungskatastrophe endet. Der größte Fehler, den Teams machen können, ist die blinde Generierung von Tests für reine Datenstrukturen, Getter/Setter oder irrelevante Framework-Boilerplates, nur um künstlich die Coverage-Metrik in den Management-Dashboards nach oben zu treiben. Stattdessen muss die KI mit chirurgischer Präzision auf die eigentliche Domänenlogik und die komplexen State-Machines angesetzt werden. Wir implementieren dafür in der Regel strikte Prompt-Guidelines, die das Modell zwingen, zuerst einen Test-Plan in natürlicher Sprache auszugeben, bevor auch nur eine einzige Zeile Code generiert wird. Dieser Chain-of-Thought-Ansatz verbessert die architektonische Qualität und Nachvollziehbarkeit der resultierenden Tests absolut messbar.
- Behavior-Driven Prompting: Zwingen Sie die KI, Tests auf Basis von Requirements und nicht auf Basis der Implementierung zu schreiben.
- Strikte Sandbox-Ausführung: Kein KI-Test darf jemals ungeprüft in den Main-Branch, ohne vorher in einer isolierten Docker-Umgebung grün zu laufen.
- Fokus auf Domänenlogik: Schließen Sie irrelevante Framework-Dateien und reine DTOs konsequent aus dem RAG-Kontext der Testgenerierung aus.
- Kontinuierliches Prompt-Refining: Behandeln Sie die Prompts für Ihre CI-Agenten wie produktiven Quellcode und versionieren Sie diese im Repository.
Einer der am meisten unterschätzten Aspekte beim Einsatz von LLMs für die Testgenerierung ist die zwingende Kombination mit Mutation Testing, beispielsweise über Tools wie Stryker oder Pitest. Da Sprachmodelle dazu neigen, Plausibilitätsillusionen zu erschaffen, müssen wir das System absichtlich sabotieren, um die Güte der Tests zu validieren. Beim Mutation Testing werden kleine Fehler absichtlich in den Quellcode injiziert, um zu prüfen, ob die KI-generierten Tests daraufhin auch tatsächlich fehlschlagen und Alarm schlagen. Wenn ein KI-Test eine solche Mutante 'überleben' lässt, wissen wir sofort, dass der Testwert gleich null ist. Diese harte, maschinelle Gegenprüfung ist das einzige zuverlässige Mittel, um langfristiges Vertrauen in autonome QA-Pipelines aufzubauen und Regressionen konsequent zu verhindern.
Prognose 2025-2027: Autonomous QA und Self-Healing Code
Blicken wir in die nahe Zukunft der nächsten 12 bis 36 Monate, wird die reine Testsuite-Generierung lediglich als rudimentärer Zwischenschritt auf dem Weg zur vollautonomen Software-Wartung gelten. Der kommende Industriestandard wird 'Self-Healing Code' sein, ein Konzept, bei dem die Grenzen zwischen Entwicklung, Testing und Operations vollständig verschmelzen. Wenn künftig ein Test in der CI-Pipeline durch eine Code-Änderung fehlschlägt, bricht der Build nicht einfach ab und erzeugt ein Ticket für einen Entwickler. Stattdessen wird ein spezialisierter Agent sofort den Stacktrace analysieren, die Differenz zwischen erwartetem und tatsächlichem Verhalten evaluieren und entweder den fehlerhaften Feature-Code reparieren oder den veralteten Test an die neuen Anforderungen anpassen. Der menschliche Eingriff beschränkt sich dann lediglich auf das semantische Approval der vorgeschlagenen Konfliktlösung.
Der wahre Durchbruch für Enterprise-Architekturen wird die Kombination aus autonomen Software-Agenten wie Devin und spezialisierten, lokal gehosteten Small Language Models (SLMs) für hochsensible Codebases sein. Diese Agenten werden nicht nur isolierte Unit-Tests schreiben, sondern komplexe End-to-End-Tests (E2E) über Playwright oder Cypress orchestrieren, die gesamte Datenbank-States simulieren und visuelle Regressionen erkennen können. Unternehmen, die jetzt nicht beginnen, ihre Pipelines für diese Art der maschinellen Interaktion vorzubereiten und die entsprechenden RAG-Infrastrukturen aufzubauen, werden mittelfristig schlichtweg nicht mehr konkurrenzfähig sein. Die AI-Software GmbH bereitet ihre Kunden heute schon darauf vor, diesen unvermeidlichen Wandel nicht nur zu begleiten, sondern als technologischen Hebel zur Marktführerschaft aktiv zu nutzen.
Häufig gestellte Fragen (FAQ)
Integrieren Sie autonome KI-Qualitätssicherung in Ihr Projekt!
Sind Sie bereit, Ihre QA-Prozesse zu revolutionieren und die Time-to-Market Ihrer Software drastisch zu verkürzen? Die Experten der AI-Software GmbH analysieren Ihre aktuelle CI/CD-Pipeline und integrieren maßgeschneiderte, KI-gestützte Test-Agenten direkt in Ihre Entwicklungsabläufe. Kontaktieren Sie uns noch heute für ein unverbindliches Architektur-Audit.
Projekt startenTäglich KI-News per Mail
Erhalte jeden Tag den neuesten Blogbeitrag und die wichtigsten KI-Trends direkt in dein Postfach.
Double-Opt-In. Abmeldung jederzeit über den Link in jeder Mail.